Содержание
- Что такое GPT-Neo и кому она подходит
- Как пользоваться GPT-Neo: запуск на своей машине
- Какой чекпоинт GPT-Neo выбрать: 125M, 1.3B или 2.7B
- Границы GPT-Neo: что модель делать не станет
- Telegram-бот на GPT-Neo: подготовка
- Рабочий код Telegram-бота на GPT-Neo
- Чем заменить GPT-Neo под другие задачи
- Частые ошибки при работе с GPT-Neo
- Короткий чек-лист запуска
- Частые вопросы о GPT-Neo
Поговорим с Искусственным Интеллектом: создание Telegram-бота на основе GPT

Черновик готовит редакция с помощью ИИ. За стандарт издания отвечает главный редактор — Валерий Курземнек.
GPT-Neo — открытая языковая модель EleutherAI, и пользоваться ей можно без регистрации, ключей и оплаты. Как пользоваться: поставить библиотеку transformers, собрать конвейер text-generation с чекпоинтом EleutherAI/gpt-neo-1.3B и передать модели текст на английском — она его продолжит. Веса скачиваются при первом запуске: от 0,53 ГБ у версии 125M до 10,67 ГБ у 2.7B. Лицензия MIT, работает офлайн на своей машине.
- Три размера чекпоинтов: 125M, 1.3B и 2.7B параметров. Разница в объёме памяти и качестве продолжения.
- Язык обучения — английский. В карточке модели на Hugging Face стоит тег language: en.
- Это базовая модель-продолжатель текста: инструкции и диалог она не поддерживает, ответ строится как дописывание вашего промпта.
- Код самой EleutherAI заморожен с августа 2021 года, но веса живут на Hugging Face и работают в актуальных версиях transformers.
- Telegram-бот на GPT-Neo собирается за один вечер, только код образца 2023 года на нынешней библиотеке уже не запустится — ниже разобрано почему.
Что такое GPT-Neo и кому она подходит
GPT-Neo — семейство моделей от исследовательской группы EleutherAI, повторяющее архитектуру GPT-3. В документации Transformers она описана так: «GPT-Neo is an open-source alternative to GPT-2 and GPT-3 models, built with Mesh TensorFlow for TPUs». Обучали её на датасете the Pile — сборке из 22 более мелких качественных датасетов.
Цифра в названии чекпоинта — это число параметров. GPT-Neo 1.3B прошла 380 миллиардов токенов за 362 000 шагов обучения, GPT-Neo 2.7B — 420 миллиардов токенов за 400 000 шагов. Обе выложены под лицензией MIT, то есть их можно встраивать в коммерческие продукты.
Ради честности: сам репозиторий EleutherAI/gpt-neo заморожен. В его README прямым текстом стоит «As of August, 2021 code is no longer maintained» и рекомендация: «If you’re just here to play with our pre-trained models, we strongly recommend you try out the HuggingFace Transformer integration». Разработку команда перенесла в GPT-NeoX — репозиторий под GPU. Веса же продолжают жить на Hugging Face и поддерживаются актуальными версиями transformers, поэтому пользоваться моделью сегодня надо именно через них.
Кому она подходит: тем, кому нужен генератор английского текста, который крутится на собственном железе, не отправляет данные наружу и ничего не стоит за токены. Кому не подходит: тем, кому нужен русский язык или диалоговый ассистент, — для этих задач берут другие модели, например Гигачат от Сбера.
Вывод раздела: GPT-Neo — это открытая база 2021 года, зрелая и предсказуемая, с понятной ценой владения — стоимостью своего железа.
Как пользоваться GPT-Neo: запуск на своей машине
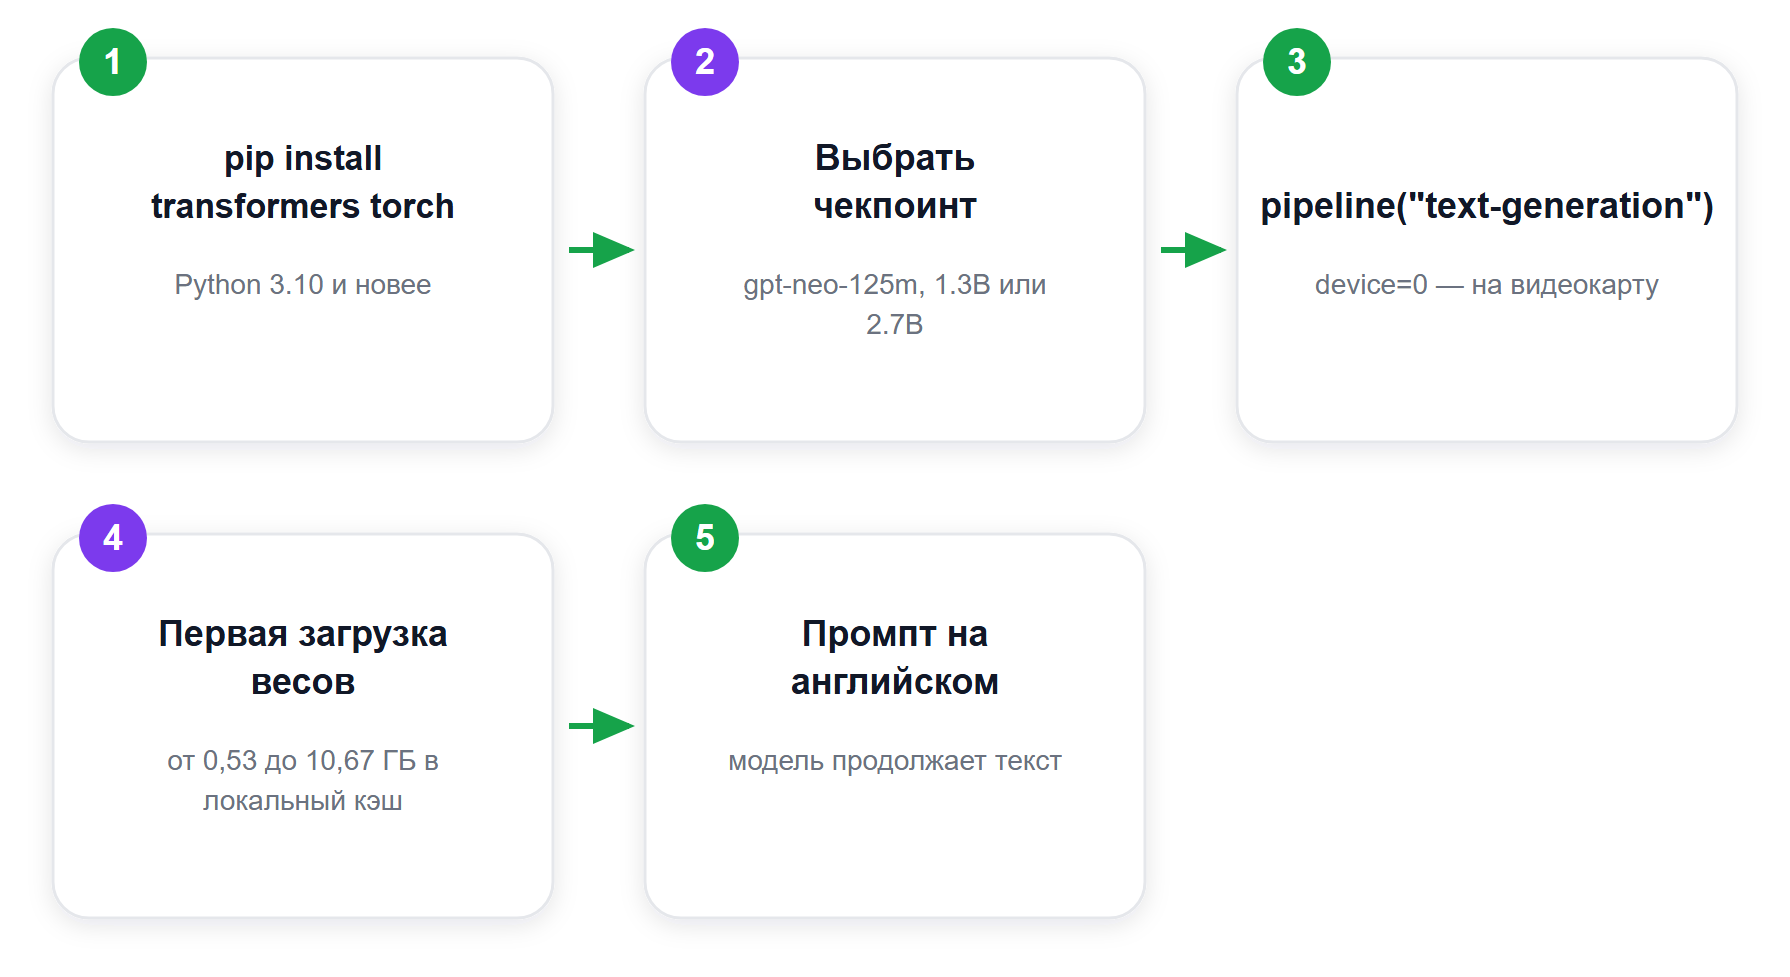
Весь путь до первого ответа модели — пять шагов.
- Проверьте Python. Актуальный transformers 5.15.1 требует Python 3.10 и выше (данные страницы пакета на PyPI на 25.08.2026).
- Поставьте библиотеки. Одной командой:
pip install transformers torch. - Выберите чекпоинт. Все оригинальные веса лежат в организации EleutherAI на Hugging Face: gpt-neo-125m, gpt-neo-1.3B, gpt-neo-2.7B.
- Запустите конвейер. Первый запуск скачает веса в локальный кэш, дальше модель поднимается уже с диска.
- Дайте промпт на английском. Модель продолжит вашу фразу.
Минимальный рабочий пример из документации Transformers:
from transformers import pipeline

generator = pipeline(task="text-generation", model="EleutherAI/gpt-neo-1.3B", device=0)
print(generator("EleutherAI has", do_sample=True, min_length=50))
Параметр device=0 отправляет модель на первую видеокарту; если запускаете на процессоре, его нужно убрать. Аргументы do_sample=True и min_length=50 взяты из карточки модели на Hugging Face — они включают случайную выборку и задают минимальную длину продолжения.
Версия 2.7B в float32 занимает 10,67 ГБ, и в видеокарту на 8 ГБ целиком уже не помещается. Для такого случая в документации Transformers приведён пример загрузки в 4 битах через bitsandbytes: конфиг BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_quant_type="nf4", bnb_4bit_compute_dtype="float16") передаётся в from_pretrained вместе с device_map="auto".
Отдельная строка из раздела Notes той же документации: «Pad inputs on the right because GPT-Neo uses absolute position embeddings». При пакетной обработке паддинг ставится справа, иначе позиции токенов поедут и качество продолжения упадёт.
Вывод раздела: рабочий запуск GPT-Neo — это две строки кода и одна долгая закачка весов.
Какой чекпоинт GPT-Neo выбрать: 125M, 1.3B или 2.7B
Выбор упирается в память. Файл весов грузится в неё целиком, так что размер файла — это нижняя граница требований к видеокарте или оперативке.
| Чекпоинт | Файл model.safetensors | Обучение | Точность на Lambada | Скачиваний за 30 дней |
|---|---|---|---|---|
| gpt-neo-125m | 0,53 ГБ | 300 млрд токенов, 572 300 шагов | 37,36 % | 505 526 |
| gpt-neo-1.3B | 5,31 ГБ | 380 млрд токенов, 362 000 шагов | 57,23 % | 44 050 |
| gpt-neo-2.7B | 10,67 ГБ | 420 млрд токенов, 400 000 шагов | 62,22 % | 21 878 |
Размеры файлов и число скачиваний — из API Hugging Face на 25.08.2026, цифры обучения — из карточек моделей, точность на Lambada — из таблицы оценок в README EleutherAI. Для сравнения там же указана GPT-3 2.7B с результатом 67,1 % — открытая модель того же размера отстаёт от закрытой примерно на пять пунктов.
Как читать таблицу на практике:
- 125M — версия для проверки кода. Запускается на процессоре ноутбука, по качеству отстаёт заметно: 37,36 % против 57,23 % у 1.3B на том же тесте. Её скачивают в одиннадцать раз чаще, чем 1.3B, именно потому, что на ней отлаживают пайплайны.
- 1.3B — компромисс. Файл весов 5,31 ГБ оставляет запас на карте с 8 ГБ памяти, качество продолжения уже осмысленное. Это версия по умолчанию для экспериментов.
- 2.7B — максимум семейства. В float32 файл весов занимает около 10 ГБ, поэтому на любительском железе его запускают через квантизацию.
Вывод раздела: начинайте с 125M ради отладки, переезжайте на 1.3B ради результата, 2.7B берите только под квантизацию или серверную карту.
Границы GPT-Neo: что модель делать не станет
Половина разочарований от GPT-Neo растёт из ожидания чата в стиле ChatGPT. Модель устроена иначе, и её карточка на Hugging Face говорит об этом прямо.
Только английский
В метаданных всех трёх чекпоинтов стоит language: en, а описание задачи звучит как «the model learns an inner representation of the English language». Русский промпт модель проглотит и выдаст на него ломаный ответ: русского текста в обучении почти не было. Просить у GPT-Neo русскую статью бессмысленно.
Продолжение текста вместо ответа на вопрос
Формулировка из карточки: «its core functionality is taking a string of text and predicting the next token». Инструкции модель не исполняет, системного промпта у неё нет, шаблона диалога тоже. Единственный рычаг управления — сам текст затравки. Работает приём few-shot: вы даёте два-три примера пар «вопрос — ответ» прямо в промпте, и модель продолжает шаблон.
Фильтрация вывода на вашей стороне
Датасет the Pile авторы описывают как «a dataset known to contain profanity, lewd, and otherwise abrasive language», а дальше идёт предупреждение: «Depending on your usecase GPT-Neo may produce socially unacceptable text». Рекомендация авторов дословная: «We recommend having a human curate or filter the outputs before releasing them». Для публичного Telegram-бота это означает обязательный фильтр перед отправкой сообщения пользователю.
Знания образца 2021 года
Веса 1.3B и 2.7B опубликованы в марте 2021 года — в README это помечено строкой «Update 21/03/2021», а в августе того же года код перевели в архивный режим. О событиях последних лет модель не знает ничего, и дообучение этого не исправит без своего датасета.
Вывод раздела: GPT-Neo — генератор английского текста для задач, где важны локальность и нулевая цена запроса. Ждать от неё ассистента бесполезно.
Telegram-бот на GPT-Neo: подготовка
Схема бота простая: Telegram присылает текст сообщения, скрипт передаёт его в конвейер GPT-Neo, ответ уходит обратно в чат. Начинается всё с токена.
Откройте в Telegram поиск, найдите @BotFather, отправьте команду /newbot и придумайте имя. В ответ придёт строка токена — её нужно сохранить.

Дальше ставим библиотеку. Актуальная версия python-telegram-bot — 22.8, вышла 12 июня 2026 года и требует Python 3.10 или новее (карточка пакета на PyPI, данные на 25.08.2026).

Почему код из старых инструкций больше не запускается
Гайды 2021–2023 годов написаны под python-telegram-bot 13-й ветки. В двадцатой версии библиотеку переписали на asyncio, и три вещи из тех инструкций перестали существовать.
Filtersс большой буквы. В руководстве по переходу сказано: «telegram.ext.Filters no longer exists. Instead, use the module telegram.ext.filters directly. For example, Filters.text has to be replaced by filters.TEXT».Updaterкак точка входа. Оттуда же: «ext.Updater is no longer the entry point to a PTB program and we have replaced the ext.Dispatcher class with the new class ext.Application». За обновления теперь отвечаетApplication.builder().token(...).build().- Синхронные обработчики. Функции-хендлеры стали корутинами:
async defиawaitобязательны.
Строка Updater(token='YOUR_TOKEN', use_context=True) на версии 22.8 упадёт с ошибкой. Ниже — код, который работает.
Рабочий код Telegram-бота на GPT-Neo
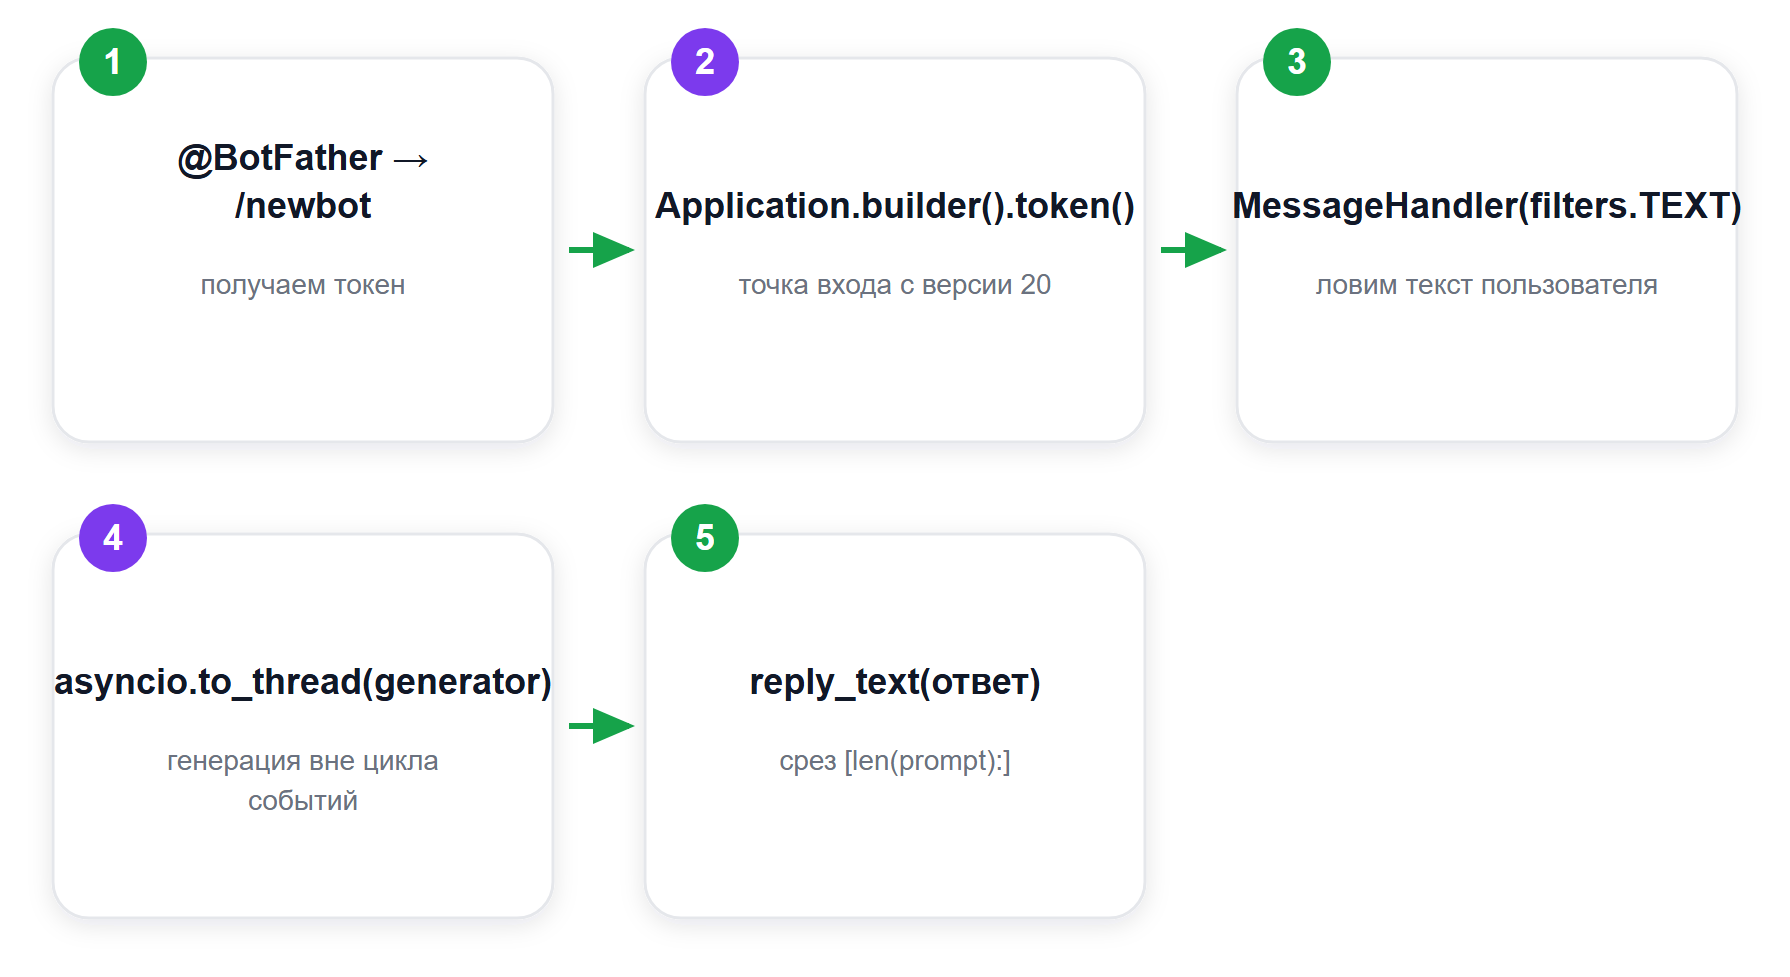
Скрипт целиком. Структура повторяет официальный пример echobot из репозитория python-telegram-bot, генерация добавлена в обработчик.
import asyncio

from transformers import pipeline
from telegram import Update
from telegram.ext import Application, ContextTypes, MessageHandler, filters

TOKEN = "ВАШ_ТОКЕН_ОТ_BOTFATHER"

# модель поднимается один раз при старте процесса
generator = pipeline(task="text-generation", model="EleutherAI/gpt-neo-1.3B", device=0)


async def reply(update: Update, context: ContextTypes.DEFAULT_TYPE) -> None:
    prompt = update.message.text
    result = await asyncio.to_thread(
        generator, prompt, max_new_tokens=60, do_sample=True, temperature=0.7
    )
    text = result[0]["generated_text"][len(prompt):].strip()
    await update.message.reply_text(text or "Модель ничего не добавила, попробуйте другой запрос")


def main() -> None:
    application = Application.builder().token(TOKEN).build()
    application.add_handler(MessageHandler(filters.TEXT & ~filters.COMMAND, reply))
    application.run_polling(allowed_updates=Update.ALL_TYPES)


if __name__ == "__main__":
    main()
Четыре места, где такой бот обычно ломается.
- Загрузка модели внутри обработчика. Тогда каждое сообщение поднимает 5,31 ГБ весов заново. Строка
generator = pipeline(...)живёт на уровне модуля. - Блокировка цикла событий. Генерация синхронная и занимает секунды, поэтому её выносят в
asyncio.to_thread: пока считается один ответ, бот принимает остальные сообщения. - Параметр длины.
max_new_tokensзадаёт длину именно продолжения, аmax_lengthиз старых примеров считает промпт вместе с ответом — на длинном вопросе места под ответ не остаётся. - Промпт в ответе. Конвейер возвращает исходный текст вместе с продолжением: в примере карточки модели затравка «EleutherAI has» приходит внутри строки «EleutherAI has made a commitment…». Срез
[len(prompt):]оставляет только новое.
Полный разбор всех атрибутов и хендлеров лежит в руководстве по переходу на 20-ю версию. Если нужен бот попроще, без нейросети, посмотрите разбор телеграм-бота с прогнозом погоды — там та же схема с внешним API вместо модели.
Вывод раздела: рабочий бот на GPT-Neo — это тридцать строк, из которых половина отвечает за аккуратную работу с памятью и потоками.
Чем заменить GPT-Neo под другие задачи
GPT-Neo закрывает узкую нишу: локальная генерация английского текста без оплаты за токены. За её пределами разумнее взять другой инструмент.
- Нужен русский язык. Смотрите в сторону моделей, обученных на русском корпусе, — например, в отдельном разборе нейросети DeepSeek.
- Нужен диалог и выполнение инструкций. Базовая модель-продолжатель для этого не годится, берите instruct-версию любой современной модели.
- Нужно обучать своё на GPU. EleutherAI сама указала преемника: «This repository will be (mostly) archived as we move focus to our GPU-specific repo, GPT-NeoX».
- Нужен готовый чат-бот без кода. Тогда логичнее собрать сценарий на конструкторе — примеры в подборке необычных чат-ботов с искусственным интеллектом.
Частые ошибки при работе с GPT-Neo
| Симптом | Причина | Что делать |
|---|---|---|
| CUDA out of memory | Файл весов 2.7B — 10,67 ГБ, он не влезает в видеопамять | Взять 1.3B или загрузить 2.7B в 4 битах через bitsandbytes |
| Первый запуск долго висит без вывода | Скачивание весов с Hugging Face | Дождаться один раз: дальше модель поднимается из локального кэша |
| Ответ на русском бессмысленный | В карточке модели указан язык en | Писать промпт по-английски |
| ImportError на имени Filters | Код написан под python-telegram-bot 13 | Импортировать модуль filters и брать константы вида filters.TEXT |
| Бот молчит, пока считает ответ | Генерация блокирует цикл событий | Вызывать конвейер через asyncio.to_thread |
| Модель повторяет вопрос | Конвейер возвращает промпт вместе с продолжением | Отрезать первые len(prompt) символов |
Вывод раздела: пять ошибок из шести лечатся заменой одной строки, и только память требует выбора между младшим чекпоинтом и квантизацией.
Короткий чек-лист запуска
- Python 3.10 или новее,
pip install transformers torch. - Чекпоинт под своё железо: 125M для отладки, 1.3B для работы, 2.7B под квантизацию.
- Промпт на английском, управление через few-shot примеры внутри затравки.
- Для бота: токен от @BotFather, python-telegram-bot 22.8, модель поднимается один раз на старте.
- Генерация уходит в
asyncio.to_thread, ответ обрезается срезом[len(prompt):]. - Фильтр вывода перед отправкой пользователю — требование самих авторов модели.
Также рекомендуем Вам курс “Нейросети: от принципов к практике”, где мы научим вас оптимизировать рутинные и сложные задачи с помощью нейросетей.
Частые вопросы о GPT-Neo
Нужен ли ключ API, чтобы пользоваться GPT-Neo?
Нет. Веса открыты по лицензии MIT и скачиваются с Hugging Face библиотекой transformers. Модель считает на вашем железе, платить за запросы не нужно.
Какой чекпоинт GPT-Neo выбрать новичку?
Для отладки кода подойдёт gpt-neo-125m с файлом весов 0,53 ГБ. Для осмысленного текста берут gpt-neo-1.3B, его файл занимает 5,31 ГБ. Версия 2.7B весит 10,67 ГБ и на любительской видеокарте запускается через квантизацию.
Понимает ли GPT-Neo русский язык?
Нет. В карточках всех трёх чекпоинтов указан язык en, обучение шло на англоязычном датасете the Pile. На русский промпт модель отвечает ломаным текстом.
Почему код Telegram-бота из старых статей выдаёт ошибку?
С двадцатой версии python-telegram-bot класс Filters удалён, а точкой входа вместо Updater стал Application. Актуальная версия библиотеки 22.8 требует Python 3.10 и асинхронных обработчиков.
Можно ли использовать GPT-Neo в коммерческом продукте?
Да, лицензия MIT это разрешает. Авторы модели рекомендуют фильтровать вывод перед публикацией: датасет the Pile содержит грубую лексику.