Содержание
- Промт или промпт: как правильно писать это слово
- Из чего состоит промт: четыре части рабочего запроса
- Чем промт отличается от обучения нейросети
- Примеры промтов для программистов: восемь рабочих запросов
- Промты для систем на основе машинного обучения
- Плохой и хороший промт: что меняется в формулировке
- Как проверить промт до отправки: чек-лист из семи пунктов
- Частые ошибки в промтах и что с ними делать
- Частые вопросы про промты
- Что делает промт рабочим
Примеры Prompts (промтов) для программистов

Черновик готовит редакция с помощью ИИ. За стандарт издания отвечает главный редактор — Валерий Курземнек.
Промты это текстовые задания для нейросети: вы описываете словами, что нужно сделать, а модель выполняет — пишет код, разбирает ошибку, формулирует SQL-запрос. Термин пришёл из английского prompt — «подсказка». Промт не обучает модель и не меняет её веса, он управляет одним конкретным ответом. Для программиста промт — рабочий интерфейс к модели: от его точности зависит результат.
Что нужно знать до того, как писать свой первый запрос:
- «Промт» и «промпт» — одно и то же слово. Журнал «Грамота» приводит электронный орфографический словарь «Академос», где слово дано в варианте промпт, а в поисковых запросах, по наблюдению того же журнала, чаще встречается короткое промт.
- Рабочий промт собирается из четырёх частей: кто отвечает, что сделать, пример желаемого результата, контекст задачи. Так формат запроса описан в документации OpenAI.
- Промт не дообучает модель. Примеры внутри запроса (few-shot) в документации OpenAI прямо названы способом направить модель на новую задачу вместо дообучения.
- Промт для кода бесполезен без критерия приёмки: не указали язык, версию и способ проверить ответ — получите правдоподобный код, который не запускается.
- Ниже — восемь промтов под задачи разработчика и пять под машинное обучение, разбор пары «плохой → хороший» и чек-лист из семи пунктов для проверки запроса до отправки.
Промт или промпт: как правильно писать это слово
Вопрос всплывает раньше всех технических: в русском языке параллельно живут два написания. Журнал «Грамота» разбирал слово в декабре 2025 года и зафиксировал расклад так: «В русском языке борются два варианта: промпт — точная транслитерация английского prompt, и промт — упрощенный вариант, так как сочетание согласных звуков [мпт] неудобно произносить. В электронном орфографическом словаре „Академос“ слово дано именно в первом варианте».
То есть словарная норма — промпт, а разговорная и поисковая практика — промт: по наблюдению Грамоты, в поисковых запросах короткий вариант встречается более чем в два раза чаще. В технических текстах допустимы оба; внутри одного документа стоит держаться одного написания.
Разработчикам слово знакомо давно: в середине XX века с DOS и Unix пришёл command prompt — мигающий курсор C:\> был приглашением системы ввести команду. Массовым в нынешнем значении термин стал в 2022 году вместе с ChatGPT и Midjourney (Грамота, «Промпт: запрос к языковой модели»).
Вывод раздела: «промпт» по словарю, «промт» по частотности. На качество ответа модели написание не влияет.
Из чего состоит промт: четыре части рабочего запроса
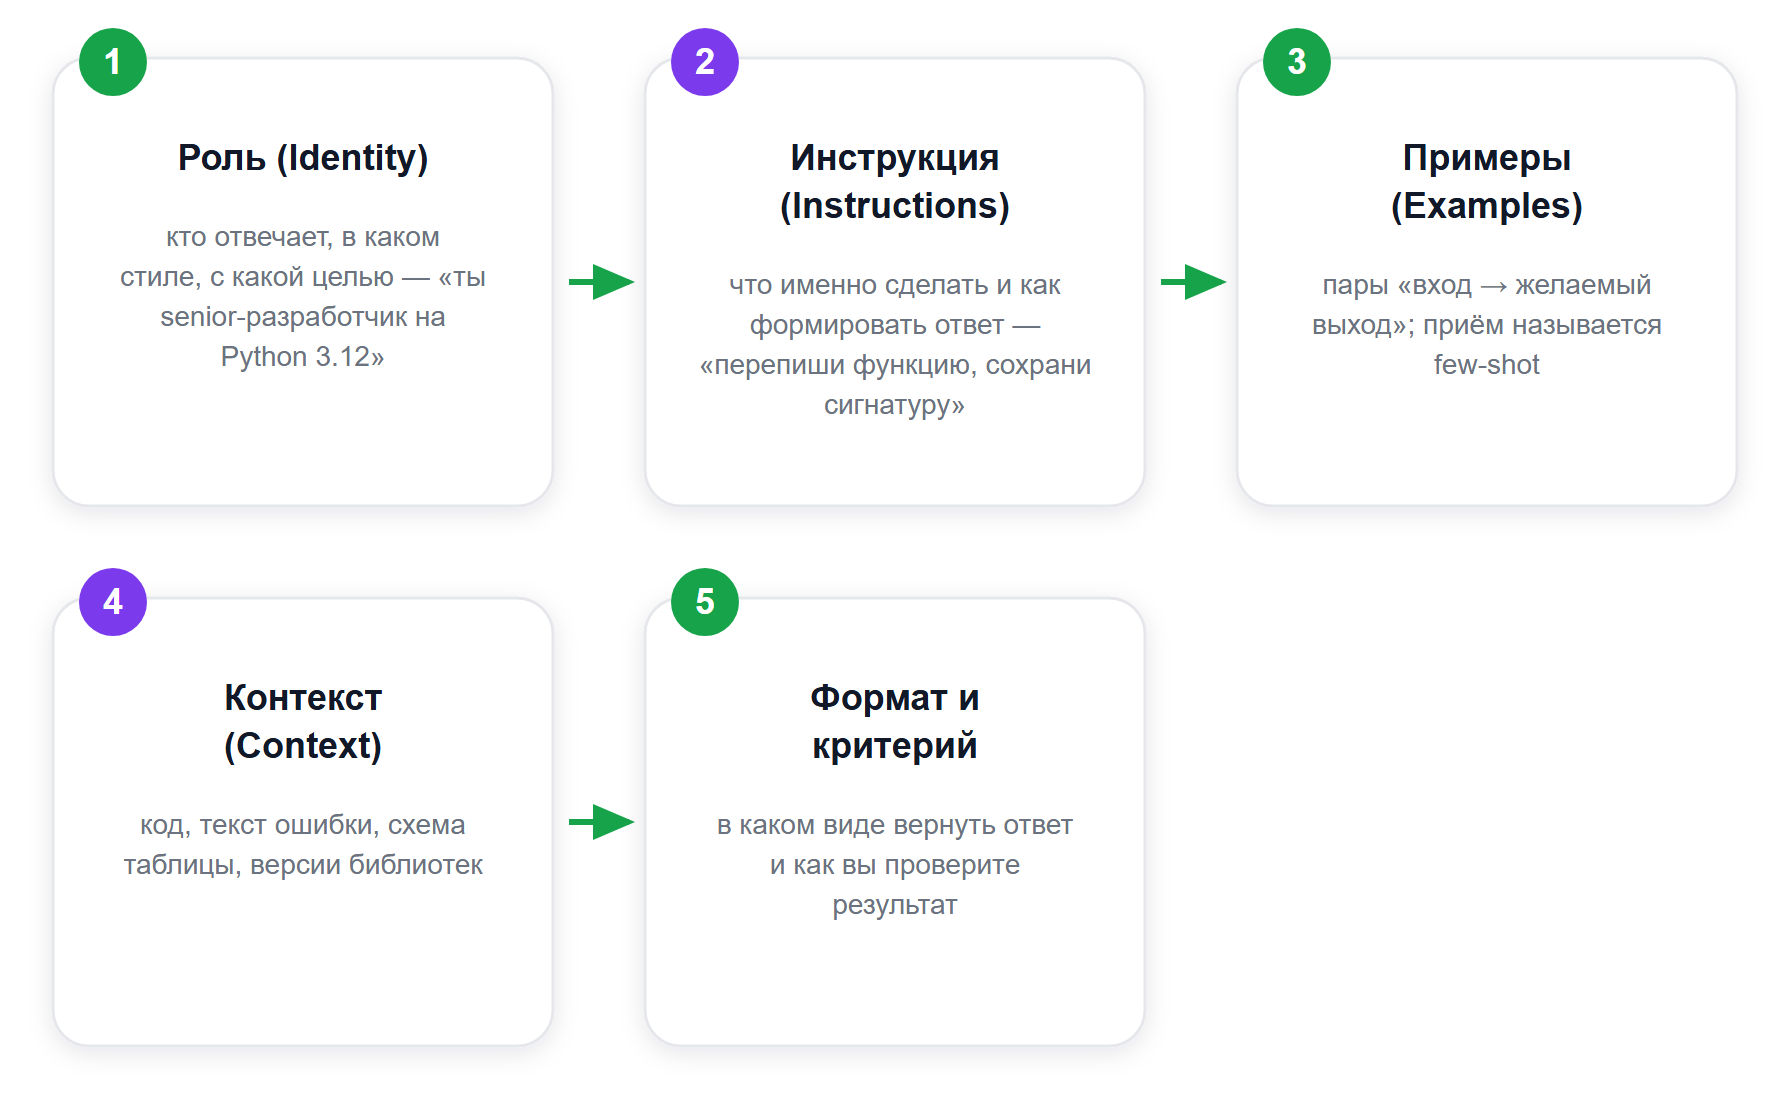
Документация OpenAI предлагает раскладывать инструкцию модели на четыре блока — и это самая проверяемая опора, потому что так описан формат сообщения разработчика в самом API.
| Часть промта | Что в неё кладут (по документации) | Как это выглядит в задаче программиста |
|---|---|---|
| Identity — роль | «Describe the purpose, communication style, and high-level goals of the assistant» — назначение, стиль общения и цели ассистента | «Ты senior-разработчик на Python 3.12, отвечаешь кодом и короткими комментариями, без вводных абзацев» |
| Instructions — инструкция | «Provide guidance to the model on how to generate the response you want» — как именно формировать ответ | «Перепиши функцию так, чтобы сложность была O(n), сохрани сигнатуру, добавь аннотации типов» |
| Examples — примеры | «Provide examples of possible inputs, along with the desired output from the model» — пары «вход → желаемый выход» | Один пример входного JSON и один пример ожидаемого ответа в том же формате |
| Context — контекст | «Give the model any additional information it might need to generate a response» — дополнительные данные для ответа | Фрагмент кода, текст ошибки, схема таблицы, версия библиотеки |
К этому добавляется иерархия ролей: сообщения разработчика в документации описаны как «instructions provided by the application developer, prioritized ahead of user messages» — они приоритетнее пользовательских. Практический смысл для тех, кто работает через API: системные правила вроде «не выдумывай методы библиотеки» держат в developer-сообщении и не повторяют в каждом запросе.
Приём «дать несколько примеров прямо в запросе» называется few-shot. Формулировка из той же документации: «Few-shot learning lets you steer a large language model toward a new task by including a handful of input/output examples in the prompt, rather than fine-tuning the model» — то есть примеры в промте направляют модель на новую задачу вместо дообучения (OpenAI, Prompt engineering).
Вывод раздела: если ответ модели не тот, чаще всего в запросе пропущена одна из четырёх частей — обычно контекст или пример ожидаемого формата.
Чем промт отличается от обучения нейросети
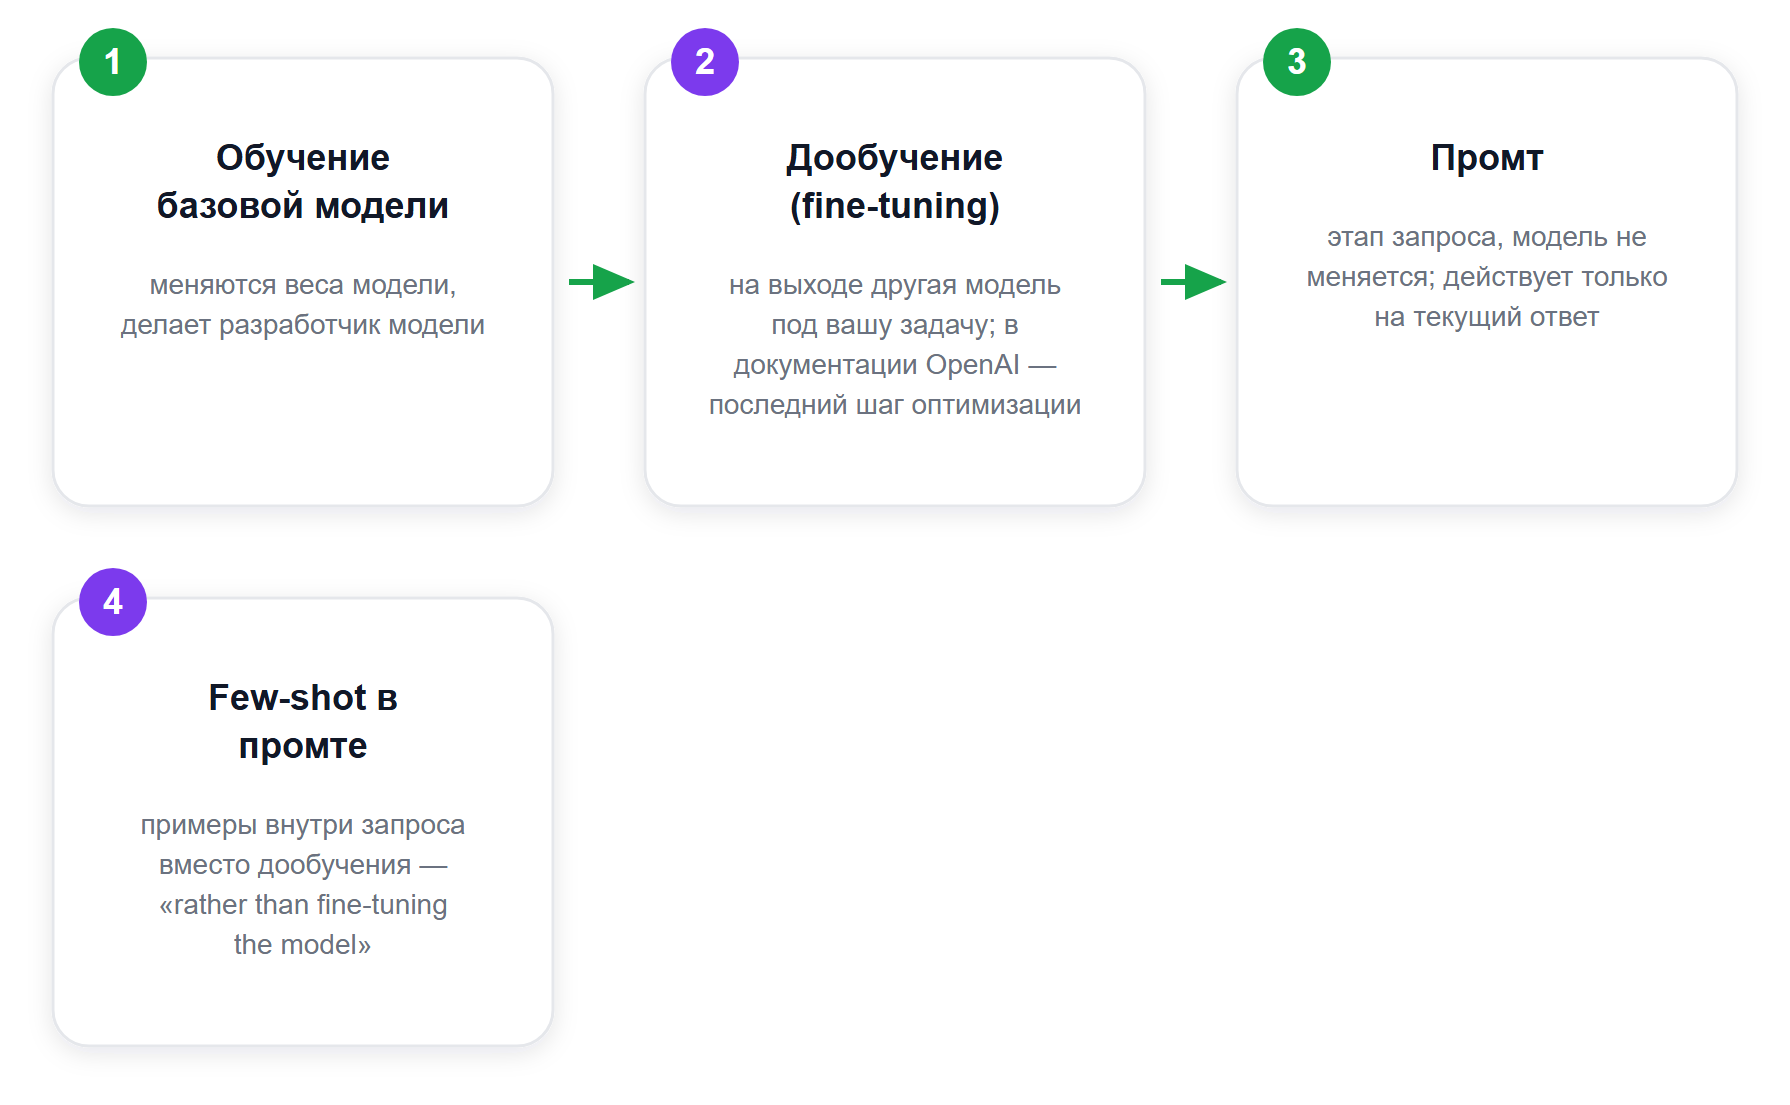
Это место, где ошибаются даже подробные материалы: промт называют способом «обучить нейросеть». Разграничение простое.
- Обучение и дообучение (fine-tuning) меняют саму модель. В документации OpenAI это описано как «take an OpenAI base model, provide the kinds of inputs and outputs you expect in your application, and get a model that excels in the tasks you’ll use it for» — на выходе получается другая модель.
- Промт не меняет ничего: он работает на этапе запроса. Закрыли вкладку — эффект промта закончился. Тот же промт завтра даст другой по формулировкам ответ, потому что генерация вероятностная.
- Порядок работ в документации задан так: метрики оценки ответа, затем промт с контекстом и инструкциями, и только «for some use cases, it may be desirable to fine-tune a model for a specific task». Дообучение стоит последним.
Вывод раздела: фраза «промт для обучения нейросети» — терминологическая ошибка. Промтом вы управляете ответом, дообучением — моделью.
Примеры промтов для программистов: восемь рабочих запросов
Примеры собраны по схеме «роль + инструкция + контекст + формат ответа»: копируйте, подставив свои данные вместо содержимого квадратных скобок. К каждому промту указано, как проверить результат — без этого пункта запрос превращается в лотерею.
1. Промт для генерации кода
Промт: «Ты разработчик на Python 3.12. Напиши функцию, которая сортирует список чисел по возрастанию без использования встроенного sorted. Сигнатура: sort_numbers(items: list[int]) -> list[int]. Добавь аннотации типов и три ассерта, проверяющих пустой список, список из одного элемента и список с дубликатами. Верни только код».
Применение: типовые функции, утилиты, обвязка вокруг чужого API. Проверка: запустить ассерты — они либо проходят, либо нет.
2. Промт для создания запроса к базе данных
Промт: «Схема: таблица users(id serial, first_name text, last_name text, birth_date date, created_at timestamptz). СУБД PostgreSQL 16. Сформулируй SQL-запрос, который выводит имя, фамилию и полный возраст всех пользователей старше 30 лет, отсортированных по возрасту убыванию. Возраст считать на текущую дату. Верни один запрос и объясни одной строкой, почему выбран именно такой способ подсчёта возраста».
Применение: аналитические выборки, миграции, отчёты. Проверка: выполнить на копии базы и сверить количество строк с контрольным COUNT(*). Классическая ошибка модели без указания СУБД — синтаксис MySQL в запросе к PostgreSQL.
3. Промт для разбора ошибки
Промт: «Вот трассировка ошибки и фрагмент кода, где она возникает: [вставить traceback и 20–30 строк кода]. Версии: [язык, фреймворк, библиотека]. Назови вероятную причину, укажи конкретную строку и предложи минимальную правку. Если данных для однозначного вывода не хватает — скажи, какого фрагмента не хватает, вместо догадки».
Применение: отладка. Последнее предложение важнее остальных: без него модель почти всегда выдаёт уверенную версию причины, даже когда контекста недостаточно. Проверка: применить правку и воспроизвести сценарий, который падал.
4. Промт для ревью чужого кода
Промт: «Проведи ревью этого модуля: [код]. Роль — техлид. Пройди по четырём категориям: корректность, безопасность, читаемость, производительность. По каждой находке дай номер строки, объяснение в одно предложение и вариант правки. Не переписывай модуль целиком. Если критичных замечаний нет, так и напиши».
Применение: подготовка к код-ревью, разбор легаси. Проверка: каждая находка привязана к строке — можно открыть и посмотреть глазами.
5. Промт для написания тестов
Промт: «Напиши юнит-тесты на pytest для функции [вставить код]. Покрой: обычный сценарий, граничные значения, некорректный тип на входе, пустой ввод. Каждый тест — отдельная функция с говорящим именем. Мокай только внешние вызовы, чистую логику не мокай».
Применение: добор покрытия на легаси-коде, где тестов не было. Проверка: прогнать тесты и убедиться, что они падают на намеренно сломанной версии функции — тест, который проходит всегда, ничего не проверяет.
6. Промт для рефакторинга
Промт: «Отрефактори функцию [код]. Ограничения: публичная сигнатура и поведение не меняются, внешние зависимости не добавляются, стиль — PEP 8. Разбей на функции не длиннее 20 строк. Покажи результат и отдельным списком — что именно изменено и зачем».
Применение: приведение кода в порядок перед передачей другой команде. Проверка: существующие тесты должны проходить без правок — это и есть определение рефакторинга.
7. Промт для генерации тестовых данных
Промт: «Сгенерируй 20 записей тестовых данных в формате JSON по схеме: [поля и типы]. Требования: реалистичные русские имена, даты в диапазоне [период], пять записей должны нарушать бизнес-правило [условие] — их пометь полем invalid: true. Верни только JSON без пояснений».
Применение: наполнение стенда, проверка валидации, демо. Проверка: прогнать вывод через валидатор схемы. Отдельно про машинное обучение: синтетика годится для проверки пайплайна, но модель, обученная только на ней, на реальных данных работает хуже.
8. Промт для документации
Промт: «Напиши docstring в стиле Google для функции [код] и краткий раздел README: назначение, параметры, возвращаемое значение, один пример вызова с реальными данными, известные ограничения. Не описывай то, чего нет в коде».
Применение: сдача модуля, онбординг новых разработчиков. Проверка: сверить перечисленные параметры с сигнатурой — модель охотно документирует несуществующие аргументы.
Вывод раздела: сильный промт для разработчика всегда содержит три вещи, которых нет в бытовом запросе — версии окружения, ограничение («не меняй сигнатуру», «верни только код») и способ проверить ответ.
Промты для систем на основе машинного обучения
В ML-проекте модель обучают код и данные, промт в это не вмешивается. Зато он закрывает работу вокруг обучения, которая обычно съедает больше времени, чем сам запуск: разметка сырых данных, расширение редких классов, перебор признаков, скелет обучающего скрипта, разбор метрик. Пять запросов ниже собраны по той же схеме «роль + инструкция + контекст + формат ответа». Способ проверки у каждого жёстче, чем в задачах на код: ошибку в данных не видно глазами, она проявляется завышенной оценкой качества.
9. Промт для разметки датасета
Промт: «Ты разметчик текстов. Классифицируй каждое сообщение по классам: [класс — определение одной строкой; повторить для каждого класса]. Правила: ровно один класс на сообщение; если сообщение не подходит ни под один класс, верни unknown; если подходит под два, верни ambiguous и назови конкурирующие классы. Примеры разметки, включая один пограничный: [3–5 пар «текст → класс»]. Формат ответа: JSONL с полями id, label, reason. Размечай только присланное, новых текстов не придумывай. Данные: [сообщения с id]».
Применение: первичная разметка корпуса под обучение классификатора, предразметка перед ручной проверкой. Проверка: отложите эталонный кусок, размеченный человеком, и сравните с ответом модели по матрице ошибок — она покажет, какие именно классы модель путает. Если на тех же примерах расходятся и люди между собой, дефект лежит в определении класса; его и переписывают в промте.
10. Промт для аугментации датасета
Промт: «Перефразируй каждый текст из списка, сохранив его класс [класс] и фактический смысл. Для каждого исходного текста дай три варианта: разговорный, с типичными опечатками, сокращённый до одного предложения. Запрещено менять числа, даты, названия продуктов и упомянутые ошибки. Формат: JSONL с полями source_id, variant, style. Данные: [тексты с id]».
Применение: расширение редких классов в несбалансированной выборке, проверка устойчивости модели к формулировкам. Проверка: аугментированные примеры кладут только в обучающую часть — если перефразировка попадёт в отложенную выборку рядом со своим оригиналом, оценка качества окажется завышенной. Часть вариантов прочитайте глазами: класс должен сохраниться. Оговорка та же, что у синтетических данных из промта №7 — модель, обученная на одних перефразировках, на живых данных работает хуже.
11. Промт для генерации признаков
Промт: «Схема таблицы: [поля и типы]. Предсказываем [целевая переменная]. Момент предсказания: [когда модель применяется в реальном процессе]. Предложи признаки, которые считаются из этих полей. По каждому дай формулу на pandas, гипотезу, чем признак может быть полезен, и момент, когда его значение становится известно. Отдельным списком перечисли признаки, которые использовать нельзя, потому что на момент предсказания их ещё не существует. Полей, которых нет в схеме, не выдумывай».
Применение: старт табличной задачи, ревизия уже собранного набора признаков. Проверка: по каждому признаку задайте один вопрос — известно ли его значение в тот момент, когда модель работает на проде. Это проверка на утечку целевой переменной, и она важнее изящества формулы. Сами формулы выполните на срезе данных: колонка должна посчитаться без ошибки и не оказаться сплошными пропусками.
12. Промт для кода обучающего пайплайна
Промт: «Напиши обучающий скрипт на scikit-learn для задачи [бинарная классификация / многоклассовая классификация / регрессия]. Данные: [схема таблицы], целевая переменная [поле]. Требования: разбиение на обучающую и отложенную части со стратификацией по таргету и фиксированным random_state; все преобразования признаков собраны в Pipeline; кросс-валидация на обучающей части; метрики [перечислить нужные] считаются на отложенной; обученный пайплайн сохраняется в файл; версии использованных библиотек логируются при запуске. Один файл с точкой входа. Числовых результатов в коде и комментариях не пиши — их даст запуск».
Применение: перенос ноутбука в воспроизводимый скрипт, скелет нового эксперимента. Проверка: запустите дважды с тем же random_state — метрики обязаны совпасть. Требование «все преобразования внутри Pipeline» стоит в промте против утечки: масштабирование или кодирование категорий, обученное на всей таблице до разбиения, уже видело отложенную часть. Последняя фраза закрывает привычку модели дописывать в комментарии правдоподобные цифры качества, которых никто не измерял.
13. Промт для оценки качества модели
Промт: «Задача: [тип], доли классов в выборке: [доли]. Вот отчёт по метрикам и матрица ошибок с отложенной части: [вставить вывод как есть]. Сценарий применения: [кто и как пользуется предсказанием, цена ошибки каждого типа]. Объясни, что каждая метрика значит в этом сценарии; скажи, какая ошибка дороже — пропуск или ложное срабатывание; перечисли выводы, которые по этим числам делать нельзя. Улучшения предлагай после того, как назовёшь ограничения самой оценки».
Применение: разбор результатов эксперимента, подготовка к разговору с заказчиком о том, что модель действительно умеет. Проверка: посчитайте своим кодом тривиальную базу — что даст классификатор, всегда отвечающий самым частым классом, — и сравните с метриками модели. Числа для сравнения берите из своего прогона: пересказ метрик в ответе модели может разойтись с исходным отчётом.
Вывод раздела: в машинном обучении промт работает на входе и выходе пайплайна — данные, признаки, код эксперимента, чтение метрик. Обучение остаётся за кодом и данными, и поэтому критерий приёмки у ML-промта числовой: эталонный кусок разметки, повторяемость запуска, сравнение с тривиальной базой.
Тот же принцип работает и за пределами разработки. Промты применяют для генерации изображений и описаний товаров, для рекомендательных систем и чат-ботов, для анализа тональности отзывов и аугментации данных при машинном обучении — состав частей запроса не меняется, меняется предметная область. Если задача шире разработки, посмотрите разбор ГигаЧата и Алисы как рабочих AI-ассистентов — там те же четыре части промта на непрограммистских задачах. Если нужно быстро собрать работающий прототип, помогает подборка бесплатных нейросетей для подготовки MVP.

- Возможность получить Доступ в Нейроклуб на целый месяц
- Как ИИ ускоряет работу и приносит деньги
- За 2 часа вы получите четкий план, как начать работать с ИИ прямо сейчас!
Плохой и хороший промт: что меняется в формулировке
Разница между запросом, который экономит время, и запросом, после которого код переписывают вручную, лежит в четырёх местах. Те же задачи в двух редакциях:
| Задача | Слабый промт | Сильный промт | Что добавлено |
|---|---|---|---|
| Код | «Напиши функцию сортировки» | «Python 3.12, функция sort_numbers(items: list[int]) -> list[int] без sorted, с аннотациями типов и тремя ассертами. Только код» | Язык и версия, сигнатура, ограничение, формат ответа |
| SQL | «Сделай запрос по клиентам старше 30» | «PostgreSQL 16, схема users(…), вывести имя, фамилию, возраст; возраст на текущую дату; сортировка по убыванию» | СУБД, схема таблицы, правило расчёта, порядок |
| Отладка | «Почему не работает код?» | «Traceback + 30 строк кода + версии. Назови строку и минимальную правку; не хватает данных — скажи, чего» | Контекст, запрет на догадку |
| Ревью | «Посмотри мой код» | «Ревью по четырём категориям, номер строки, объяснение в одно предложение, вариант правки» | Критерии, структура ответа, объём |
Вывод раздела: сильный промт отличается от слабого не длиной и не вежливостью, а количеством снятых неопределённостей.
Как проверить промт до отправки: чек-лист из семи пунктов
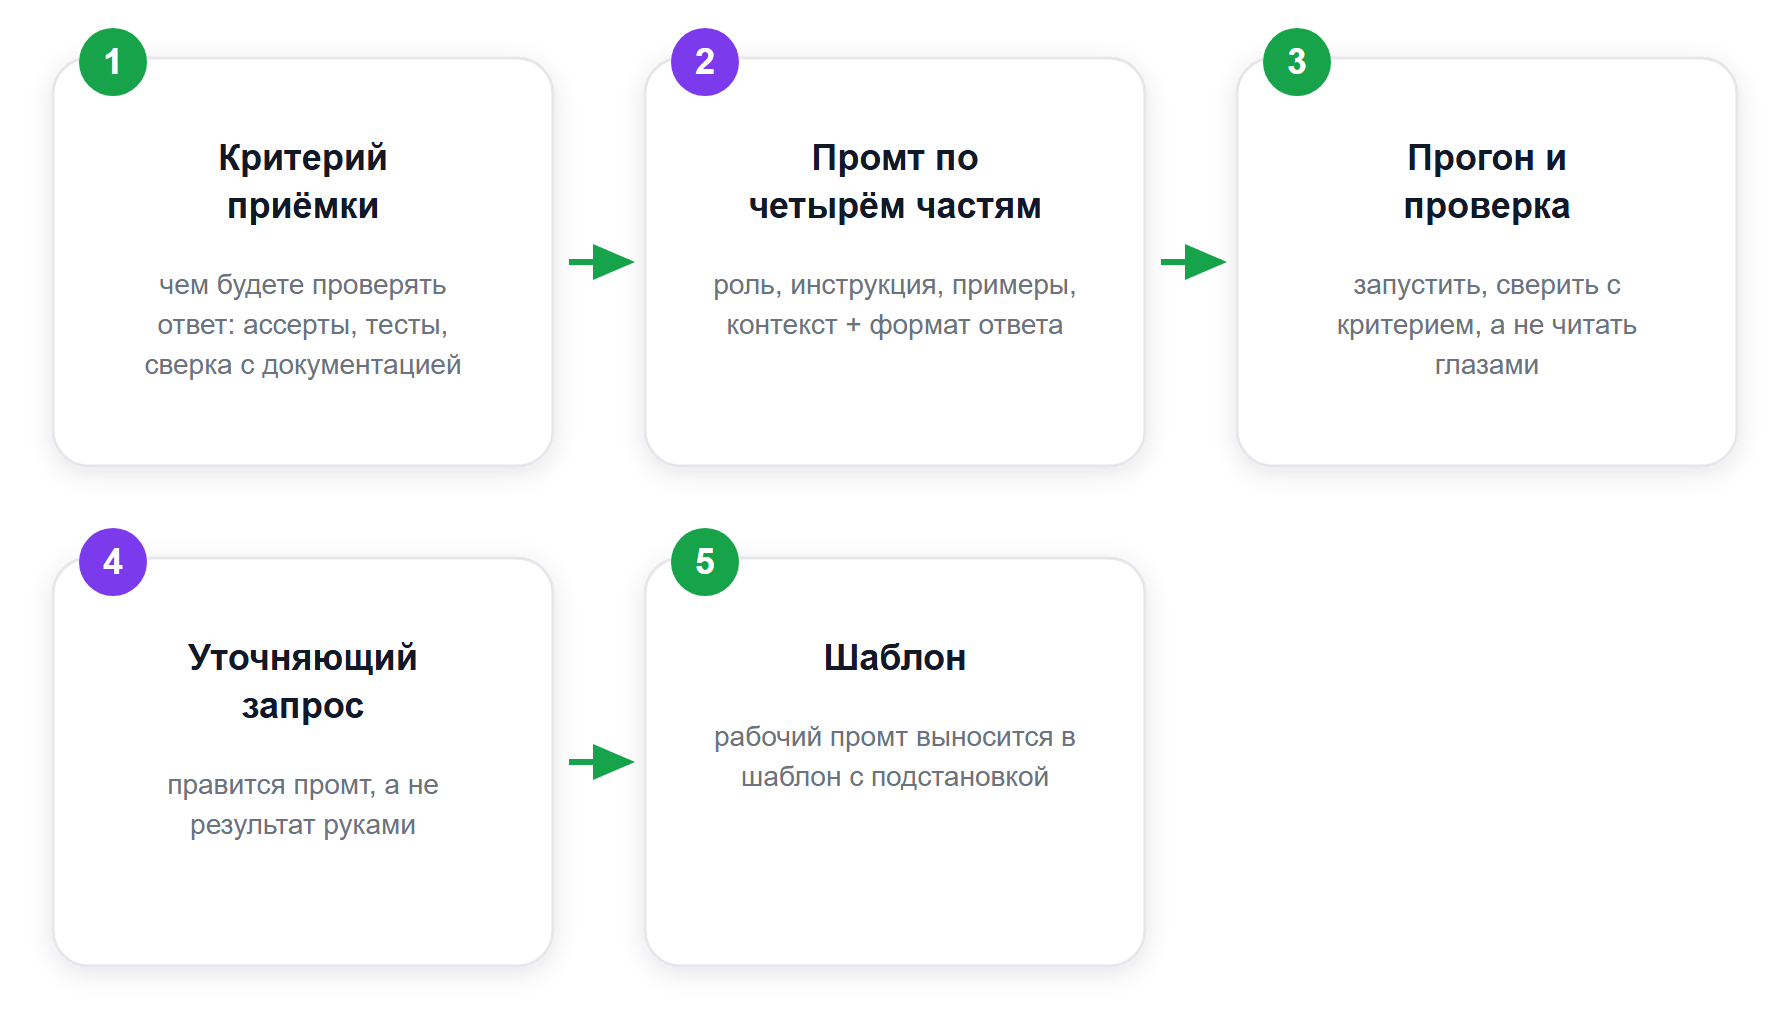
В топе выдачи по запросу «промты это» объясняют, как писать промт, но процедуры самопроверки не дают ни в одном материале. Пройдите по семи пунктам перед отправкой.
- Роль назначена. Модель понимает, от чьего лица отвечать и в каком стиле.
- Задача — одна. «Напиши функцию, покрой тестами и задокументируй» распадается на три запроса; в одном ответе качество проседает на каждой из трёх частей.
- Версии указаны. Язык, фреймворк, СУБД, библиотека. Без этого модель выберет самый частый в обучающих данных вариант, а он может быть устаревшим.
- Контекст вложен, а не подразумевается. Код, ошибка, схема таблицы — текстом в запросе.
- Формат ответа задан. «Только код», «JSON без пояснений», «таблица с четырьмя колонками».
- Запрет на выдумку прописан. Формулировка «если данных не хватает — скажи, чего именно» снимает значительную часть уверенных, но неверных ответов.
- Критерий приёмки понятен вам самому. Если вы не можете сказать, как проверите ответ, промт написан рано — сначала критерий, потом запрос.
Вывод раздела: шесть из семи пунктов — это перенос в текст того, что вы и так держите в голове, ставя задачу коллеге. Модель не считывает контекст по умолчанию.
Частые ошибки в промтах и что с ними делать
- Запрос без версий. Ответ приходит на синтаксисе, который в вашем окружении не соберётся. Лечится одной строкой в начале промта.
- Вежливость вместо конкретики. «Напиши хороший, качественный, оптимизированный код» не добавляет ни одного ограничения: «оптимизированный» без указания, по чему оптимизировать — по памяти, по времени, по читаемости — модель трактует произвольно.
- Одна попытка. Работа с моделью итеративная: первый ответ уточняют вторым запросом, а не переписывают руками. В документации OpenAI цикл описан прямо — прогнать, оценить, поправить промт, повторить.
- Доверие к правдоподобию. Модель одинаково уверенно называет существующий и несуществующий метод библиотеки: любой вызов API из ответа сверяется с документацией.
- Смешение промта и дообучения. Попытка «обучить» модель, повторяя одно и то же в чате, не работает: между сессиями ничего не сохраняется, если это не заявленная функция сервиса.
- Ручное копирование промта. Повторяющиеся запросы выносят в шаблон с подстановкой — так же, как выносят повторяющийся код.
Когда таких шаблонов набирается больше десятка и ими пользуется команда, задача перестаёт быть личной привычкой и становится процессом. Как это устроено на практике, разобрано в материале про масштабирование работы с ИИ-инструментами.
Частые вопросы про промты
Промты это что простыми словами?
Промты это текстовые задания для нейросети, написанные обычным языком. Вы формулируете, что нужно получить, модель выполняет и возвращает ответ. Слово пришло из английского prompt — «подсказка».
Как правильно — промт или промпт?
Журнал «Грамота» приводит электронный орфографический словарь «Академос», где слово дано в варианте «промпт». В поисковых запросах, по наблюдению того же журнала, более чем в два раза чаще встречается «промт». Оба написания употребляются в технических текстах; смысл один.
Промт обучает нейросеть?
Нет. Промт действует на этапе запроса и не меняет модель. Обучение и дообучение (fine-tuning) — отдельная процедура, которая производит новую модель. Примеры внутри промта (few-shot) в документации OpenAI прямо описаны как способ направить модель на новую задачу вместо дообучения.
Какой промт написать, чтобы нейросеть сгенерировала код?
Укажите роль, язык и версию, точную сигнатуру функции, ограничения и формат ответа. Пример: «Ты разработчик на Python 3.12. Напиши функцию sort_numbers, которая принимает список целых чисел и возвращает новый отсортированный список, без использования sorted, с аннотациями типов и тремя ассертами. Верни только код». Ответ проверяется запуском ассертов.
Почему на один и тот же промт приходят разные ответы?
Генерация текста вероятностная: модель каждый раз выбирает продолжение из распределения, поэтому формулировки отличаются. Стабилизировать помогает жёсткий формат ответа и примеры «вход → выход» в промте, но полной идентичности ответов ожидать не стоит.
Как использовать промты в разработке систем машинного обучения?
Промт помогает на этапах вокруг обучения: разметка и аугментация датасета, подбор признаков с формулами, скелет обучающего скрипта, разбор метрик и матрицы ошибок. Саму модель обучают код и данные, поэтому критерий приёмки у ML-промта числовой — эталонный кусок разметки, повторяемость запуска с фиксированным random_state, сравнение с тривиальной базой из самого частого класса.
Нужен ли программисту отдельный навык промт-инжиниринга?
Промт-инжиниринг — это дисциплина формулирования запросов: структура, примеры, ограничения, оценка результата. Для разработчика она ближе к постановке задачи, чем к новому языку программирования, и осваивается на своих же рабочих задачах.
Что делает промт рабочим
Промты это способ управлять ответом нейросети текстом. Для программиста ценность появляется тогда, когда запрос перестаёт быть вопросом и становится техническим заданием: роль, версии, контекст, ограничения, формат и критерий проверки. Тринадцать промтов выше закрывают типовые задачи разработки и работы с ML-пайплайном. Возьмите один, доведите до состояния, когда ответ проходит проверку без правок, и превратите в шаблон.
- Выполним базовые задачи на российских нейросетях и посмотрим на результаты!
- Файл-инструкцию «Как сделать нейро-фотосессию из своего фото бесплатно, без иностранных карт и прочих сложностей»
- Покажем 10+ способов улучшить свою жизнь с ИИ каждому — от ребенка и пенсионера до управленца и предпринимателя
- Возможность получить Доступ в Нейроклуб на целый месяц
- Как ИИ ускоряет работу и приносит деньги
- За 2 часа вы получите четкий план, как начать работать с ИИ прямо сейчас!