Содержание
- Как называется ТЗ для нейросети: промпт, системный промпт и промпт-инжиниринг
- Чем промпт отличается от развёрнутого ТЗ для нейросети
- Структура ТЗ для нейросети: шесть блоков
- Наш прогон: одна задача, два ТЗ, 60 ответов
- Шаблон ТЗ для нейросети, который мы прогоняли
- ТЗ на изображение: пример задания на герб из тигра и феникса
- ТЗ на разработку ИИ-системы: десять разделов по ГОСТ 34.602-2020
- Частые ошибки в ТЗ для нейросети и как их исправить
- Чек-лист: как подготовить техническое задание для нейросети
- Частые вопросы про ТЗ для нейросети
- Что запомнить про ТЗ для нейросети
Как подготовить техническое задание для нейросети

Черновик готовит редакция с помощью ИИ. За стандарт издания отвечает главный редактор — Валерий Курземнек.
Задание для нейросети называется промптом. Справка GigaChat определяет его так: «Промпт (от англ. prompt — «подсказка») — это текстовое описание задачи, которую необходимо выполнить с помощью ИИ-модели». Навык составлять такие задания зовут промпт-инжинирингом. Если же нужен документ для подрядчика, который разрабатывает ИИ-систему, это техническое задание на создание автоматизированной системы по ГОСТ 34.602-2020.
Дальше — что стоит за каждым из этих слов, из каких блоков собирается рабочее задание на текст и на изображение и сколько ответов модели проходит приёмку при слабой и при сильной постановке задачи. Цифры внизу сняты с нашего собственного прогона 17 сентября 2026 года.
- Промпт — задание модели на один ответ. Живёт в одном сообщении.
- Системный промпт — правила, которые действуют на весь диалог и задаются один раз.
- Промпт-инжиниринг — навык формулировать задания так, чтобы результат был предсказуем.
- ТЗ на создание АС (ГОСТ 34.602-2020) — документ для разработчика ИИ-системы, десять обязательных разделов.
- Блок, который решает больше всего, — критерии приёмки: без них ответ невозможно ни принять, ни вернуть.
Материал обновлён 17 сентября 2026 года.
Как называется ТЗ для нейросети: промпт, системный промпт и промпт-инжиниринг
Одним словом «ТЗ для нейросети» в рунете называют два разных предмета, и путаница между ними стоит дороже всего. Первый — постановка задачи самой модели, и у неё есть точное имя: промпт. Второй — документ, по которому подрядчик строит ИИ-систему; он подчиняется межгосударственному стандарту и называется техническим заданием на создание автоматизированной системы. Ниже — термины с определениями из первоисточников.
| Термин | Что это по источнику | Источник |
|---|---|---|
| Промпт (prompt) | «текстовое описание задачи, которую необходимо выполнить с помощью ИИ-модели. Это запрос, который задается модели для генерации текста, изображений, кода или других видов контента» | справка GigaChat, «Основы промпт-инжиниринга», обновлена 2 февраля 2026 |
| Системный промпт (system prompt) | «специальное сообщение, используемое для управления поведением языковой модели… можно передать только один раз в самом первом сообщении» | там же |
| Пользовательский промпт (user prompt) | «запрос пользователя, который должна выполнить модель, следуя инструкциям, которые описаны в системном промпте» | там же |
| Промпт-инжиниринг | «процесс создания эффективных и точных промптов для работы с большими языковыми моделями (LLM)» | там же |
| Техническое задание на создание автоматизированной системы | заголовок стандарта; в английском варианте — «Technical assignment for developing of automated system» | ГОСТ 34.602-2020, введён приказом Росстандарта от 19 ноября 2021 г. № 1522-ст, дата введения — 1 января 2022 г. |
Практическое следствие простое. Когда вы просите у ChatGPT, GigaChat или DeepSeek текст, таблицу или код — вы пишете промпт, и весь остальной материал ниже про него. Когда вы нанимаете команду строить ИИ-сервис — вы пишете ТЗ по ГОСТу, и там свои десять разделов; о них отдельный раздел в конце.
Чем промпт отличается от развёрнутого ТЗ для нейросети
Короткий промпт — это запрос в одну-две строки, который быстро даёт результат для простой задачи. Развёрнутое ТЗ для нейросети — тот же промпт, но с контекстом, целью, форматом вывода, ограничениями и критериями оценки. Разница измеряется тем, сколько решений вы оставили модели. Короткий запрос хорош, когда допустима вариативность и вы всё равно будете выбирать из нескольких вариантов. Развёрнутая постановка нужна там, где результат должен быть повторяемым и проверяемым: серия карточек товара, генерируемый код для продукта, регулярный аналитический отчёт.
Справка GigaChat описывает ту же границу через устройство запроса: системный промпт задаёт роль и правила один раз на весь диалог, пользовательский промпт несёт конкретную задачу. В списке того, что для этого нужно, справка отдельным пунктом называет «иметь критерии оценки качественного промпта» — приёмка объявлена частью навыка.
Практический ориентир: если задачу вы решаете один раз и сами оцените результат глазами — хватит промпта. Если задача повторится хотя бы пять раз или результат будет принимать кто-то другой — пишите развёрнутое задание и фиксируйте его как версию. Ниже приведён замер, показывающий, во что обходится разница.
Структура ТЗ для нейросети: шесть блоков
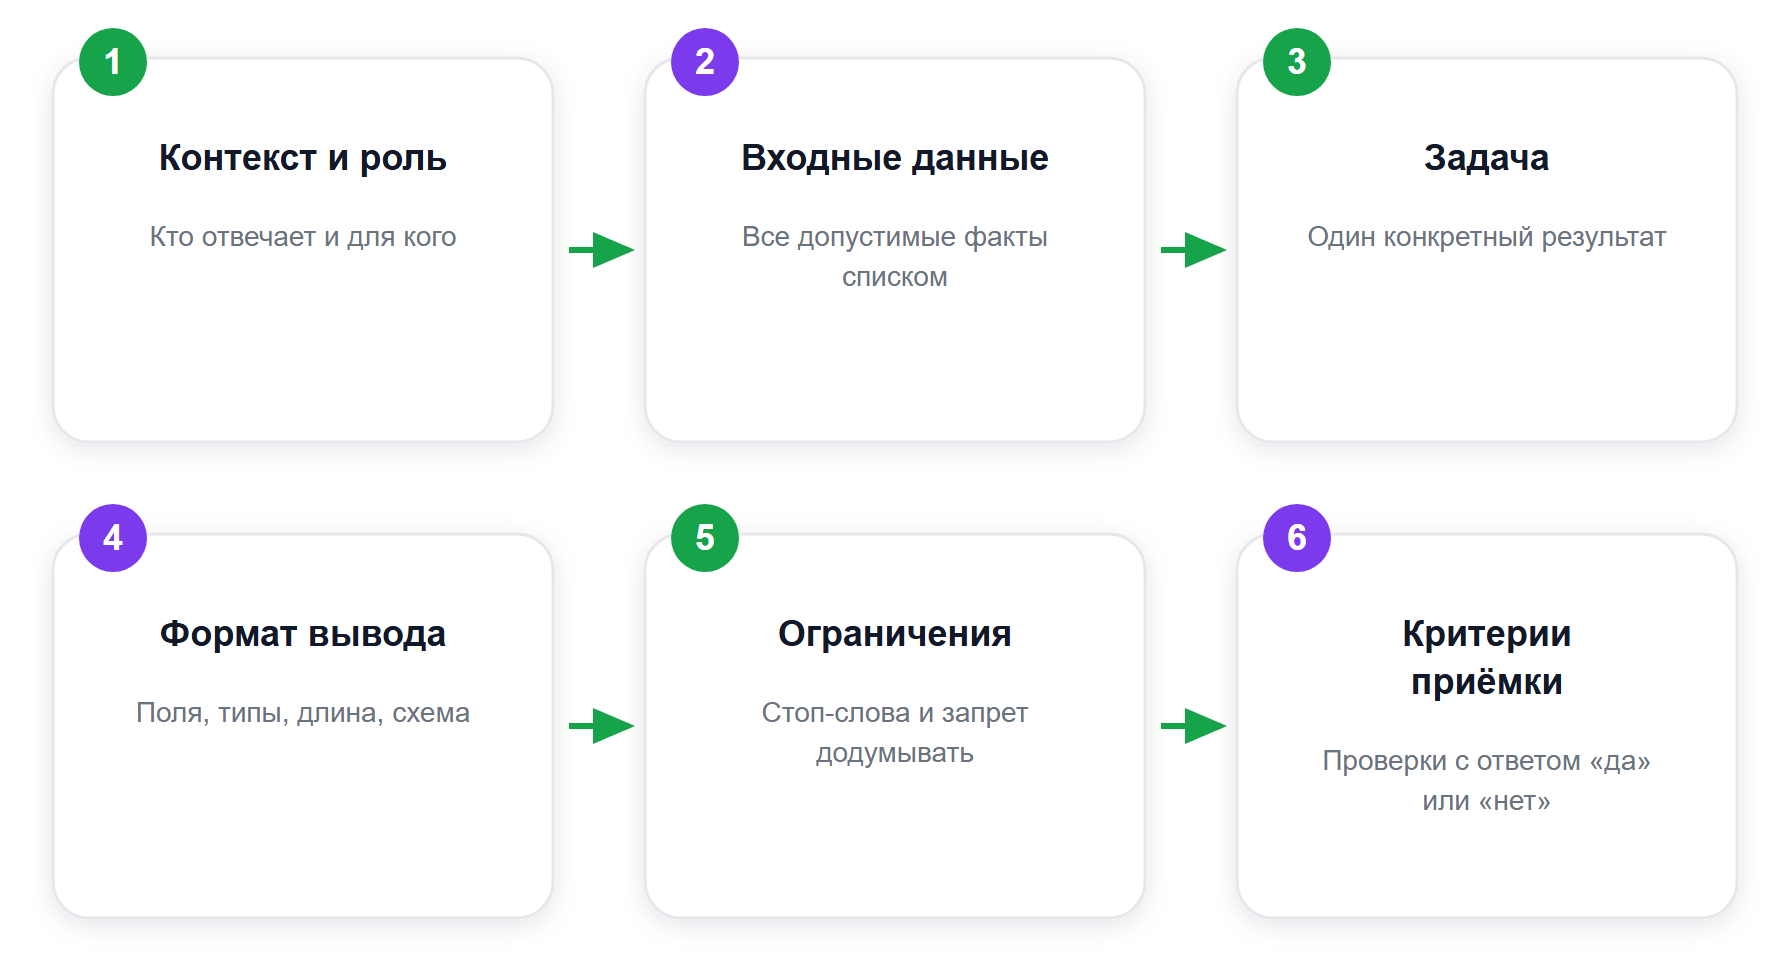
Рабочее ТЗ для нейросети собирается из шести блоков. Первые четыре собраны по составу системного промпта из справки GigaChat: «Роль», «Входные данные», «Задача», «Индикатор вывода — формат или тип ожидаемого ответа от модели после обработки входных данных. Также можно задать ограничения для ответа модели». Два последних блока добавляются, когда результат кто-то принимает.
- Контекст и роль. Кто отвечает и для кого. «Ты составляешь карточки для маркетплейса, читатель сравнивает десять карточек подряд» работает лучше, чем «ты профессиональный копирайтер».
- Входные данные. Все факты, которыми можно пользоваться, перечислены явно. Это же ограничивает выдумку: чего в списке нет, того в ответе быть не должно.
- Задача. Один конкретный результат. Две задачи в одном задании модель почти всегда сводит к одной.
- Формат вывода. Структура ответа: поля, типы, длина. Для машинной обработки — прямо JSON-схема.
- Ограничения. Что запрещено: стоп-слова, запрет додумывать характеристики, границы по объёму.
- Критерии приёмки. Пронумерованный список проверок, по которым работа принимается или возвращается. Каждая проверка формулируется так, чтобы ответ на неё был «да» или «нет».
Шестой блок — тот, который чаще всего пропускают, и именно он отделяет задание от пожелания. Показательно, что того же требует и государственный стандарт на ТЗ: в подразделе «Цели создания АС» ГОСТ 34.602-2020 предписывает: «указывают критерии оценки достижения целей создания АС». Требование без критерия проверки не является требованием ни для человека, ни для модели.
Наш прогон: одна задача, два ТЗ, 60 ответов
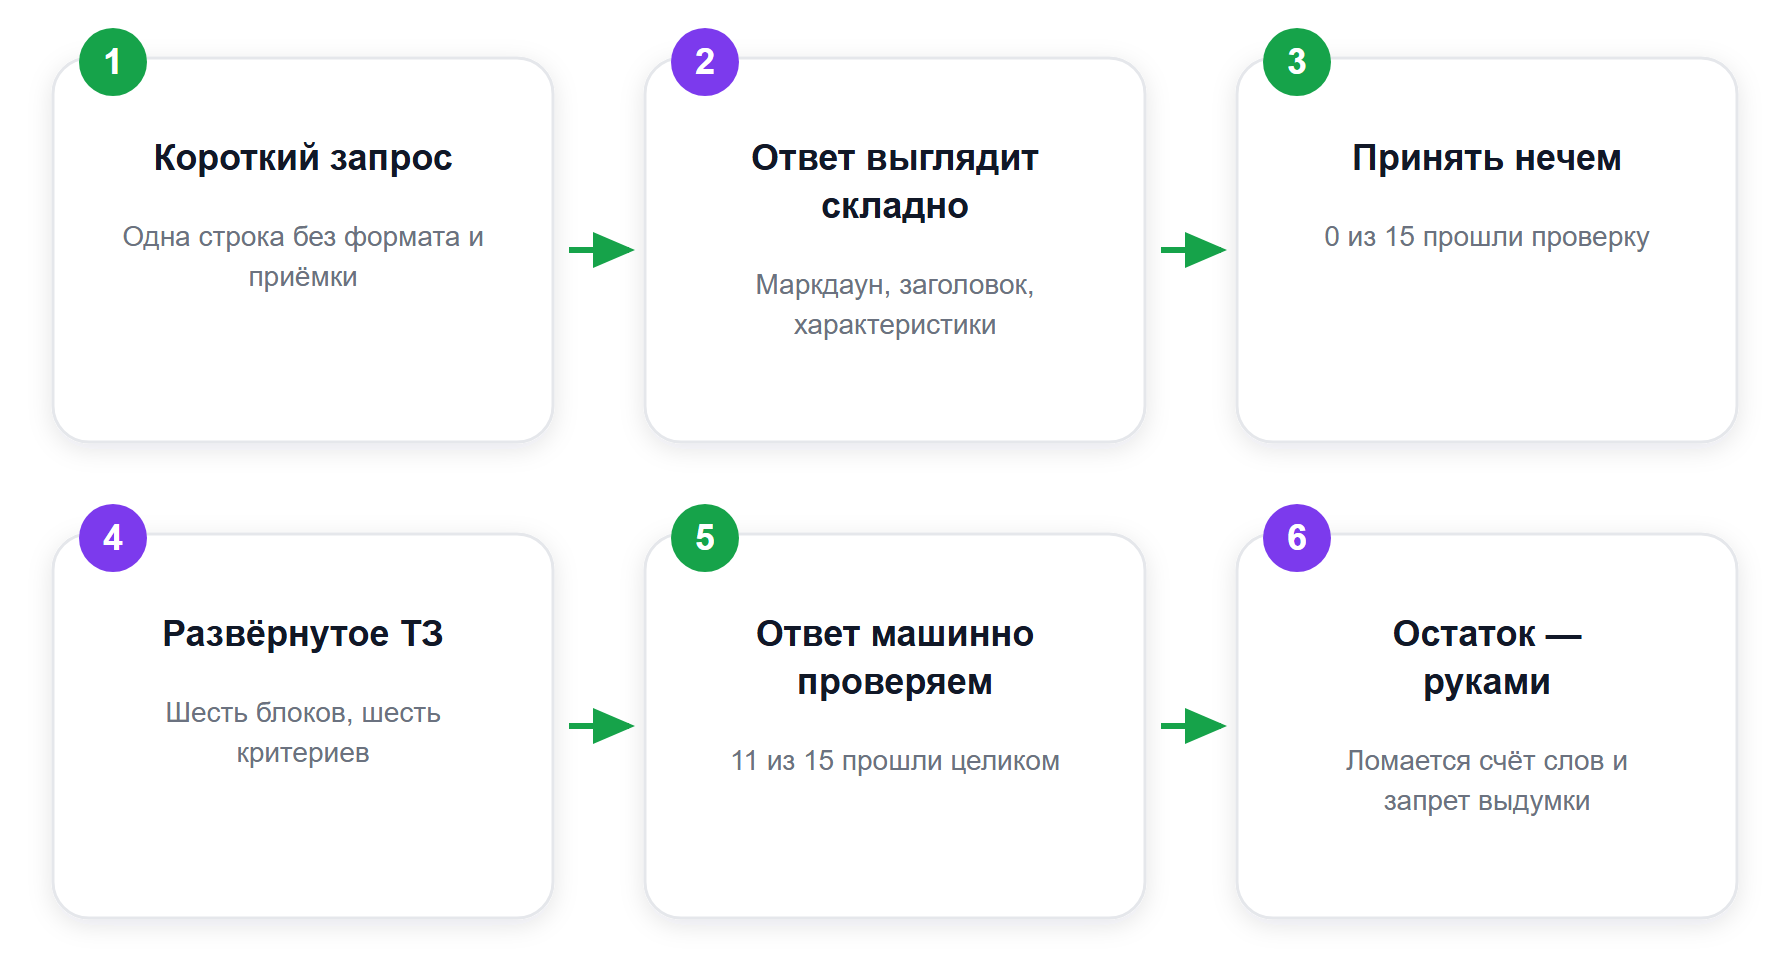
17 сентября 2026 года мы прогнали один и тот же заказ через модель DeepSeek-V3.1 (через API OpenRouter, температура по умолчанию, лимит ответа 900 токенов) двумя способами: коротким запросом и развёрнутым ТЗ. По 15 повторов на каждый способ. Таблицу ниже даёт DeepSeek-V3.1; тот же прогон продублирован на второй модели для контроля, её числа — в конце раздела. Всего 60 ответов. Шесть критериев приёмки были записаны до первого запуска, и проверял их скрипт: ответ парсится как JSON; ключей ровно три; title не длиннее 60 символов; в bullets ровно три элемента; description от 40 до 60 слов; ни одного слова из стоп-листа.
Заказ в обоих плечах одинаковый — карточка товара для маркетплейса: беспроводные наушники TWS, 3 990 ₽, 6 часов работы без кейса, шумоподавление ANC. В плече A задание выглядело так, как его обычно и пишут: «Напиши карточку товара для маркетплейса. Товар: беспроводные наушники TWS, цена 3 990 ₽, 6 часов работы без кейса, активное шумоподавление ANC.» В плече B — то же самое, разложенное по шести блокам из раздела выше; полный текст приведён ниже.
| Критерий приёмки | Короткий запрос | Развёрнутое ТЗ |
|---|---|---|
| 1. Ответ целиком парсится как JSON | 0 / 15 | 14 / 15 |
| 2. Ключей ровно три | 0 / 15 | 15 / 15 |
| 3. title ≤ 60 символов | 0 / 15 | 15 / 15 |
| 4. Ровно три буллета | 0 / 15 | 15 / 15 |
| 5. description 40–60 слов | 0 / 15 | 11 / 15 |
| 6. Без стоп-слов | 0 / 15 | 15 / 15 |
| Приёмку прошли целиком | 0 / 15 | 11 / 15 |
| Придумали характеристики, которых не было в заказе | 15 / 15 | 7 / 15 |
Короткий запрос не прошёл ни одной проверки ни разу. Это не значит, что тексты вышли плохими: они выглядят складно, и человек принял бы их без возражений. Вот дословное начало первого ответа плеча A: «Отличный товар! Вот карточка, составленная по стандартам маркетплейсов, с акцентами на ключевые преимущества». Дальше идёт заголовок, характеристики маркдауном и ни одного из шести признаков, по которым карточку можно принять машинно.
Что показал провал: где ломается даже хорошее ТЗ
Развёрнутое ТЗ дало не безупречный результат: 11 ответов из 15 прошли приёмку целиком. Провалы легли по двум признакам. Четыре требования из шести выполнены во всех пятнадцати прогонах. Пункт «description от 40 до 60 слов» выполнен в 11: в четырёх ответах описание вышло длиннее потолка — 61, 62, 69 и 77 слов при границе 60. Пункт «Ответ целиком парсится как JSON» выполнен в 14: один ответ пришёл обёрнутым в ```json, тогда как формат требовал «Один объект JSON и ничего вокруг него — без пояснений, без markdown-обёртки». Это тот же ответ, что промахнулся по длине, поэтому приёмку целиком прошли 11 из 15. Два промаха по длине из четырёх — на одно-два слова, и это отдельный сигнал: модель считает слова приблизительно даже тогда, когда вы назвали точный диапазон.
Вот дословный провальный ответ, сокращённый до сути: «Эти наушники обеспечивают комфортное прослушивание музыки и звонков без лишних шумов благодаря технологии ANC. Встроенный аккумулятор поддерживает до 6 часов непрерывной работы… Соединение осуществляется по Bluetooth, что обеспечивает стабильную связь с вашим устройством». Формат, ключи, заголовок и буллеты здесь идеально по заданию; сломалось ровно то, что требует от модели счёта.
Вторая протечка тоньше. Задание прямо запрещало придумывать характеристики, и всё же в развёрнутом плече в 7 ответах из 15 появился Bluetooth, которого в заказе не было. При коротком запросе выдумок было больше и они были крупнее: во всех 15 ответах модель дописала суммарное время работы с зарядным кейсом, в 13 — версию Bluetooth, в 12 — класс защиты от влаги (IPX4 или IPX5). Про кейс задание говорило прямо — «6 часов работы без кейса», — и это модель не остановило. Для карточки маркетплейса такая приписка становится основанием для возврата товара.
Чтобы проверить, что дело не в характере одной модели, тот же прогон повторили на GPT-5-mini — 15 повторов на каждое плечо, те же шесть критериев. Картина совпала. Короткий запрос снова дал 0 из 15 по каждому критерию и 12 ответов из 15 с дописанным Bluetooth. Развёрнутое ТЗ дало 13 из 15, и два провала оказались разной природы. Первый — по длине, и промах на этот раз пришёлся вниз: 37 слов в описании при нижней границе 40. Второй — по синтаксису: модель не закрыла массив буллетов, и пара «description» уехала внутрь списка. Сам текст описания там уложился в диапазон ровно на сорока словах, но принять ответ невозможно: он не разбирается как JSON, а значит, валится по первому же критерию.
Практический вывод один: требования, которые модель обязана посчитать (число слов, число знаков, число пунктов), и запреты на додумывание проверяйте отдельно после каждого прогона. Формат модель держит крепче остального, и всё же на второй модели один ответ из пятнадцати в развёрнутом плече пришёл сломанным — такое ловится машинной проверкой, чтением глазами почти никогда.
Шаблон ТЗ для нейросети, который мы прогоняли
Ниже — тот самый текст задания из плеча B, целиком и без сокращений. Его можно скопировать, заменить предметную часть на свою и получить те же шесть блоков из раздела о структуре. Проверенный на нём результат — в предыдущем разделе.
Контекст. Карточка товара для маркетплейса, категория «наушники».
Читатель — покупатель, который сравнивает 5–10 карточек подряд и решает за 10 секунд.

Задача. Написать карточку для товара: беспроводные наушники TWS,
цена 3 990 ₽, 6 часов работы без кейса, активное шумоподавление ANC.

Формат вывода. Один объект JSON и ничего вокруг него — без пояснений,
без markdown-обёртки. Ровно три ключа:
{"title": "строка", "bullets": ["строка", "строка", "строка"], "description": "строка"}

Ограничения. Ни в одном поле не использовать слова: лучший, уникальный,
инновационный, идеальный, непревзойдённый.
Не придумывать характеристик, которых нет в задаче.

Критерии приёмки (по ним работа принимается или возвращается):
1. Ответ целиком парсится как JSON.
2. Ключей ровно три: title, bullets, description. Других ключей нет.
3. Длина title — не больше 60 символов.
4. В bullets ровно три элемента.
5. Длина description — от 40 до 60 слов.
6. Ни одного слова из списка ограничений ни в одном поле.

Пример корректного ответа по форме (содержание другое):
{"title": "Наушники TWS с ANC, 6 часов автономности",
 "bullets": ["Шумоподавление ANC", "6 часов без кейса", "Цена 3 990 ₽"],
 "description": "<текст на 40–60 слов>"}
Три места в шаблоне переносятся на любую задачу без изменений: строка «и ничего вокруг него» убирает вступительные фразы модели, строка «не придумывать характеристик, которых нет в задаче» закрывает входные данные, нумерованный список приёмки превращает пожелания в проверки. Предметную часть — контекст, факты и схему полей — меняете под себя.
ТЗ на изображение: пример задания на герб из тигра и феникса
Задание на картинку — тот же промпт. Справка GigaChat описывает его как «запрос, который задается модели для генерации текста, изображений, кода или других видов контента». Шесть блоков из раздела о структуре работают и здесь, меняются два: место формата вывода занимает композиция, место машинной проверки — приёмка глазами по списку.
Возьмём типовой заказ: герб, в котором соединены тигр и феникс. Запрос «нарисуй герб с тигром и фениксом» оставляет модели десяток решений, и каждое она примет за вас: сколько на гербе фигур, кто из двоих главный, есть ли щит и какой он формы, какого цвета фон, появится ли на гербе текст. Ниже то же задание, разложенное по блокам.
Контекст. Геральдический знак для настольной игры про два враждующих дома.
Знак печатается на карте 60 × 90 мм и должен читаться с полуметра.

Композиция. Один щит в центре, форма треугольная, «варяжская».
Голова тигра в анфас занимает верхнюю треть щита.
Феникс стоит за щитом: видны расправленные крылья по обе стороны и хвост снизу.
Под щитом лента с девизом PER IGNEM.

Стиль и обработка. Плоская векторная гравюра: контур одной толщины,
заливка двумя тонами, без градиентов, без объёма, без фотореализма.

Палитра. Три цвета: тёмно-синий фон, охра для фигур, белый контур.

Ограничения. Ни короны, ни второго животного, ни дополнительных надписей.
Ни одного элемента за пределами щита и ленты. Фон однотонный, без пейзажа и сцены.

Критерии приёмки (каждый проверяется ответом «да» или «нет»):
1. На изображении ровно две фигуры: тигр и феникс.
2. Голова тигра развёрнута в анфас.
3. Крылья феникса видны позади щита с обеих сторон.
4. Лента с текстом PER IGNEM есть, других надписей на изображении нет.
5. Фон однотонный.
6. Контур одной толщины, градиентов нет.
Приёмка здесь ручная, и от этого критерии важнее, чем в текстовой задаче. Счёт фигур, разворот головы, лишние украшения, надписи на фоне — всё это видно на самой картинке, и замечает это тот, кто заранее написал, что проверяет. Шесть пунктов выше проверяются по изображению подряд, и каждое «нет» превращается в одну правку задания — по одной за раз, иначе непонятно, какая из них подействовала.
Предметная часть меняется, скелет остаётся: контекст и носитель, композиция по объектам, стиль и обработка, палитра, ограничения, критерии приёмки. Тем же способом описывают иллюстрацию к статье, иконку, обложку и раскадровку.
Как задать эффект в задании на изображение
Эффект в задании — это обработка: гравюра, двойная экспозиция, зернистость плёнки, свечение, размытый фон. Эффект живёт отдельной строкой рядом со стилем и формулируется через то, что на картинке видно: строка «контур одной толщины, заливка двумя тонами, без градиентов» проверяема, слово «эффектно» — нет. Когда обработка решает задачу, вынесите её в критерии приёмки отдельным пунктом: тогда ответ «принято» или «переделать» даёт сама картинка.
Тот же порядок работает, когда эффект добавляют к готовому изображению или к кадру видео: сначала назовите обработку словами, которые видно на результате, потом перечислите, чего на кадре быть не должно, и только потом отдавайте задание модели.
ТЗ на разработку ИИ-системы: десять разделов по ГОСТ 34.602-2020
Когда «ТЗ для нейросети» означает документ для подрядчика, который строит ИИ-сервис, промпт-инжиниринг к делу отношения не имеет. Здесь действует межгосударственный стандарт ГОСТ 34.602-2020 «Информационные технологии. Комплекс стандартов на автоматизированные системы. Техническое задание на создание автоматизированной системы». Стандарт введён приказом Росстандарта от 19 ноября 2021 г. № 1522-ст, дата введения — 1 января 2022 г., заменил ГОСТ 34.602-89.
Пункт 4.1 стандарта начинается словами «ТЗ на АС содержит следующие обязательные разделы» и перечисляет десять:
- общие сведения;
- цели и назначение создания автоматизированной системы;
- характеристика объектов автоматизации;
- требования к автоматизированной системе;
- состав и содержание работ по созданию автоматизированной системы;
- порядок разработки автоматизированной системы;
- порядок контроля и приемки автоматизированной системы;
- требования к составу и содержанию работ по подготовке объекта автоматизации к вводу автоматизированной системы в действие;
- требования к документированию;
- источники разработки.
Раздел, ради которого стандарт стоит открыть даже вне госзаказа, — «порядок контроля и приемки автоматизированной системы». Он ставит тот же вопрос, что критерии приёмки в промпте: кто, чем и по какому признаку признаёт работу выполненной. Стандарт отдельно оговаривает, что пустых мест в документе не бывает: «В случае отсутствия требований по разделу, соответствующий раздел сохраняется, и в нем приводится запись об отсутствии требований».
Частые ошибки в ТЗ для нейросети и как их исправить
Пять ошибок ниже встречаются и в коротких промптах, и в развёрнутых ТЗ. Две из них мы поймали на собственном прогоне — их разбор с числами идёт выше.
Нечёткая цель. «Напиши статью о продукте» оставляет модели выбор жанра, объёма и адресата. Рабочая формулировка называет всё три: «обзор продукта для менеджеров по продукту, 700–900 слов, три ключевых преимущества и ограничения, один пример использования».
Формат вывода не задан. Без структуры модель импровизирует и каждый раз по-новому. Если ответ пойдёт в таблицу или в код, описывайте поля и типы прямо схемой. Справка GigaChat описывает для этого отдельный механизм: «Модели GigaChat могут генерировать структурированные данные в соответствии с переданной в запросе JSON-схемой или регулярным выражением», формат задаётся объектом response_format со значением json_schema. В веб-интерфейсе, где параметров API нет, ту же роль играет явное описание схемы словами прямо в задании.
Противоречивые требования. «Коротко» и «полностью раскрыть тему на 2000 слов» в одном задании — модель выберет одно и не сообщит, какое. Расставьте приоритет явно: что важнее при конфликте.
Незакрытые входные данные. Если не сказано «используй только перечисленные характеристики», модель дополнит описание правдоподобными деталями. В нашем прогоне это оказалось самым частым и самым дорогим эффектом слабого задания — подробности в разделе с замером.
Одна команда на всю задачу. Предобработку, генерацию и проверку стоит описывать отдельными шагами: так понятнее, на каком именно шаге результат разошёлся с ожиданием.
Чек-лист: как подготовить техническое задание для нейросети
Последовательность действий при подготовке ТЗ для нейросети — от цели до сохранённой версии. Пункт 6 добавлен после нашего замера: без него остальные семь проверяются на глаз.
- Сформулируйте цель и адресата: кто получит результат и что считается принятой работой.
- Соберите входные данные списком и запретите пользоваться тем, чего в списке нет.
- Опишите формат вывода подробно: поля, типы, длина, структура. Для машинной обработки — схемой.
- Пропишите ограничения: стоп-слова, запреты, границы объёма, требования по безопасности.
- Дайте два-три корректных примера и один некорректный, чтобы обозначить границу допустимого.
- Запишите критерии приёмки пронумерованным списком, где каждый пункт проверяется ответом «да» или «нет».
- Запланируйте итерации: одно уточнение за раз, сначала формат, потом содержание, потом стиль.
- Сохраните итоговое задание как версию и переиспользуйте его на следующей задаче того же типа.
Проверить чек-лист дешевле всего на своей же задаче: возьмите последний запрос, который пришлось переделывать, и посмотрите, какой из восьми пунктов в нём отсутствовал. В коротком запросе из нашего прогона отсутствовали как минимум четыре пункта — 3, 4, 5 и 6: формат вывода, ограничения, примеры и критерии приёмки. Приёмку не прошёл ни один из пятнадцати ответов.
Если хотите разобраться, как модель вообще обрабатывает ваше задание и почему длинные ТЗ ведут себя иначе коротких, посмотрите разбор что такое LLM и как работает большая языковая модель. Готовые формулировки под конкретные задачи собраны в подборке примеров промптов для программистов, а выбор модели под задачу разобран в материале как понять, что за нейросеть перед вами.
Частые вопросы про ТЗ для нейросети
Как называется ТЗ для нейросети одним словом?
Промпт — так это называется. Справка GigaChat определяет промпт как «текстовое описание задачи, которую необходимо выполнить с помощью ИИ-модели» и пишет слово с двумя «п». Навык составлять промпты называется промпт-инжинирингом.
Чем системный промпт отличается от обычного?
Системный промпт задаёт правила на весь диалог и, по описанию справки GigaChat, «можно передать только один раз в самом первом сообщении». Пользовательский промпт несёт конкретную задачу и меняется от сообщения к сообщению. Роль, ограничения и формат ответа логично класть в системный, факты задачи — в пользовательский.
Как называется ТЗ на разработку ИИ-системы?
Техническое задание на создание автоматизированной системы. Форма документа описана в ГОСТ 34.602-2020, который действует с 1 января 2022 года и содержит десять обязательных разделов — от общих сведений до источников разработки.
Обязательно ли писать длинное ТЗ для нейросети?
Нет. Для разовой задачи, результат которой вы оцените глазами, хватит короткого промпта. Развёрнутое задание окупается там, где задача повторяется или результат принимает другой человек: в нашем прогоне слабая постановка не дала ни одного ответа, пригодного к машинной приёмке, — ноль из 15 на каждой из двух моделей.
Что обязательно включить в ТЗ для нейросети?
Шесть блоков: контекст и роль, входные данные, задачу, формат вывода, ограничения и критерии приёмки. Первые четыре собраны по составу системного промпта из справки GigaChat. Шестой блок — пронумерованный список проверок, каждая из которых отвечается «да» или «нет».
Почему нейросеть придумывает характеристики, которых не было в задании?
Потому что задание не закрыло входные данные. В нашем прогоне при слабой постановке все 15 ответов содержали технические характеристики, отсутствовавшие в задаче. Помогает явная строка «не придумывать характеристик, которых нет в задаче» плюс перечисление всех допустимых фактов списком, хотя и она срабатывает не всегда.
Как написать ТЗ на изображение — например, на герб из тигра и феникса?
Теми же шестью блоками, что и для текста, с двумя заменами: вместо формата вывода — композиция, то есть что и где стоит на картинке, вместо машинной проверки — список критериев приёмки, каждый из которых виден глазами. Полный пример задания на герб с тигром и фениксом приведён выше: контекст и носитель, композиция, стиль и обработка, палитра, ограничения и шесть проверок с ответом «да» или «нет».
Как добавить эффект в ТЗ?
Отдельной строкой рядом со стилем, словами, которые видно на результате: «контур одной толщины, заливка двумя тонами, без градиентов» вместо «эффектно». Если обработка решает задачу, продублируйте её отдельным пунктом в критериях приёмки — тогда результат принимается по картинке, а спор о вкусе не начинается.
Что запомнить про ТЗ для нейросети
Задание модели называется промптом, навык его писать — промпт-инжинирингом, а документ на разработку ИИ-системы для подрядчика — техническим заданием на создание автоматизированной системы по ГОСТ 34.602-2020. Три разных предмета, три разных набора правил.
Внутри промпта решает шестой блок. Наш прогон 17 сентября 2026 года показал разницу в числах: короткий запрос дал 0 из 15 ответов, пригодных к приёмке, развёрнутое ТЗ — 11 из 15. Оставшиеся четыре промаха пришлись на требование, которое просит модель считать слова, и один из них вдобавок пришёл в markdown-обёртке. Это ровно то место, где человеку придётся проверять руками.
Дальше полезнее всего сделать одну вещь: взять задачу, которую вы уже ставили модели, дописать к ней пронумерованные критерии приёмки и прогнать пять раз подряд. Число прошедших проверку ответов и будет вашей собственной цифрой — она точнее любого чужого совета, включая этот материал. Подборка рабочих связок «задача — модель» есть в обзоре ИИ для маркетинга: какие нейросети брать и что мерить.