
Qwen3-TTS — открытая серия моделей синтеза речи от команды Qwen: превращает текст в голос, клонирует чужой тембр по короткому образцу и создаёт новый по словесному описанию. Веса выложены 22 января 2026 года под лицензией Apache 2.0, русский входит в список из десяти поддерживаемых языков.
Коротко о главном:
- Серия Qwen3-TTS вышла 22.01.2026 в двух размерах — 0.6B и 1.7B, веса и токенизатор под Apache 2.0.
- Клонирование по 3-секундному образцу — у открытых весов; облачный API просит запись на 10–20 секунд, максимум 60.
- Русский заявлен, но в бенчмарке самих разработчиков он второй с конца из десяти: WER 3,212 против 0,928 у китайского.
- Первый аудиопакет модель отдаёт через ~97 мс после одного символа на входе — отсюда стриминг и голосовые ассистенты.
- Облачный тариф — $0,1 за 10 000 символов входного текста, бесплатная квота 110 000 символов на 90 дней.
Мы прогнали через модель 38 русских фраз и записали, что она с ними сделала: в разделе «Где Qwen3-TTS ломается на русском» есть случай, когда цена потеряла три нуля.
Что такое Qwen3-TTS
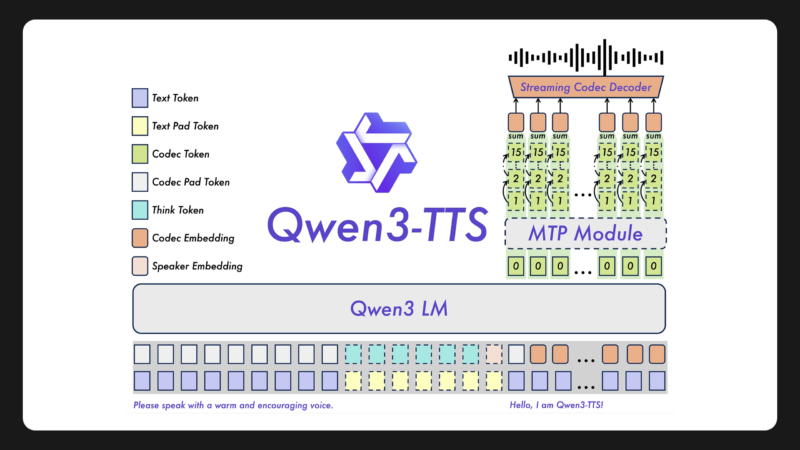
TTS (Text-to-Speech) — технология, превращающая текст в речь. Qwen3-TTS — это не одна модель, а серия из пяти опубликованных чекпойнтов плюс отдельный аудиотокенизатор. Технический отчёт команды описывает обучение более чем на 5 миллионах часов речи на десяти языках и выпуск обеих частей — токенизаторов и моделей — под лицензией Apache 2.0.
Серия закрывает три разные задачи:
- CustomVoice — озвучка готовыми пресетными голосами;
- VoiceDesign — создание нового тембра по словесному описанию;
- Base — клонирование голоса по образцу аудио и дообучение.
Голос здесь можно описать словами, как ставят задачу актёру озвучки. В примерах репозитория инструкция звучит так: «Male, 17 years old, tenor range, gaining confidence — deeper breath support now, though vowels still tighten when nervous».
Из-за чего голос звучит естественно
Естественность держится на собственном аудиотокенизаторе Qwen3-TTS-Tokenizer-12Hz: 16 слоёв кодовых книг на частоте 12,5 Гц вместо грубой нарезки звука. В сравнительной таблице токенизаторов он идёт первой строкой по всем пяти метрикам — PESQ_WB 3,21, PESQ_NB 3,68, STOI 0,96, UTMOS 4,16, SIM 0,95, против 2,88 / 3,42 / 0,94 / 3,87 / 0,87 у ближайшего конкурента Mimi. Технический отчёт уточняет, на чём это считали: «We evaluate speech reconstruction performance on the LibriSpeech test-clean set, which comprises 2,620 utterances».
Пять моделей серии: какую брать под задачу
Репозиторий опубликовал пять чекпойнтов и один токенизатор. Разница между ними не в «качестве вообще», а в том, что каждый умеет.
| Модель | Что делает | Инструкция словами | Вес файла |
|---|---|---|---|
| Qwen3-TTS-12Hz-1.7B-VoiceDesign | создаёт новый тембр по описанию | есть | 3,57 ГиБ |
| Qwen3-TTS-12Hz-1.7B-CustomVoice | озвучка 9 пресетными голосами | есть | 3,57 ГиБ |
| Qwen3-TTS-12Hz-1.7B-Base | клон голоса по 3-секундному образцу | нет | 3,59 ГиБ |
| Qwen3-TTS-12Hz-0.6B-CustomVoice | озвучка 9 пресетными голосами | нет | 1,69 ГиБ |
| Qwen3-TTS-12Hz-0.6B-Base | клон голоса по 3-секундному образцу | нет | 1,70 ГиБ |
| Qwen3-TTS-Tokenizer-12Hz | кодирует и декодирует звук, нужен остальным | — | 0,64 ГиБ |
Деталь, которую легко пропустить: колонка инструкций заполнена только у двух моделей на 1.7B. Хотите задавать эмоцию и темп словами — младшая версия этого не делает. Веса в таблице — фактический размер файла model.safetensors в репозитории на 17.09.2026.
Где Qwen3-TTS ломается на русском: наш прогон
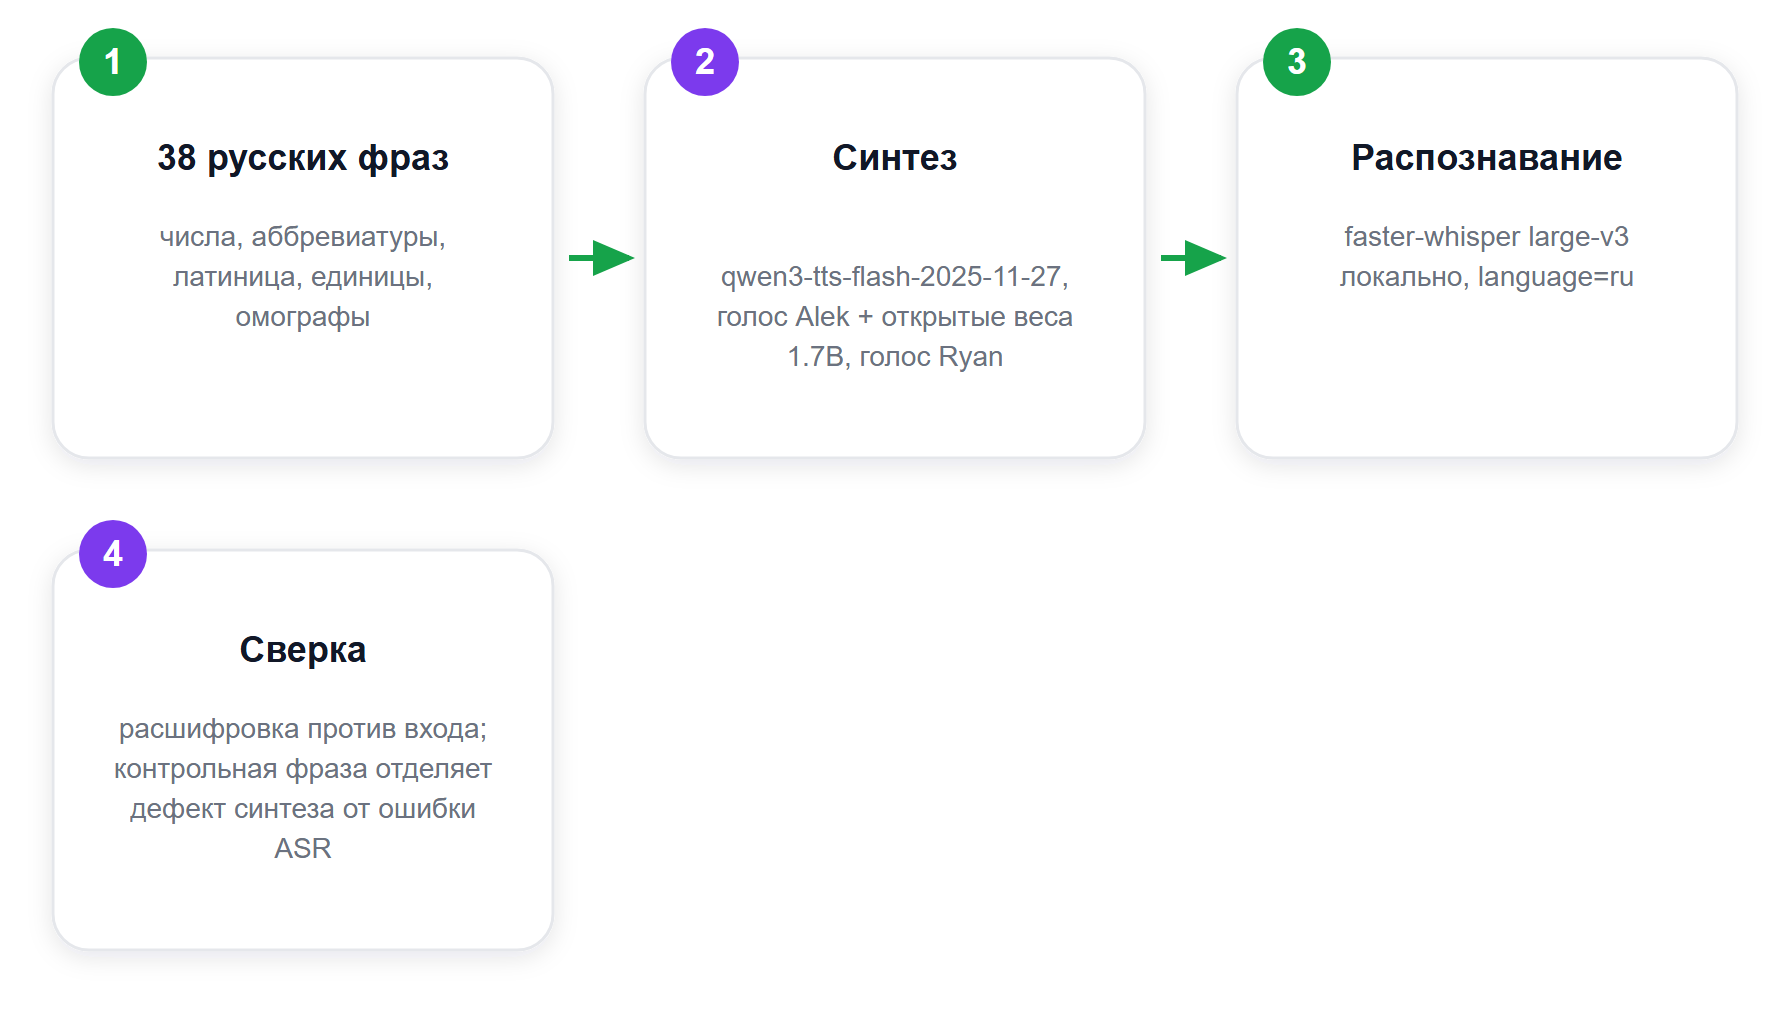
Официальный список языков говорит, что русский поддерживается. Мы решили проверить, что это значит на практике, и 17 сентября 2026 года отправили в модель 38 русских фраз, собранных под конкретные ловушки: числа, аббревиатуры, латиница внутри русского предложения, единицы измерения, омографы.
Методика простая и повторяемая. Синтез — через официальное демо Qwen на Hugging Face (Space Qwen/Qwen3-TTS-Demo), модель в нём заявлена как qwen3-tts-flash-2025-11-27, голос Alek, язык Russian. Полученные 38 файлов (200 секунд звука, 24 кГц моно) мы распознали локально моделью faster-whisper large-v3 и сравнили расшифровку с тем, что подавали на вход. Там, где расшифровка расходится со входом, а контрольный вариант той же фразы читается верно, дефект лежит в синтезе.
Дефект первый: пробел в разряде числа съедает тысячи
Самый дорогой результат прогона. Одно и то же предложение, три записи числа, один голос:
| Что подали на синтез | Что услышали в расшифровке |
|---|---|
| Бюджет проекта — двести пятьдесят тысяч рублей. | Бюджет проекта 250 тысяч рублей. |
| Бюджет проекта — 250000 рублей. | Бюджет проекта 250 тысяч рублей. |
| Бюджет проекта — 250 000 рублей. | Бюджет проекта 250 рублей. |
Отличие между строками — один пробел. И именно на нём «250 000 рублей» прозвучало как «250 рублей»: сумма упала в тысячу раз. Тот же класс на больших числах: «5 000 000 часов» превратилось в «5.00 часов» — три раза из трёх прогонов, а «1 000 000 рублей» в «1.00 рублей». При этом «15 900 рублей» модель прочла верно: рушится не любой пробел, а группа из трёх нулей после него.
Вывод для практики: в тексте на озвучку разряды пишите слитно или словами. Русская типографика ставит в разрядах пробел по умолчанию — значит любая цена, скопированная из прайса, поедет.
Дефект второй: латинская аббревиатура рядом ломает кириллическую
Короткая фраза «Считаем НДС и звоним в МТС» расшифровалась дословно — обе аббревиатуры на месте. Стоит добавить в то же предложение латинское слово, и русские буквы начинают читаться на английский лад:
| Что подали на синтез | Что услышали в расшифровке |
|---|---|
| Подключается через интерфейс, НДС 22 процента. | Подключается через интерфейс НДС 22%. |
| Подключается через API, НДС 22 процента. | Подключается через API NDS 22%. |
Предложения отличаются одним словом, и «НДС» после «API» становится «NDS». В длинной фразе с той же латиницей эффект усиливается: «ИИ-озвучка от МТС и СБЕР подключается через API, НДС 22 процента» вернулось как «И озвучка от Neptune CSBR подключается через API NDS 22%». Обход тот же: в контроле «эм-тэ-эс» и «эн-дэ-эс» через дефис читаются правильно.
Дефект третий: приставка «ИИ-» теряет одну букву
Конструкция «ИИ-озвучка» в трёх прогонах из трёх прозвучала как «И озвучка» — одна буква вместо двух. Для русскоязычного ИИ-контента это системная мина: слово «ИИ» стоит в каждом втором заголовке.
Дефект четвёртый: имя самого продукта и сокращения единиц
Фраза «Открой GitHub и скачай Qwen3-TTS» вернулась как «Открой GitHub и скачай Quantry TTS». Название модели ни в одном прогоне не прозвучало как «Квен»: расшифровка давала то «Quantry», то «Quantum». «GitHub» при этом читается верно через раз — с голосом Alek он один раз стал «Getup», с голосом Cherry прочитался нормально.
Сокращения единиц идут следом. «Задержка 97 мс и 12 Гц» вернулось как «Задержка 97 муэмс и 12 гетц». Контрольный вариант «Задержка 97 миллисекунд, частота токенизатора 12,5 герца» распознался дословно.
Что прошло чисто
Омографы модель развела верно: «Мы объехали старинный замок и повесили замок на дверь» вернулось слово в слово. Кавычки, тире, восклицательный знак и «не так ли?» тоже отработали без потерь. Расстановку ударений этот метод не проверяет — расшифровка ударения не передаёт, и мы такого утверждения не делаем.
Открытые веса на русском отработали хуже облачных
Те же фразы мы отправили в демо открытых весов (Space Qwen/Qwen3-TTS, модель Qwen3-TTS-12Hz-1.7B-CustomVoice на видеокарте A10G, язык Russian). Успели пройти три фразы — дальше упёрлись в квоту бесплатного GPU, и это само по себе ограничение метода: наблюдений всего три.
Результат заметно грязнее облачного. «Годовая подписка стоит 15 900 рублей, месячная — 1 590 рублей» вернулось как «…месячные и цена пеценности рублей», а «Бюджет проекта — 250 000 рублей» дало «Бюджет проекта. 250.0 рублей. Фомант Мэй Нэмити» — модель договорила фразу звуком, которого во входе не было.
Причина скорее всего в голосе. У открытых весов всего девять пресетных тембров, и ни один из них не русский: пять китайских, два английских, японский и корейский. Мы брали Ryan — английский. В облачном списке голосов Qwen-TTS их 48, все 48 заявлены с поддержкой русского, и среди них есть Alek с описанием «Cold like the Russian spirit, yet warm like wool coat lining». Для русской озвучки на открытых весах это значит: либо мириться с чужим акцентом, либо клонировать свой голос через Base-модель.
Скорость тоже разошлась. Полный круг «запрос → готовый файл» в облаке занял от 1,81 до 4,55 секунды при медиане 2,71 на шестнадцати замеренных фразах, те же три фразы на открытых весах — 9,64, 12,20 и 13,12 секунды. Заявленные 97 мс относятся к первому аудиопакету; готовый файл приходит позже, это разные величины.
Что говорит официальный бенчмарк про русский
Свои замеры разработчики публикуют в репозитории, и русский там на виду. В таблице многоязычного синтеза у старшей базовой версии, Qwen3-TTS-12Hz-1.7B-Base, по русскому выходит WER 3,212 — второй результат с конца среди десяти языков, хуже только японский (3,823). Для сравнения, китайский в той же строке — 0,928, то есть русский отстаёт в 3,46 раза.
Против конкурентов на русском картина обратная: та же модель (3,212) обходит и ElevenLabs (3,878), и MiniMax (4,281), а по схожести голоса идёт впереди обоих — 0,792 против 0,761 и 0,676. По всем десяти языкам она лучше MiniMax по WER на семи языках из десяти и выше по схожести голоса на всех десяти.
То есть русский у Qwen3-TTS трудный не относительно рынка, а относительно остальных языков самой модели. Планируя озвучку на русском, закладывайте вычитку — расшифровка нашего прогона показывает, где именно она понадобится.
0.6B или 1.7B: какую версию брать
Это второй по частоте вопрос после «а русский есть». Ответ складывается из трёх измеримых вещей.
По качеству русского. В бенчмарке разработчиков Qwen3-TTS-12Hz-0.6B-Base даёт по русскому WER 4,458, старшая 1.7B-Base — 3,212. Разница в 1,39 раза в пользу старшей. По схожести голоса версии почти равны: 0,781 против 0,792.
По возможностям. Управление эмоцией и темпом через словесную инструкцию заявлено только у моделей на 1.7B. Модель VoiceDesign, которая рисует новый тембр по описанию, существует вообще в единственном размере — 1.7B.
По месту на диске. Файл весов 1.7B-CustomVoice занимает 3,57 ГиБ, версия 0.6B — 1,69 ГиБ. К любой из них обязательно добавляется токенизатор на 0,64 ГиБ: без него модель не работает. Итого 4,21 ГиБ против 2,33 ГиБ только на файлы, без учёта памяти под активации и служебные буферы. Карта на 4 ГБ старшую версию не потянет физически — файлы туда не помещаются.
Вывод: 0.6B — когда нужна озвучка готовым голосом на слабом железе. 1.7B — когда нужны эмоции инструкцией, дизайн тембра или лучший русский.
Что вы можете делать с Qwen3-TTS
1. Клонировать голос
Открытым весам достаточно 3 секунд аудио с текстовой расшифровкой. Облачный сервис строже: справка Model Studio просит запись на 10–20 секунд, максимум 60, из них минимум 3 секунды непрерывной чистой речи, паузы внутри — не длиннее 2 секунд. Кросс-языковое клонирование работает: голос, записанный по-русски, говорит по-английски, сохраняя индивидуальность. В облачном аккаунте можно держать до 1 000 своих голосов.
2. Создать голос с нуля
Модель VoiceDesign строит новый тембр по описанию персонажа. Ограничение, которое ломает планы русскоязычных команд: в облачном API само описание голоса (параметр voice_prompt) принимается только на китайском и английском, а его длина у моделей Qwen-TTS ограничена 2 048 символами. Описывать голос по-русски там нельзя, хотя озвучиваемый текст может быть русским.
3. Управлять эмоциями
Злость, ирония, шёпот, ускорение речи задаются той же словесной инструкцией, причём динамически: в начале спокойно, к концу эмоционально. Инструкции понимают только модели на 1.7B.
4. Делать диалоги между персонажами
Несколько сохранённых тембров работают в длинном диалоге. Репозиторий описывает рабочую связку: сделать эталонную реплику моделью VoiceDesign, собрать из неё многоразовый промпт через create_voice_clone_prompt и дальше генерировать реплики, не пересчитывая признаки голоса. Это то, что нужно для сторителлинга и обучающих симуляторов, где персонаж звучит одинаково от сцены к сцене.
Сколько времени занимает генерация
Qwen3-TTS использует Dual-Track архитектуру. Первый аудиофрагмент появляется после обработки одного символа текста, задержка до первого пакета — около 97 мс. Отсюда голосовые ассистенты и переводчики реального времени. Полный файл в нашем прогоне приходил за 2,71 секунды по медиане.
Поддержка языков
В официальном списке десять языков. Русский стоит в нём наравне с китайским и английским, дальше идут немецкий, испанский, итальянский, португальский, французский, японский и корейский; внутри китайского есть ещё и диалектные голоса. Русский поддерживается всеми пятью опубликованными моделями серии, а в облачном списке голосов Qwen-TTS он заявлен у всех 48 тембров.
Отдельно репозиторий отмечает у моделей заметно улучшенную устойчивость к зашумлённому входному тексту (в оригинале — markedly improved robustness to noisy input text). Наш прогон подтверждает это частично: кавычки, тире и знаки препинания модель переварила, а пробел внутри числа и латиницу рядом с кириллицей — нет.
Как попробовать Qwen3-TTS: простой гайд
Способ 1. Демо в браузере, без установки
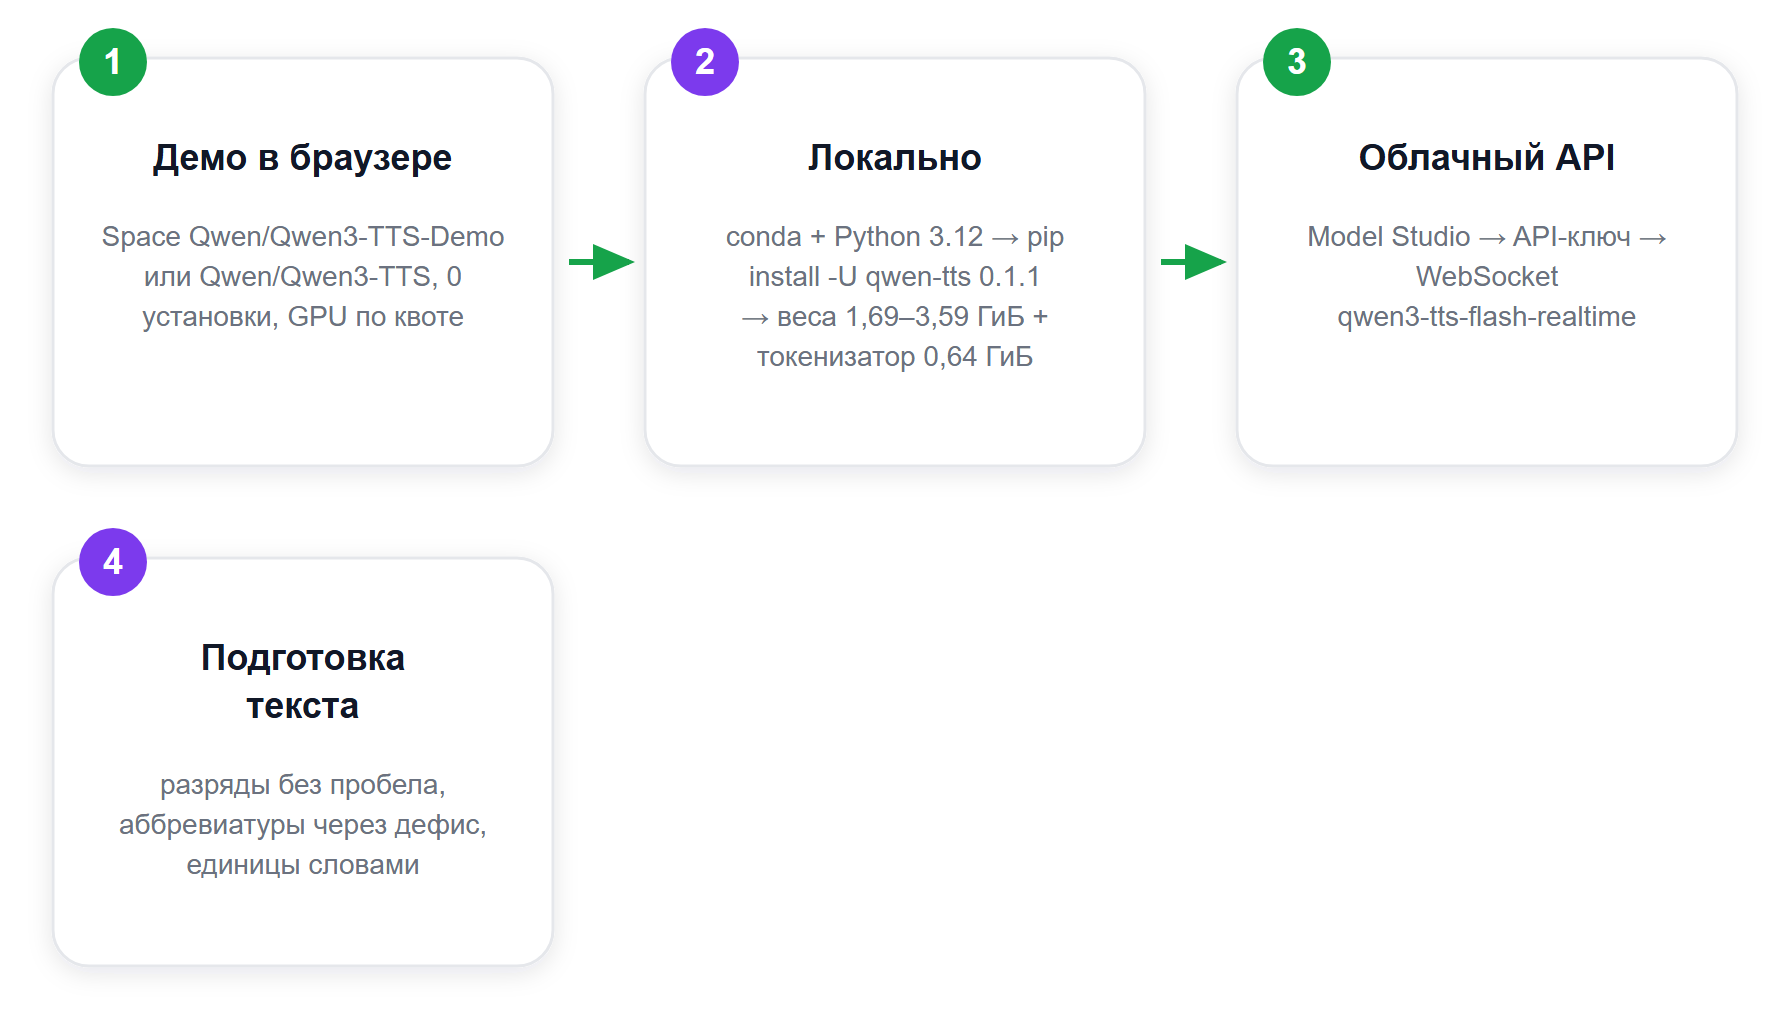
Официальные демо Qwen на Hugging Face: Space Qwen/Qwen3-TTS-Demo работает на облачной модели и даёт выбор голоса и языка, Space Qwen/Qwen3-TTS запускает открытые веса на GPU и позволяет переключать 0.6B и 1.7B и загружать свой референс для клонирования. Бесплатный GPU выдаётся по квоте: у нас она закончилась после трёх генераций.
Способ 2. Локальная установка
Порядок шагов взят из официального репозитория Qwen3-TTS:
- Создайте изолированное окружение — в инструкции это conda с Python 3.12.
- Поставьте пакет: pip install -U qwen-tts. Актуальная версия в PyPI — 0.1.1 от 6 февраля 2026 года, требуется Python 3.9 и выше.
- Скачайте веса нужной модели и токенизатор через huggingface-cli или modelscope.
- Запустите веб-интерфейс командой qwen-tts-demo с именем модели либо вызовите класс Qwen3TTSModel из Python.
- Для клонирования голоса поднимайте демо по HTTPS: иначе браузер не отдаст доступ к микрофону.
Репозиторий дополнительно советует FlashAttention 2 для экономии видеопамяти, а при оперативной памяти меньше 96 ГБ ставить его с ограничением MAX_JOBS=4. Офлайн-вывод через vLLM-Omni тоже работает; онлайн-режим там пока не поддержан.
Способ 3. Через облачный API
Для продакшена без своей видеокарты есть DashScope в Alibaba Cloud Model Studio. Регистрируете аккаунт, получаете API-ключ и подключаетесь к нужной модели по WebSocket. В справке realtime перечислены свои идентификаторы: qwen3-tts-flash-realtime для готовых голосов, qwen3-tts-vc-realtime-2026-01-15 для клонирования, qwen3-tts-vd-realtime-2026-01-15 для дизайна тембра. Имена без «realtime» — qwen3-tts-vc-2026-01-22 и qwen3-tts-vd-2026-01-26 — в справке realtime не значатся: их вызывают обычным POST на dashscope-intl.aliyuncs.com, и в таблице цен ниже стоят именно они. На выходе — PCM, WAV, MP3 или Opus с частотой дискретизации до 48 кГц.
Сколько это стоит
Тарификация считается по символам входного текста, аудио на выходе не тарифицируется отдельно. Цены со страницы биллинга Model Studio на 17.09.2026, сингапурский регион:
| Модель | Цена за 10 000 символов | Бесплатная квота |
|---|---|---|
| qwen3-tts-flash (= flash-2025-11-27) | $0,1 | 110 000 символов |
| qwen3-tts-vc-2026-01-22 (клонирование) | $0,115 | 110 000 символов |
| qwen3-tts-vd-2026-01-26 (дизайн голоса) | $0,115 | 110 000 символов |
| qwen3-tts-instruct-flash-2026-01-26 | $0,115 | 10 000 символов |
Бесплатная квота действует 90 дней с момента активации сервиса, релиза модели или одобрения заявки — что наступит позже. Отдельно справка предупреждает: бесплатная квота есть только в сингапурском регионе, в остальных её нет. В китайском регионе те же модели стоят $0,114682–0,115 за 10 000 символов без бесплатного пакета.
Перевести символы в часы помогает наш же прогон: 1 795 символов русского текста дали 175 секунд звука, то есть около 10,25 символа на секунду речи. По этой мерке бесплатные 110 000 символов — примерно 3 часа озвучки, а час речи сверх квоты стоит около $0,37. Оговорка: мы мерили на коротких фразах, у каждой есть тишина в начале и конце, на длинных текстах символов в секунду выйдет больше, а цена часа — ниже.
Где это можно применить в России
Озвучка Telegram-каналов и статей блога, автоматическая генерация подкастов, голосовые помощники для бизнеса, локализация контента на десять языков одним голосом, онлайн-образование, диджитал-аватары для маркетинга. Открытая лицензия Apache 2.0 снимает главный барьер: модель ставится на свой сервер, и тексты не уходят во внешний сервис.
Для смежных задач посмотрите, что умеет Wispr Flow, а для сравнения с русскоязычными сервисами озвучки — разбор Speechify: тарифы и голоса на русском. Если планируете зарабатывать на озвучке, пригодится материал про заработок на начитке аудиокниг.
Чем Qwen3-TTS отличается от других решений
С закрытыми сервисами вроде ElevenLabs Qwen3-TTS расходится в модели доступа: веса лежат открыто, ставятся локально и не требуют платы за каждый символ. В бенчмарке разработчиков по русскому Qwen3-TTS-12Hz-1.7B-Base опережает ElevenLabs по разборчивости (WER 3,212 против 3,878) и по схожести голоса (0,792 против 0,676). С MiniMax сопоставление такое же: 3,212 против 4,281 по русскому и преимущество по схожести голоса на всех десяти языках. Подробнее о платформе — в разборе MiniMax.
Оговорка обязательна: это замер самой команды Qwen на своих тестовых наборах, независимого арбитра здесь нет.
Ограничения, о которых стоит знать заранее
- Числа с пробелом в разряде. В нашем прогоне «250 000 рублей» прозвучало как «250 рублей». Пишите разряды слитно или словами.
- Кириллические аббревиатуры рядом с латиницей. «НДС» после «API» читается как «NDS». Разбивка дефисом («эн-дэ-эс») лечит.
- Приставка «ИИ-». Три раза из трёх прозвучала как одна буква «И».
- Сокращения единиц. «97 мс» превратилось в «97 муэмс». Расшифровывайте единицы словами.
- Нет русского пресетного голоса в открытых весах. Девять тембров, ни одного русского: либо чужой акцент, либо клонирование своего голоса.
- Инструкции для дизайна голоса. В облачном API текст инструкции принимается только на китайском и английском.
- Бесплатная квота облака — только сингапурский регион, и она ограничена 90 днями.
Частые вопросы
Qwen3-TTS бесплатная?
Веса всех пяти моделей и токенизатора опубликованы под лицензией Apache 2.0 — их можно скачать и запускать у себя бесплатно, включая коммерческое использование. Платить придётся только за облачный API: $0,1 за 10 000 символов входного текста у модели qwen3-tts-flash, с бесплатной квотой 110 000 символов на 90 дней в сингапурском регионе.
Qwen3-TTS работает с русским языком?
Да, русский входит в официальный список десяти поддерживаемых языков и заявлен у всех пяти опубликованных моделей. Но в бенчмарке разработчиков русский — второй с конца по разборчивости: WER 3,212 против 0,928 у китайского. В нашем прогоне 17.09.2026 модель устойчиво ошибалась на числах с пробелом в разряде, аббревиатурах рядом с латиницей и сокращениях единиц измерения.
Какая версия Qwen3-TTS лучше работает с русским: 0.6B или 1.7B?
1.7B. По русскому языку в бенчмарке разработчиков она даёт WER 3,212 против 4,458 у 0.6B — разница в 1,39 раза. Кроме того, управление подачей через словесную инструкцию и модель дизайна голоса доступны только на 1.7B. Цена вопроса — 3,57 ГиБ весов против 1,69 ГиБ, плюс 0,64 ГиБ токенизатора в обоих случаях.
Сколько аудио нужно для клонирования голоса?
Открытым моделям Base достаточно 3 секунд образца вместе с текстовой расшифровкой. Облачный Model Studio требует больше: 10–20 секунд рекомендуемых, 60 максимум, из них минимум 3 секунды непрерывной чистой речи, паузы внутри — не длиннее 2 секунд, без музыки и посторонних голосов.
Сколько весит Qwen3-TTS и какая нужна видеокарта?
Файл весов 1.7B-CustomVoice — 3,57 ГиБ, версия 0.6B — 1,69 ГиБ, обязательный токенизатор — ещё 0,64 ГиБ. Итого 4,21 и 2,33 ГиБ только на файлы, без памяти под вычисления. На карту с 4 ГБ видеопамяти старшая версия не помещается физически.
Итог
Qwen3-TTS — шаг к тому, чтобы голос стал программируемым интерфейсом: открытая лицензия, десять языков, клонирование по короткому образцу, управление подачей обычными словами. Русский здесь рабочий, но требует внимания: числа, аббревиатуры и латиницу в тексте на озвучку придётся готовить руками. Зато готовить их нужно один раз — дальше конвейер работает сам.