Содержание
- Что такое галлюцинация нейросети
- Почему нейросеть выдумывает ответ
- Наш прогон: пять ассистентов, пять вопросов, 29 адресов источников
- Ошибки и галлюцинации: кто врёт чаще?
- Скорость или смысл?
- Контекст и персонализация
- Манипуляции и реклама: кто тобой управляет?
- Для чего подходит лучше?
- Как проверить ответ нейросети за две минуты
- Чего ожидать?
- Частые вопросы
- Вывод
Нейросеть против Google: кто лучше отвечает на вопросы?

Черновик готовит редакция с помощью ИИ. За стандарт издания отвечает главный редактор — Валерий Курземнек.
Галлюцинация нейросети — это создание ложной информации, которая звучит как факт. Модель не отключается от перегрева и не притворяется человеком: она достраивает правдоподобный текст там, где знания нет, и подаёт догадку тем же ровным уверенным тоном, что и проверенный ответ. Ошибку не видно по форме — видно только по проверке.
Ситуация знакома каждому, кто пользовался чат-ботом: вы задаёте нейросети вопрос, она выдаёт красивый, уверенный и абсолютно выдуманный ответ. В мире ИИ это называется галлюцинацией, и смысл этого явления сводится к одному — модель порождает ложную информацию, неотличимую по форме от факта.
Коротко о том, что дальше:
- галлюцинация — уверенная выдумка; перегрев процессора и «усталость» модели от долгого обучения тут ни при чём;
- механизм простой: языковая модель предсказывает следующее слово, и на вопросе без знания угадывание даёт более высокую оценку, чем ответ «не знаю»;
- 17 сентября 2026 года мы задали одни и те же пять вопросов пяти ассистентам и проверили каждый названный ими адрес источника: из 29 названных адресов открылся 21, четыре отдали 404;
- все четыре мёртвых адреса выпали на один вопрос — тот, где ассистента просили дать ссылку на определение галлюцинации;
- поисковик выдумать адрес не может: он показывает то, что видел в индексе. Зато он не отвечает на вопрос — он показывает, где искать ответ.
Материал обновлён 17 сентября 2026 года.
Что такое галлюцинация нейросети
Галлюцинация нейросети — это уверенный ответ, который не опирается ни на данные обучения, ни на реальность. В мире ИИ галлюцинацией называется именно порождение ложной информации в форме факта: выдуманная цитата, несуществующая статья, ссылка на страницу, которой нет, число, взятое из ниоткуда. Отказ оборудования и техническая ошибка этим словом не называются.
Русская Википедия в статье «Галлюцинация (искусственный интеллект)» определяет явление так: «уверенная реакция системы искусственного интеллекта, не соответствующая исходным данным, на которых проводилось её обучение; вымышленные ответы системы, не имеющие отношения к действительности». Справочник «Лаборатории Касперского» формулирует близко: «Галлюцинация ИИ — это ситуация, когда инструмент с искусственным интеллектом выдает неточный, вводящий в заблуждение или несогласованный вывод из-за того, что его алгоритмы находят шаблоны в данных, которые не существуют, или неправильно интерпретируют эти шаблоны».
Ключевое слово в обоих определениях — «уверенная». Галлюцинация отличается от обычной ошибки не содержанием, а подачей: текст остаётся связным, грамотным и спокойным. Именно поэтому её тяжело поймать на глаз — форма ответа одинакова и когда модель знает, и когда догадывается.
Почему нейросеть выдумывает ответ
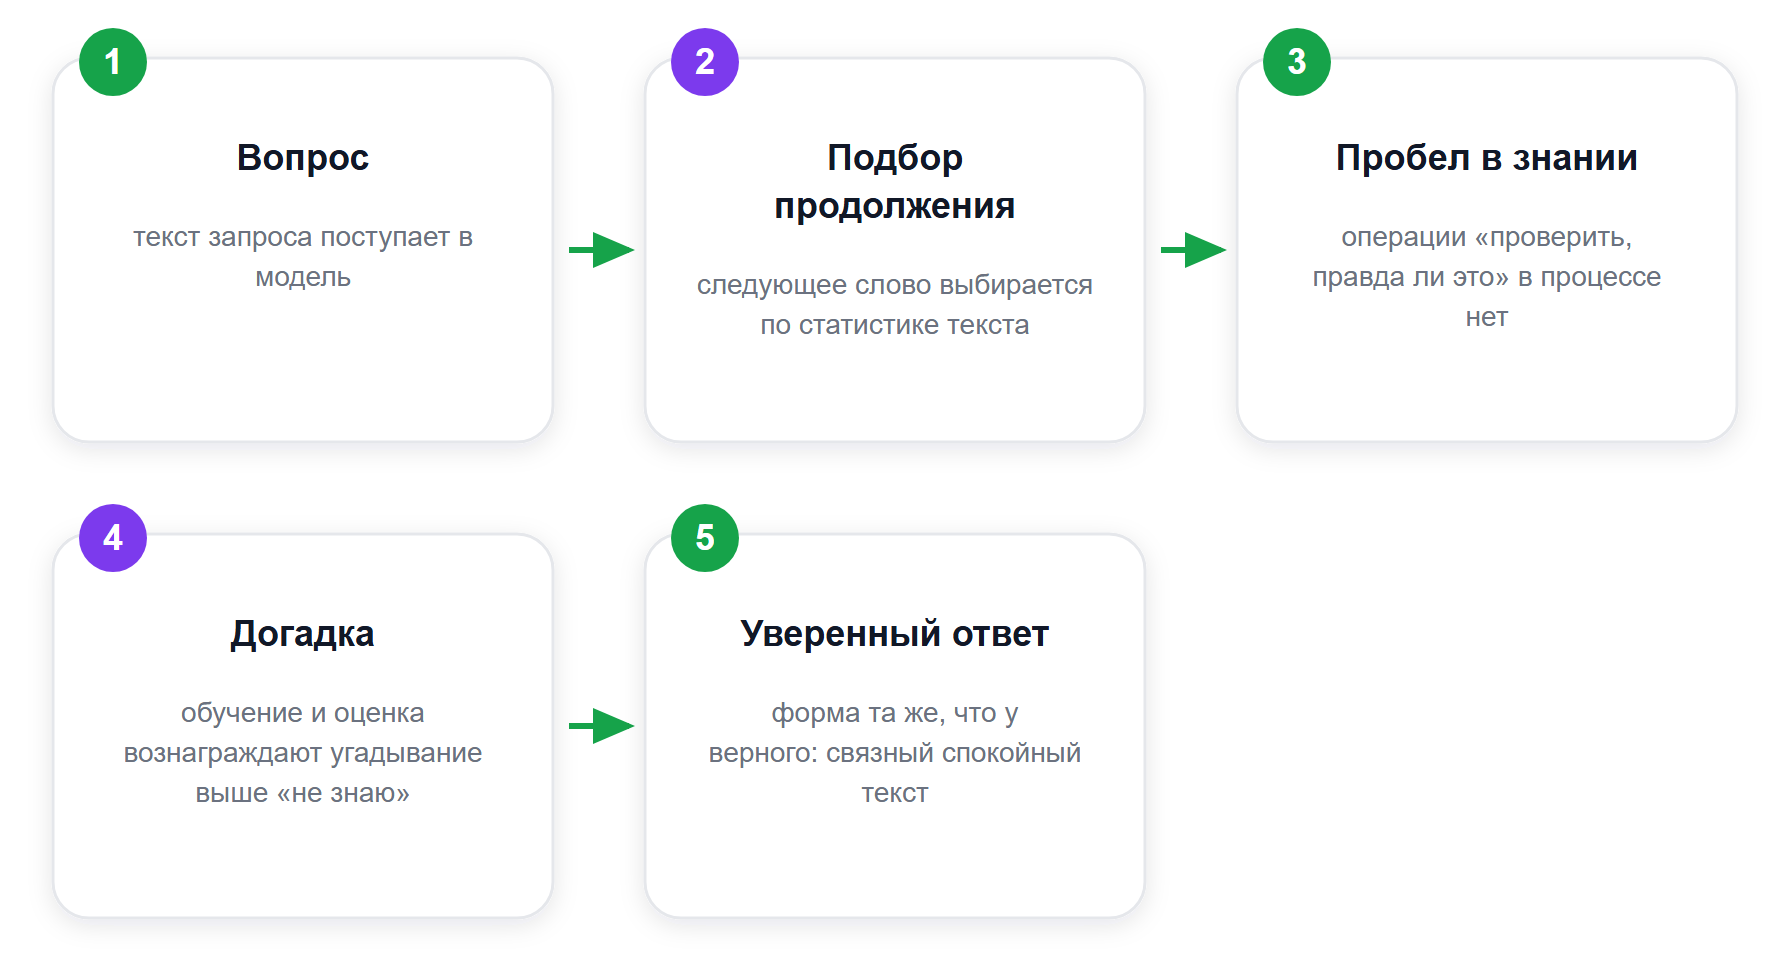
Языковая модель устроена как машина продолжения текста. Она получает вопрос и подбирает следующее слово, которое статистически лучше всего продолжает начатое — и так до конца ответа. Внутри этого процесса нет отдельной операции «проверить, правда ли это»: правдоподобность и правдивость для модели измеряются одним и тем же способом.
Отсюда первое следствие: у модели нет естественного состояния «я не знаю». Пустота в знании выглядит для неё так же, как любое другое место, где нужно подобрать продолжение. Вопрос про несуществующую статью выглядит ровно как вопрос про существующую, и ответ строится по той же схеме.
Второе следствие тоньше и объясняет, почему явление не исчезает с ростом моделей. Препринт «Why Language Models Hallucinate» (Adam Tauman Kalai, Ofir Nachum, Santosh S. Vempala, Edwin Zhang), опубликованный на arXiv 4 сентября 2025 года, формулирует причину так: «We argue that language models hallucinate because the training and evaluation procedures reward guessing over acknowledging uncertainty» — модели галлюцинируют, потому что процедуры обучения и оценки вознаграждают угадывание выше признания неуверенности. И там же: «language models are optimized to be good test-takers, and guessing when uncertain improves test performance» — модель оптимизирована быть хорошим экзаменуемым, а на экзамене догадка приносит больше баллов, чем пустая строка. Полный текст препринта доступен свободно.
Сравнение авторы берут школьное, оно стоит первой строкой аннотации: «Like students facing hard exam questions, large language models sometimes guess when uncertain, producing plausible yet incorrect statements instead of admitting uncertainty» — как студенты на трудных экзаменационных вопросах, большие языковые модели иногда угадывают, когда не уверены, и выдают правдоподобные, но неверные утверждения вместо признания неуверенности. Пока способ оценивания штрафует «не знаю» наравне с неверным ответом, выгодная стратегия — уверенно угадать.
Третий источник — граница знания по дате. Модель обучена на данных до какого-то момента и о более поздних событиях сведений не имеет. В нашем прогоне это видно дословно: на вопрос про курс доллара mistral-large-2512 написал «на данный момент (июнь 2024 года)», хотя запрос уходил 17 сентября 2026 года. Модель уверенно назвала не ту дату, в которой находилась.
Мини-вывод: галлюцинация — штатный режим работы механизма предсказания. Поломки в этот момент нет, и уверенный тон о качестве ответа не сообщает ничего.
Наш прогон: пять ассистентов, пять вопросов, 29 адресов источников
Спор «нейросеть против Google» обычно ведут на примерах. Мы сделали замер. 17 сентября 2026 года мы задали одни и те же пять вопросов пяти моделям через API OpenRouter обычным запросом, без подключённого веб-поиска, с температурой 0. Модели: openai/gpt-4o-mini, google/gemini-2.5-flash, deepseek/deepseek-chat-v3.1, anthropic/claude-haiku-4.5, mistralai/mistral-large-2512 — идентификаторы даны так, как они называются в API. Что за модели стоят за этими именами, мы разбирали отдельно — например, в материале про DeepSeek.
Каждый вопрос заканчивался одинаковым требованием: «Назови точный URL страницы-источника». Проверять ответ так проще всего: адрес либо открывается, либо нет, и это видно машине. Всего получилось 25 ответов, в них названо 29 адресов. Каждый адрес мы открыли запросом curl с браузерным User-Agent и записали код ответа.
Итог: из 29 названных адресов открылся 21, четыре отдали 404, три вернули 403 (домен openai.com закрыт для нашего клиента — существует страница или нет, этой проверкой не установлено), один адрес не ответил вовсе.
| Вопрос | Названо адресов | Открылись (200) | 404 | Остальное |
|---|---|---|---|---|
| Курс доллара ЦБ на 17.09.2026 | 7 | 6 | 0 | 1 — нет ответа сервера |
| Что означает HTTP 418 и в каком RFC описан | 6 | 6 | 0 | 0 |
| День публичного запуска ChatGPT | 3 | 0 | 0 | 3 — код 403 у openai.com |
| Авторы и год статьи «Attention Is All You Need» | 6 | 6 | 0 | 0 |
| Определение галлюцинации нейросети | 7 | 3 | 4 | 0 |
| Итого | 29 | 21 | 4 | 4 |
Все четыре мёртвых адреса выпали на последний вопрос — тот самый, где ассистента просили дать ссылку на определение галлюцинации. Вот они дословно: research.google/blog/learning-to-reduce-hallucinations-in-neural-dialogue-systems-via-probing-the-future (назвал deepseek-chat-v3.1), ai.google.dev/gemini-api/docs/safety-guidance/hallucinations, research.ibm.com/blog/what-are-ai-hallucinations и technologyreview.com/2022/06/13/1053863/ai-large-language-models-hallucinations (все три — mistral-large-2512). Адреса собраны из правильных доменов, правильных разделов и правдоподобных слов. Ни один из четырёх не открывается.
Живая ссылка не означает верный ответ
Второй результат прогона интереснее первого. На вопросе об авторах статьи «Attention Is All You Need» модель gpt-4o-mini ответила дословно так: «Статья «Attention Is All You Need» была написана авторами Васвани, А., Шарки, Н., Нагаржан, А., и другими. Она была опубликована в 2017 году». Адрес источника она дала верный — arxiv.org/abs/1706.03762, страница открывается. На этой странице авторы перечислены полностью: Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, Illia Polosukhin. Фамилий «Шарки» и «Нагаржан» среди них нет.
То есть проверка адреса ловит не всё. Ссылка живая, домен авторитетный, год верный, первая фамилия верная — и посреди этого стоят два человека, которых не существует. Остальные четыре модели на том же вопросе назвали всех восьмерых авторов; у claude-haiku-4.5 имя последнего записано как «Ilya» вместо «Illia».
Для сравнения мы измерили ту же величину у поиска. Выдача Яндекса по запросу «галлюцинации нейросетей что это» дала 11 адресов, и все 11 открылись. Это следует из устройства: поисковик показывает документы, которые он видел в индексе, поэтому выдумать несуществующую страницу он не может в принципе. Цена этого свойства — он и не отвечает на вопрос, он показывает, где ответ искать.
Что этот замер не доказывает
Прогон один, моделей пять, вопросов пять. Отсюда не следует доля мёртвых ссылок «у нейросетей вообще» — следует ровно то, что в один день на одном наборе вопросов четыре из 29 названных адресов оказались несуществующими, и все четыре пришлись на один и тот же вопрос из пяти. Отдельная оговорка про два кода: 403 у openai.com и отсутствие ответа у economy.gov.ru означают, что до страницы не добрался наш клиент; существует ли она, этой проверкой не установлено. Мёртвыми мы считаем только те четыре, что вернули честный 404.
Счёт в плюс моделям тоже есть. На вопрос про курс доллара на 17 сентября 2026 года ни одна из пяти не назвала число — все пять ответили, что данных на эту дату у них нет. Дату публичного запуска ChatGPT все пятеро назвали одинаково: 30 ноября 2022 года. Уверенная выдумка появилась там, где вопрос требовал точного адреса на узкую тему.
Ошибки и галлюцинации: кто врёт чаще?
Google ошибается редко и запутанно. Сам поисковик ничего не утверждает — он показывает, что утверждают другие. Ссылки ведут на страницы, где факты перемешаны с мнениями, рекламой и SEO-хитростями; отличить исследование от блога копирайтера должен читатель. Задача поисковика — показать документ, проверка правды в неё не входит.
Нейросеть ошибается иначе: она говорит как эксперт даже там, где факты выдуманы. Это и есть галлюцинация — логично звучащий текст без опоры. Модель может сослаться на несуществующую статью, привести цитату, которой никто не произносил, или собрать адрес источника из правдоподобных кусков, как вышло в нашем прогоне.
Частоту этого явления измеряют публично. Открытый рейтинг Hallucination Leaderboard компании Vectara проверяет узкую вещь: модели дают документ и просят его пересказать, после чего считают, в какой доле пересказов появились утверждения, которых в исходном документе нет. Оценивает не человек, а модель-детектор HHEM-2.3. В срезе, обновлённом 11 мая 2026 года, перечислено 105 моделей, и доля таких пересказов растянута от 1,8% у antgroup/finix_s1_32b до 24,2% у mistralai/ministral-3-3b-2512. У google/gemini-2.5-flash-lite — 3,3%, у deepseek-ai/DeepSeek-V3.2-Exp — 5,3%. Таблица обновляется публично.
Цифры стоит читать буквально. Это доля не «лжи вообще», а добавленных утверждений в задаче, где исходник у модели прямо перед глазами и придумывать нечего. Свободный ответ на вопрос без источника — условия заведомо тяжелее. Поэтому даже первая строка рейтинга не даёт права доверять ответу без проверки: она говорит лишь, что на простой задаче пересказа лучшая модель среза добавила отсебятину в 1,8% случаев.
Так кто опаснее — поисковик, который заваливает ссылками и не помечает, где фейк, или нейросеть, которая подаёт фейк в форме готового ответа? Разница в том, как выглядит ошибка. У поисковика она лежит на чужой странице и обычно пахнет: рекламный тон, отсутствие даты, странный домен. У модели ошибка выглядит как всё остальное в её ответе — спокойный абзац без единого признака сомнения.
Скорость или смысл?
Google отвечает списком. За доли секунды он подбирает страницы по ключевым словам, ссылкам и поведению пользователей — и отдаёт их пачкой. Знание в этой пачке есть, но работа по его извлечению остаётся человеку: открыть, сравнить, отсечь рекламные тексты и пересказы пересказов. Формула поисковика простая: вот всё, что нашлось, дальше сам.
Нейросеть отвечает текстом. Один ответ, уже собранный и структурированный: за ту же секунду человек получает готовую мысль вместо тысячи мнений. Иногда точную. Иногда с ошибкой, поданной так же гладко. Разница между инструментами не в объёме знаний, а в том, кто делает работу по сборке ответа — и вместе с этой работой к модели переезжает ответственность за верность деталей, которую она нести не умеет.
Отсюда практическое правило: скорость без источника — это просто поток текста. Смысл без источника — риск доверия. Если цена ошибки высокая (деньги, право, здоровье, публичный документ), выигрывает связка: спросить у модели формулировку и структуру, а факты и числа добрать поиском.
Контекст и персонализация
Google отвечает всем примерно одинаково. Он опирается на ключевые слова, регион и историю запросов, но он не помнит предыдущую реплику и не знает, кем человек работает и что уже понял. Сила поисковика — масштаб; слабость — отсутствие контекста разговора.
Нейросеть ведёт диалог. Она подхватывает тему, уточняет, переспрашивает, держит нить внутри переписки и подстраивает уровень объяснения: одно и то же можно получить языком инженера или языком шестиклассника. Это меняет качество работы с непонятным материалом — можно спрашивать «а теперь то же самое, только проще» сколько угодно раз.
У такой подстройки есть обратная сторона, заметная по нашему прогону. Модель подстраивается под форму запроса: попросили назвать точный URL — она назвала точный URL, потому что об этом попросили. Требование конкретики модель читает как требование выдать конкретику, и уверенность ответа растёт быстрее, чем его обоснованность.
Манипуляции и реклама: кто тобой управляет?
Поиск живёт на рекламе, и это видно глазами. Платные места в выдаче помечены как реклама и стоят отдельным блоком; остальная выдача отсортирована алгоритмом, под который написана заметная часть страниц рунета. Читатель получает смесь: полезный материал, коммерческий текст под видом экспертного и статью, написанную ради ключевых слов. Влияние здесь открытое — его можно распознать по разметке и по тону.
Нейросеть страницу ответа не продаёт: баннеров, всплывающих окон и партнёрских вставок в ней пока нет. Зато у неё есть встроенные предпочтения, которых не видно вовсе. Модель воспроизводит то, что чаще встречалось в обучающих данных, и то, что её создатели закрепили настройкой поведения. Какой инструмент она назовёт первым в списке «лучших», какую точку зрения изложит как основную, какую тему обойдёт — всё это решено до вопроса пользователя и ярлыком не помечено.
Отсюда разница в способе защиты. От рекламы в поиске защищает внимание к разметке: увидел пометку — сделал поправку. От перекоса модели защищает только внешняя проверка: спросить то же самое у второй модели, запросить источник, открыть источник. Прогон выше показывает, зачем последний шаг нужен буквально: ответ выглядел одинаково убедительно и там, где адрес открывался, и там, где отдавал 404.
Умение формулировать запрос так, чтобы модель реже уходила в догадки, выросло в отдельную профессию — про неё у нас есть текст про промт-инженера.
Для чего подходит лучше?
Выигрывает тот, кто пользуется обоими инструментами по назначению. Это разные помощники с разными зонами силы, и ошибка обычно одна — применять их вслепую.
Когда лучше использовать Google:
- когда важна актуальность: новости, события, тренды, обновления;
- когда нужен точный факт, дата, цитата — и нужно видеть источник;
- когда нужно сравнить характеристики, цены, отзывы, рейтинги;
- когда нужны ссылки на надёжные сайты или первоисточники;
- когда важно общественное мнение — форумы, комментарии, публикации.
Когда эффективнее использовать нейросеть:
- когда нужно объяснение — понятный разбор вместо сухого факта;
- когда важны структура и логика без перегруза информацией;
- когда нужно переформулировать, перевести, адаптировать под уровень понимания;
- когда нужны идеи, варианты, черновики — от писем до концептов;
- когда нужен диалог: уточнение, продолжение мысли, разбор своего текста.
Та же развилка в виде таблицы:
| Задача | Поиск | Нейросеть | Почему так |
|---|---|---|---|
| Узнать свежую цифру (курс, цена, дата события) | Да | Нет | У модели есть граница знания по дате обучения |
| Найти первоисточник и убедиться, что он существует | Да | Нет | В нашем прогоне 4 из 29 названных адресов отдали 404 |
| Понять сложную тему на своём уровне | Нет | Да | Модель объясняет с нужной глубиной и отвечает на уточнения |
| Собрать черновик текста, письма, плана | Нет | Да | Поиск не порождает текст под задачу |
| Сравнить характеристики товаров и цены | Да | Осторожно | Числа требуют сверки с карточкой продавца |
| Переписать и сократить свой текст | Нет | Да | Исходник у модели перед глазами, выдумывать нечего |
| Юридический, медицинский, финансовый вопрос | Да | Только черновик | Цена ошибки выше стоимости проверки |
В сухом остатке: поиск даёт доступ к источникам, нейросеть даёт собранный смысл. Реальный выбор проходит между слепым доверием к любому уверенному тексту и осознанной работой с обоими инструментами.
Как проверить ответ нейросети за две минуты
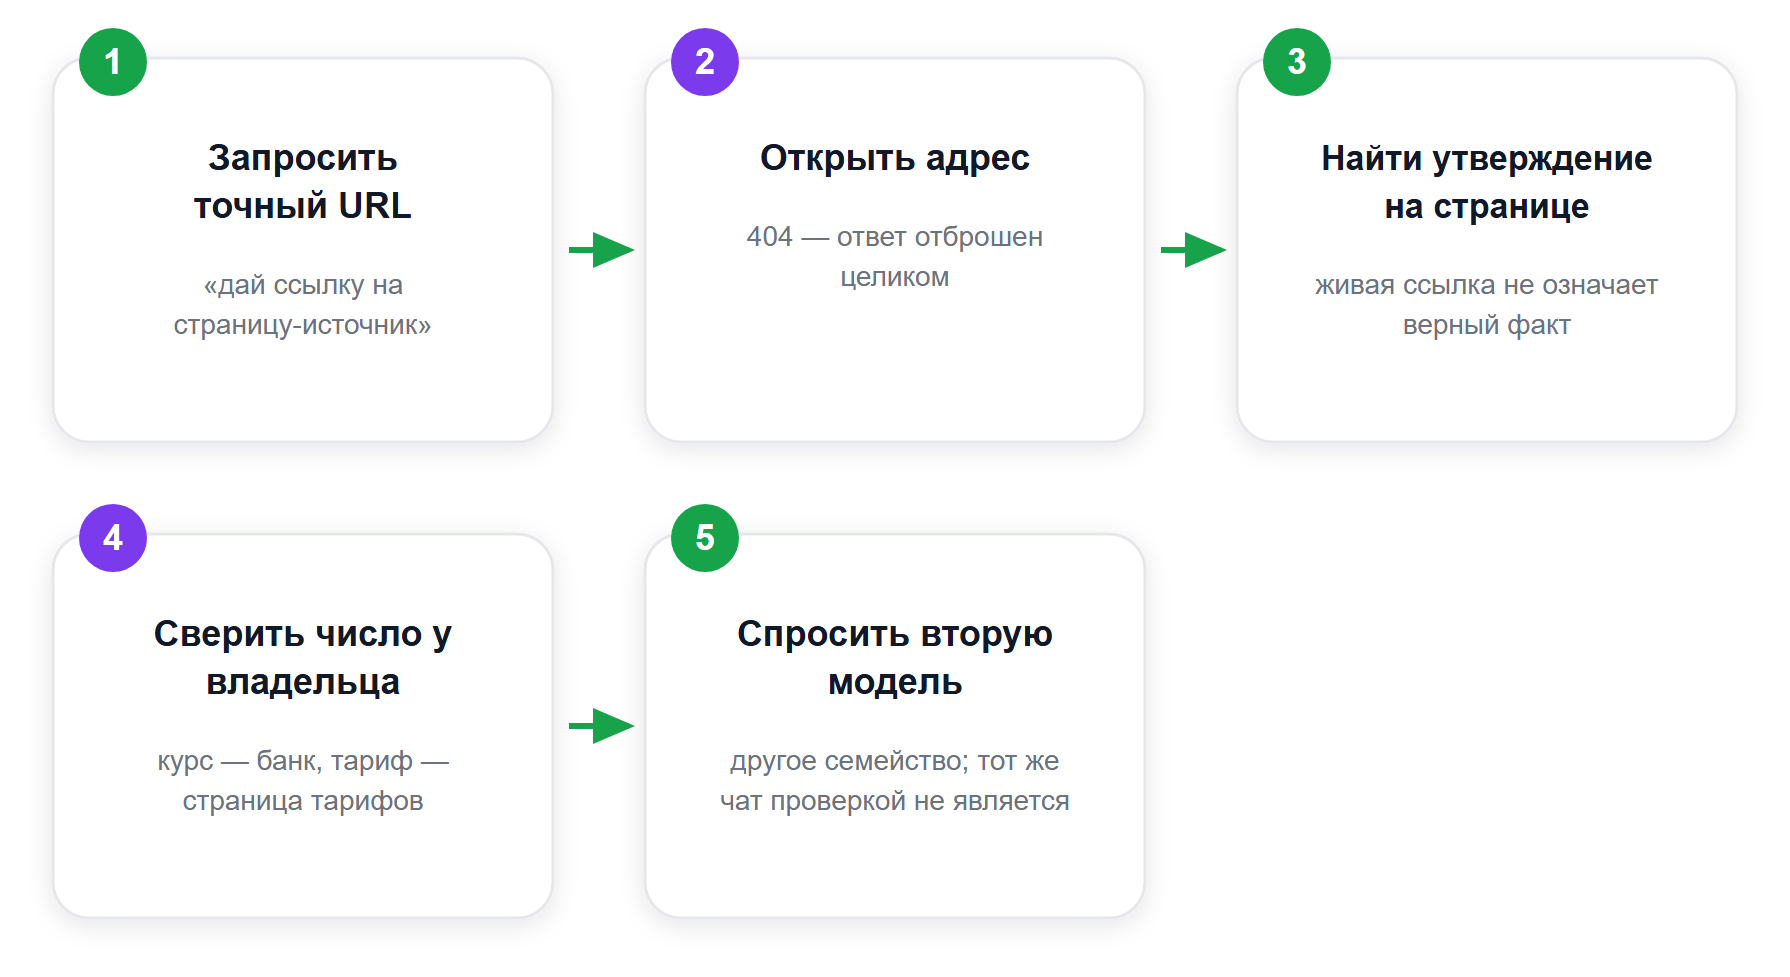
Порядок проверки короткий, и он ловит большую часть выдумок. Первые три шага — ровно то, что мы делали со своим прогоном.
- Попросить источник и открыть его. Не «откуда это известно», а «дай точный URL». Нерабочий адрес отсекает ответ сразу: в нашем замере так отсеклись четыре адреса из 29.
- Найти утверждение на самой странице. Живая ссылка ничего не гарантирует. Модель gpt-4o-mini дала верный адрес arxiv.org/abs/1706.03762 и выдумала двух авторов, которых на этой странице нет. Поиск по странице занимает пять секунд.
- Задать тот же вопрос второй модели из другого семейства. Повторный вопрос той же модели проверкой не является: она воспроизведёт свою же догадку тем же механизмом. Расхождение двух независимых ответов — сигнал остановиться. Для быстрой сверки годится любой доступный чат, вплоть до карманной версии ChatGPT без регистрации.
- Числа и даты сверять у владельца числа. Курс — на сайте банка, тариф — на странице тарифов, закон — в правовой базе. Модель в этих местах опирается на данные до даты обучения.
- Разрешить «не знаю» прямо в запросе. Формулировка «если не уверен, напиши, что не знаешь» снижает давление угадывания, которое описано в препринте выше. Из нашего прогона видно, что модели этим пользуются: на вопросе про курс доллара на будущую дату ни одна из пяти число не назвала.
- Давать модели исходник. Пересказ приложенного документа — задача, где выдумывать нечего: в рейтинге Vectara доля пересказов с добавленными утверждениями лежит между 1,8% и 24,2% в зависимости от модели. Свободный ответ по памяти и таких рамок не имеет.
Отдельный маркер риска: чем уже тема и чем точнее требуемая деталь, тем выше шанс выдумки. Общий вопрос «что такое галлюцинация» все пять моделей закрыли верно. Вопрос «дай ссылку на страницу, где это определение опубликовано» дал четыре мёртвых адреса из семи названных.
Мини-вывод: проверка занимает меньше времени, чем исправление последствий. Один открытый источник и один контрольный вопрос другой модели закрывают почти всё, что можно поймать без специальных инструментов.
Чего ожидать?
Противостояние «поиск против нейросети» заканчивается слиянием. Генеративный ответ переехал внутрь самой выдачи: справка Google описывает функцию под названием «Обзоры от ИИ» словами «Обзоры от ИИ в результатах поиска помогут быстрее находить то, что вам нужно» и тут же предупреждает: «В ответах искусственного интеллекта могут быть ошибки». Предупреждение стоит на странице справки самого поисковика, и это лучший комментарий к спору о доверии.
Для читателя это означает смену привычки. Раньше уверенный текст без ссылок встречался в чате, а выдача выглядела списком адресов. Теперь сгенерированный абзац стоит первым экраном там, где годами стоял список, и выглядит как часть поиска. Навык различения переехал с уровня «каким сервисом я пользуюсь» на уровень «что именно я сейчас читаю — документ или пересказ документа».
Второе изменение касается наших чисел. Прогон 17 сентября 2026 года сделан на моделях без подключённого веб-поиска, и мёртвые адреса в нём — чистая работа памяти модели. Там, где ассистент ходит в интернет сам, адрес он берёт с открытой страницы, и проверять приходится другое — верно ли он эту страницу пересказал. Задача не исчезает, она меняет форму.
Третье — практическое. Инструменты сближаются по интерфейсу, поэтому единственное, что отличает полезный ответ от красивого, находится вне интерфейса: открытый источник, второе мнение, сверка числа у того, кому это число принадлежит. Через год кнопки будут другими, а порядок проверки останется тем же.
Частые вопросы
Что такое галлюцинация нейросети простыми словами?
Галлюцинация нейросети — это создание ложной информации, которая звучит как факт. Модель выдаёт связный, грамотный и уверенный текст, но описанного в нём события, источника или числа не существует. По форме ответа отличить галлюцинацию от знания нельзя, поэтому её ловят только проверкой источника.
Галлюцинация — это перегрев процессора или сбой настроек?
Нет. Перегрев, отключение оборудования и «усталость» модели от слишком долгого обучения к галлюцинации отношения не имеют. Языковая модель предсказывает следующее слово по статистике текста, и там, где знания нет, она подбирает правдоподобное продолжение. Это штатная работа механизма предсказания; поломки устройства в этот момент нет.
Почему нейросеть отвечает уверенно даже тогда, когда ошибается?
Потому что уверенность в ответе задана способом обучения. Препринт «Why Language Models Hallucinate» (arXiv, 4 сентября 2025 года) объясняет это так: процедуры обучения и оценки вознаграждают угадывание выше признания неуверенности, а модель оптимизирована быть хорошим экзаменуемым. На экзамене догадка приносит баллы чаще, чем пустой бланк.
Можно ли доверять ссылкам, которые даёт нейросеть?
Ссылку нужно открывать. 17 сентября 2026 года мы задали пять вопросов пяти моделям и проверили каждый названный ими адрес источника: из 29 адресов открылся 21, четыре отдали 404. Все четыре мёртвых адреса пришлись на один вопрос — просьбу дать ссылку на определение галлюцинации.
Кто отвечает точнее: Google или нейросеть?
Точнее в фактах — поиск, понятнее в объяснениях — нейросеть. Поисковик показывает документы, которые видел в индексе, поэтому несуществующую страницу он выдать не может; зато готового ответа он не даёт. Нейросеть собирает ответ сама и вместе с ним берёт на себя детали, за верность которых не отвечает.
Как быстро проверить ответ нейросети?
Запросить точный URL источника, открыть его и найти на странице то самое утверждение. Числа и даты сверить у владельца числа: курс — на сайте банка, тариф — на странице тарифов. Спорный ответ задать второй модели из другого семейства; повторный вопрос той же модели проверкой не является.
Вывод
Google даёт выбор — иногда слишком большой. Нейросеть даёт один ответ — собранный, понятный и ровно настолько верный, насколько повезло. Первый инструмент требует времени на разбор, второй требует привычки проверять. Оба заводят не туда, если пользоваться ими вслепую.
Галлюцинация — не экзотика и не редкий сбой: это следствие того, как устроено предсказание текста. Она исчезнет не раньше, чем изменится способ оценивать модели, — и об этом прямо говорит препринт, на который мы ссылались выше. Значит, на горизонте ближайших лет навык проверки останется частью работы с любым ассистентом.
Практический итог из нашего замера короткий. Уверенный тон не сообщает ничего. Названный источник сообщает кое-что. Открытый источник, на странице которого нашлось нужное утверждение, сообщает всё. Между этими тремя состояниями и проходит граница между знанием и красивым текстом.