
Обновлено: август 2026. Материал редакции Зерокодера.
ChatGPT написан на Python: в открытых репозиториях OpenAI на него приходится наибольшая доля кода, тяжёлые слои вынесены в C и C++. Алгоритм — трансформер плюс настройка на человеческих оценках. Многоязычность OpenAI меряет на 14 языках. Как обучить чат GPT на своих данных — задача, которая решается без вмешательства в саму модель.
Четыре уточнения, без которых ответы выше читаются неверно:
- Исходники самого ChatGPT закрыты. Публично проверяемы только открытые репозитории OpenAI — gpt-oss, gpt-2, tiktoken, whisper. На них и опирается весь дальнейший разбор языка и инструментов; внутренняя кодовая база продукта публично не документирована.
- «Написан на Python» описывает исследовательский код. Численные ядра и инференс на устройствах живут в C, C++ и Metal — в репозитории gpt-oss на них суммарно приходится 53,4 % байт против 40,3 % у Python.
- Алгоритм ChatGPT собирается из четырёх стадий. Архитектура-трансформер, предобучение на предсказание следующего токена, настройка на демонстрациях и ранжировании ответов живыми разметчиками и — у моделей 2026 года — скрытое рассуждение перед ответом. Третью стадию OpenAI описала сама в статье про InstructGPT.
- Русского нет в официальном многоязычном бенчмарке OpenAI. Набор MMMLU переведён профессиональными переводчиками на 14 языков, русский в этот список не входит.
На каком языке программирования написан ChatGPT
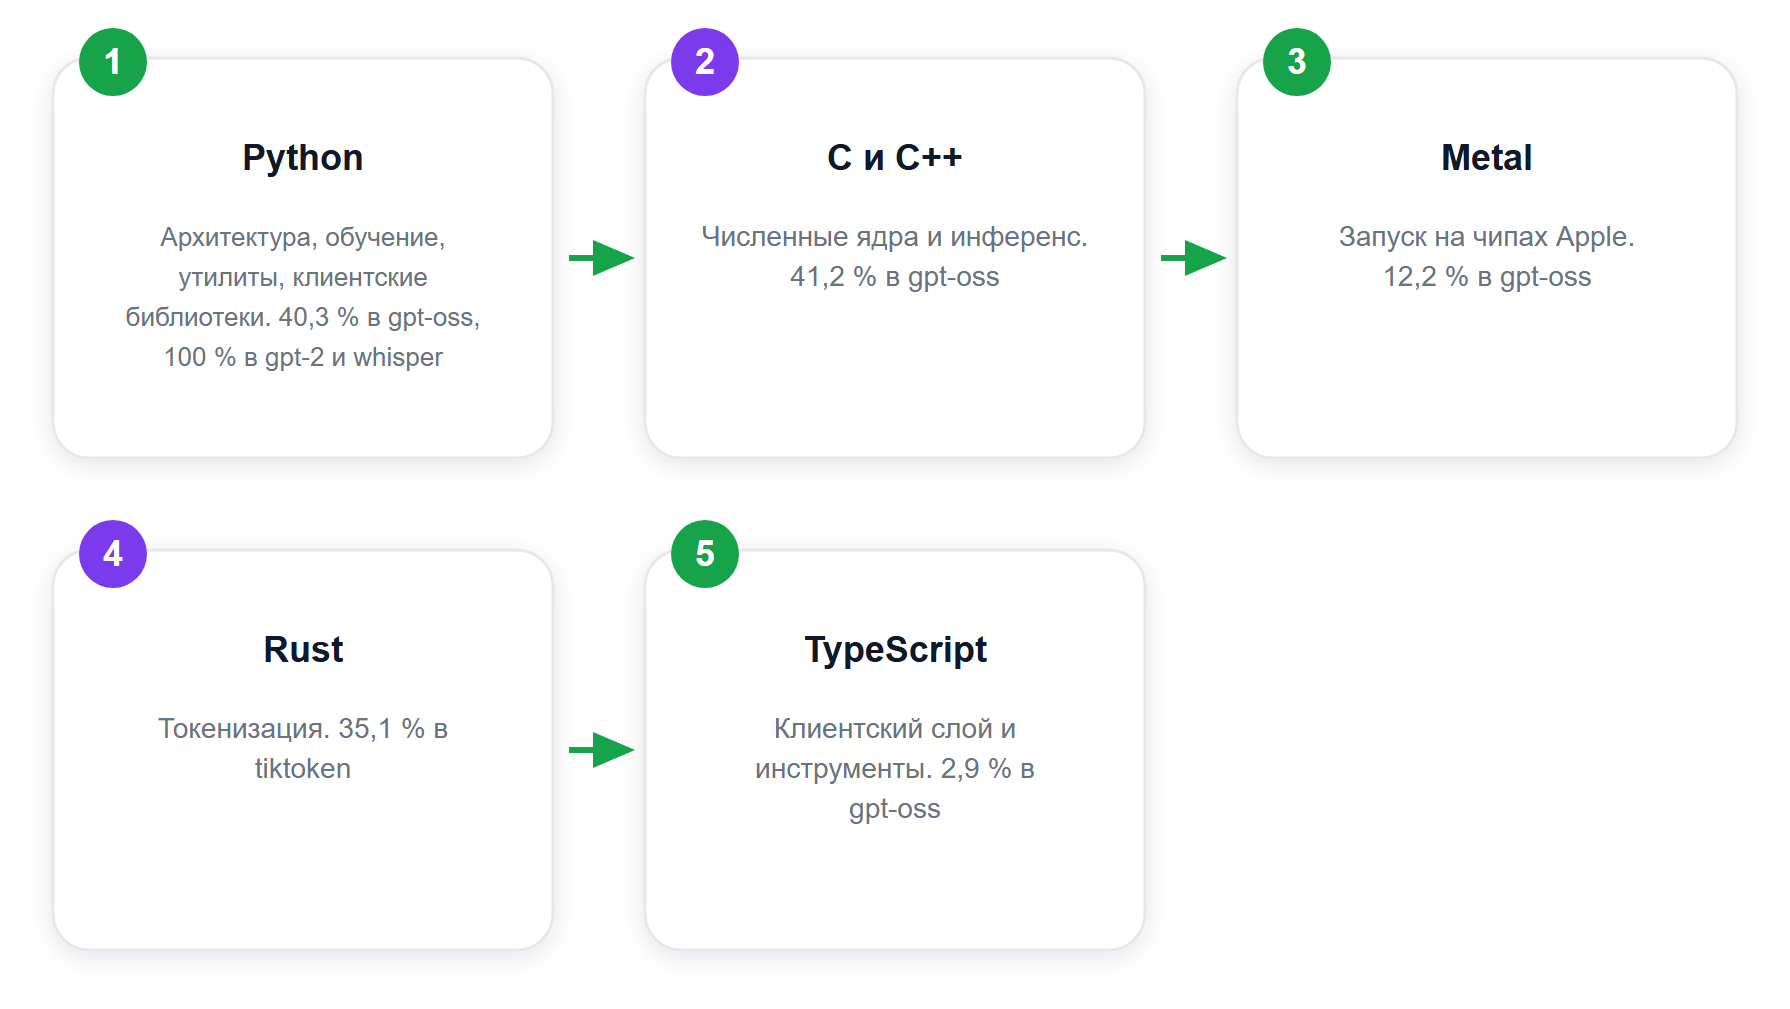
Прямого ответа «вот репозиторий ChatGPT, смотрите сами» не существует: код продукта закрыт. Зато у OpenAI открыто несколько проектов того же круга, и GitHub считает в них доли языков автоматически, по объёму байт. Цифры ниже сняты через API GitHub 17 августа 2026 года.
| Открытый проект OpenAI | Что это | Доли языков по данным GitHub |
|---|---|---|
| gpt-oss | Открытые модели gpt-oss-120b и gpt-oss-20b под лицензией Apache 2.0 | Python 40,3 %, C 27,9 %, C++ 13,3 %, Metal 12,2 %, TypeScript 2,9 %, Objective-C 2,1 %, CMake 1,3 % |
| gpt-2 | Модель GPT-2, выложенная целиком | Python 100 % |
| tiktoken | Токенизатор, который режет текст на токены перед подачей в модель | Python 64,9 %, Rust 35,1 % |
| whisper | Распознавание речи | Python 100 % |
| openai-python | Клиентская библиотека для обращения к API | Python 99,9 % |
Картина повторяется от проекта к проекту. Python держит верхний слой: описание архитектуры, обучение, инференс, утилиты. Всё, где важна скорость, уходит вниз — в C, C++, Rust и Metal. В gpt-oss на низкоуровневые языки приходится больше половины кода, потому что там лежат три эталонные реализации запуска модели: на PyTorch, на Triton и на Metal под чипы Apple.
Отсюда практический вывод для тех, кто собирается работать с ChatGPT. Знание C и CUDA пригодится, если вы пишете свой инференс-движок. Для всего остального — интеграции, подготовки данных, ботов — достаточно Python.
Python — язык, на котором ChatGPT описан. C и C++ — языки, на которых он быстро считается.
Какой алгоритм используется для обучения ChatGPT
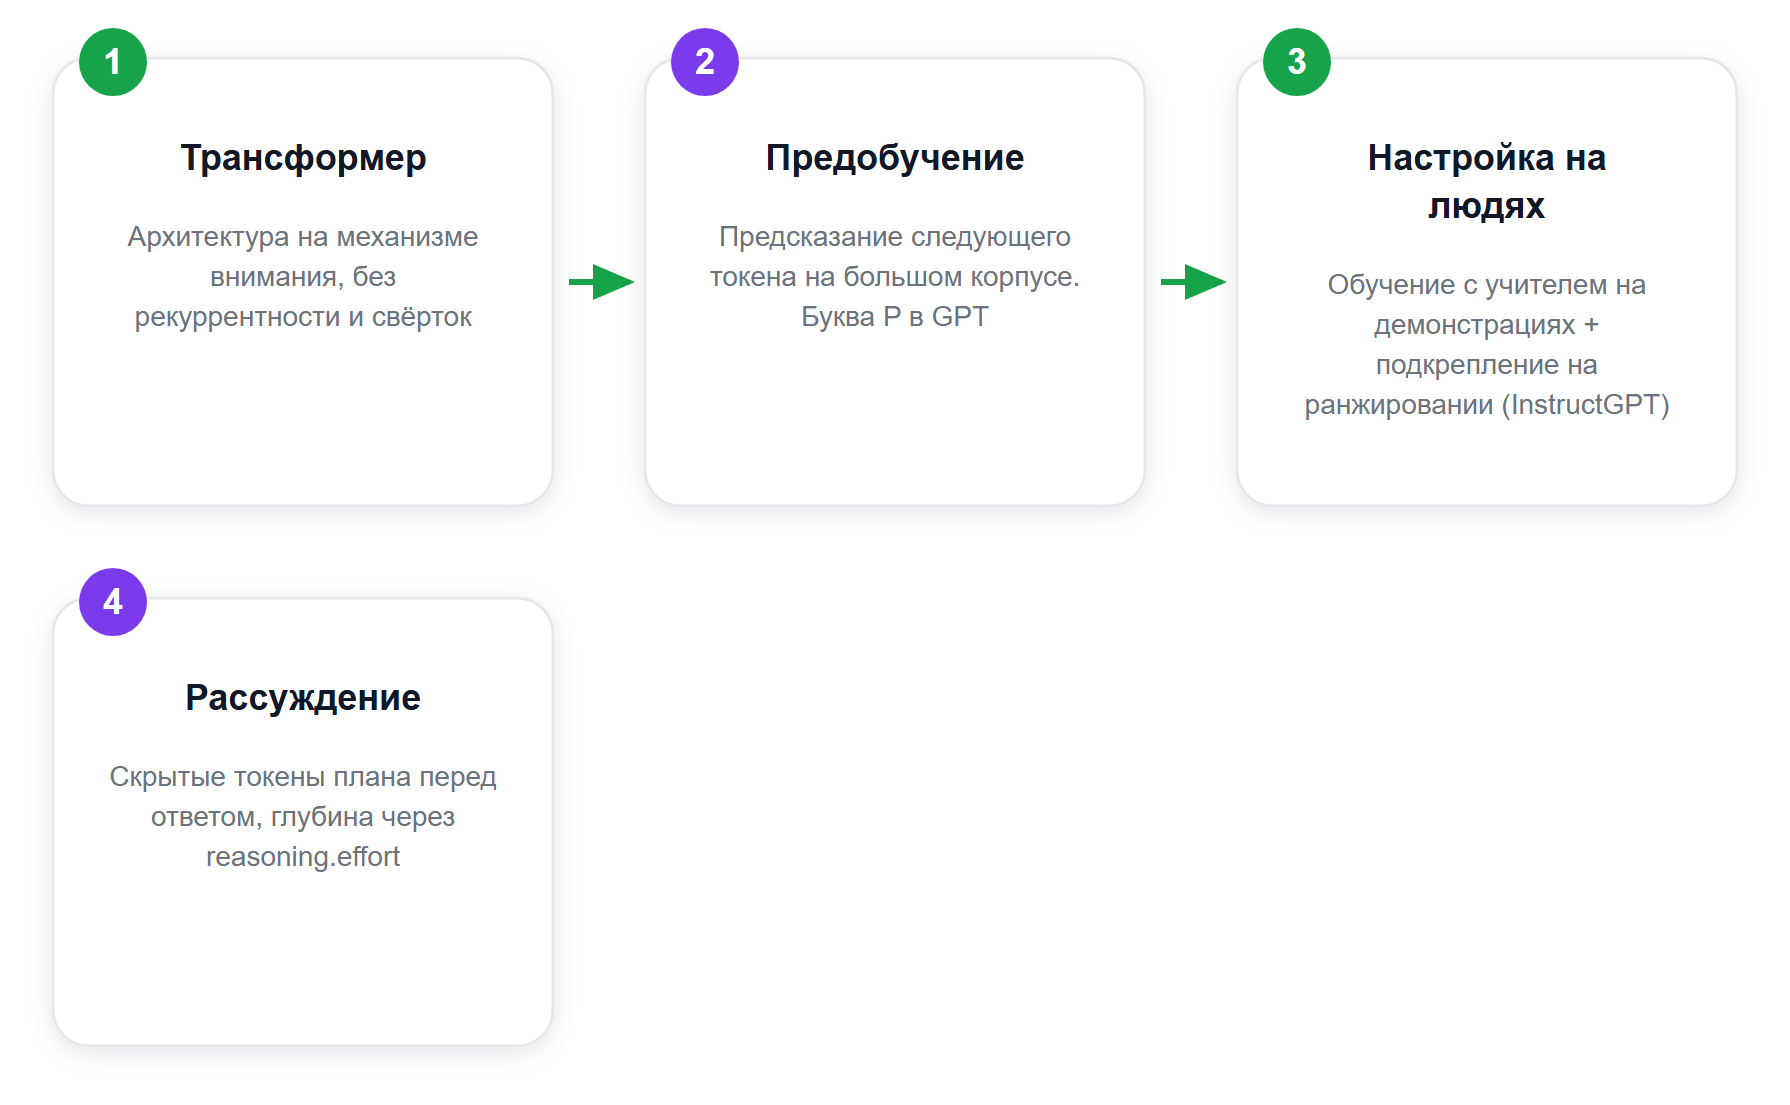
Алгоритм собирается из четырёх стадий, и путаница начинается там, где их сваливают в одну.
Стадия первая — архитектура. В основе лежит трансформер, предложенный в работе «Attention Is All You Need» (arXiv:1706.03762). Формулировка авторов: «We propose a new simple network architecture, the Transformer, based solely on attention mechanisms, dispensing with recurrence and convolutions entirely». Механизм внимания позволяет модели взвешивать все слова контекста разом, без последовательного прохода — отсюда и способность держать длинные зависимости в тексте.
Стадия вторая — предобучение. Модель гоняют по большому корпусу на одной задаче: предсказать следующий токен. Ничего похожего на «понимание вопроса» на этом этапе нет, есть статистика продолжений. Буква P в аббревиатуре GPT — как раз pre-trained.
Стадия третья — настройка на людях. Именно она превращает предсказатель текста в собеседника. OpenAI описала рецепт в работе про InstructGPT (arXiv:2203.02155): сначала собирают демонстрации желаемого поведения от разметчиков и дообучают модель на них обычным обучением с учителем, затем собирают ранжирование ответов и дообучают уже обучением с подкреплением на человеческой обратной связи. Дословно: «We then collect a dataset of rankings of model outputs, which we use to further fine-tune this supervised model using reinforcement learning from human feedback».
Результат этой стадии в статье измерен: ответы InstructGPT на 1,3 млрд параметров люди предпочитали ответам GPT-3 на 175 млрд. Выигрыш дала настройка, причём при стократной разнице в размере в пользу проигравшего.
Стадия четвёртая — рассуждение перед ответом. Она появилась у моделей 2026 года. В справочнике OpenAI сказано: «Reasoning models like GPT-5.5 use internal reasoning tokens before producing a response». Модель тратит скрытые токены на план и перебор вариантов, и глубина этого перебора регулируется параметром reasoning.effort.
Трансформер отвечает за форму, предобучение — за эрудицию, настройка на людях — за манеру, рассуждение — за сложные задачи.
Какие языки поддерживает ChatGPT
Числа вида «ChatGPT говорит на N языках» гуляют по рунету без ссылки на источник. Проверяемый ориентир здесь один — набор, на котором OpenAI меряет собственную многоязычность. Он называется MMMLU, лежит в открытом доступе и описан так: «We translated the MMLU’s test set into 14 languages using professional human translators».
Четырнадцать локалей набора: арабский, бенгальский, немецкий, испанский, французский, хинди, индонезийский, итальянский, японский, корейский, португальский бразильский, суахили, йоруба и китайский упрощённый.
Русского в списке нет. Значит, в этом наборе русский остаётся неизмеренным, и проверку на своей терминологии, своих формулировках и своих документах приходится ставить самому. Тем, кто по этой причине смотрит в сторону отечественных моделей, пригодится разбор перехода бизнеса на российские нейросети.
Отдельная история — язык интерфейса и язык ответа: это две разные настройки, и вопрос обычно про вторую. Мы перебрали сигнатуры client.responses.create и client.chat.completions.create в библиотеке openai 3.1.0: 35 и 41 аргумент соответственно, параметра языка или локали среди них нет. Управление здесь текстовое — язык задаётся системной инструкцией вида «отвечай по-русски».
Четырнадцать языков MMMLU очерчивают измеряемый круг. Русский в него не входит, поэтому проверка на своей задаче обязательна.
ChatGPT для программирования: с какими языками он работает
Список языков, которые модель разбирает как код, косвенно зафиксирован в документации — в перечне форматов, которые принимает поиск по файлам. Туда попали расширения .c, .cpp, .cs, .css, .go, .html, .java, .js, .php, .py, .rb, .sh, .tex и .ts. Отдельной строкой два MIME-типа для Python: text/x-python и text/x-script.python.
Перечень отвечает на вопрос практически: файл на любом из этих языков можно отдать модели целиком, она разберёт его и будет отвечать по содержимому. Для текстовых типов есть требование к кодировке — utf-8, utf-16 или ascii.
Второй ориентир — то, под что OpenAI выпускает отдельные модели. В прайсе есть строка Codex с моделью gpt-5.3-codex по 1,75 $ за 1 млн входных токенов и 14 $ за 1 млн выходных. В справочнике по рассуждению сказано прямо: reasoning-модели «work especially well for complex problem solving, coding, scientific reasoning, and multi-step agentic workflows».
Практическая рамка при работе с кодом простая. Чем больше публичного кода на языке, тем увереннее модель: у Python, JavaScript и Java подсказки точнее, чем у нишевых диалектов и внутренних DSL. Проверять вывод всё равно приходится — модель уверенно пишет и то, чего в библиотеке нет, ровно как в случае с удалённым вызовом openai.ChatCompletion из соседнего раздела.
Четырнадцать расширений из документации — гарантированный минимум разбора файлов. Качество генерации кода при этом зависит от распространённости языка.
Какие языки программирования использовать для интеграции Chat GPT
Внутренности модели остаются на стороне OpenAI, поэтому язык вы выбираете только под свой код. В справочнике примеры к каждому методу даются параллельно на четырёх языках: JavaScript, Python, Go и Ruby.
- Python — язык по умолчанию для работы с данными и подготовки базы знаний. Пакет ставится командой
pip install openai, актуальная версия на момент проверки — 3.1.0. Здесь же живут инструменты подготовки корпуса: разбор PDF, чистка текста, разметка JSONL. - JavaScript и Node.js — когда бот стоит на сайте или в облачной функции и нужен один язык на фронт и бэк. В справочнике примеры для Node идут первыми, вызов называется
openai.responses.create. - Go — модуль
github.com/openai/openai-go/v3, вызовы видаclient.VectorStores.New. Берут, когда сервис уже написан на Go и тянуть Python-прослойку не хочется. - Ruby — библиотека с тем же набором методов,
client.vector_stores.create. Подходит проектам на Rails.
Здесь же главная ловушка старых статей. Конструкция openai.ChatCompletion.create() в текущей библиотеке не работает. Мы поставили openai 3.1.0 в чистое окружение и вызвали её — получили исключение APIRemovedInV1 с текстом: «You tried to access openai.ChatCompletion, but this is no longer supported in openai>=1.0.0…». Актуальные вызовы называются client.responses.create и client.chat.completions.create, руководство по переходу лежит в репозитории библиотеки. Если гайд предлагает первую форму, он написан до перехода библиотеки на версию 1.0.0 — и остальные его разделы такие же старые.
Язык влияет на удобство сопровождения. Качество ответов задают модель, промпт и база знаний.

- ПОКАЖЕМ, КАК РАЗВЕРНУТЬ МОДЕЛЬ нейросети DEEPSEEK R1 ПРЯМО НА СВОЁМ КОМПЬЮТЕРЕ
- Где и как применять? Потестируем модель после установки на разных задачах
- Как дообучить модель под себя?
Библиотеки и фреймворки для Chat GPT
Инструменты делятся на две группы по тому, где лежит модель. Смешивать их в одном туториале — характерная ошибка старых материалов.
- Официальная библиотека openai — всё, что нужно для работы с ChatGPT по API: файлы, векторные хранилища, поиск, ответы, дообучение. Один пакет закрывает путь от загрузки документа до ответа бота.
- Hugging Face Transformers — библиотека для обработки естественного языка с готовыми предобученными моделями. К моделям, которые стоят за ChatGPT, доступа не даёт: их веса не публикуются. При этом часть моделей OpenAI открыта — gpt-2 и семейство gpt-oss под лицензией Apache 2.0 скачиваются свободно, и вот с ними Transformers работает напрямую.
- PyTorch и TensorFlow — фреймворки глубокого обучения. Понадобятся, если вы запускаете или дообучаете открытую модель на своём железе. В репозитории gpt-oss эталонная реализация запуска написана как раз на PyTorch, рядом лежат варианты на Triton и Metal.
- Node.js-библиотеки — тот же официальный пакет для веб-разработки: бот на сайте, обработчик вебхука, облачная функция.
- Оркестраторы вроде LangChain и LlamaIndex — надстройки, которые собирают конвейер «документ → фрагменты → эмбеддинги → поиск» на вашей стороне. Имеют смысл, когда база живёт в вашей инфраструктуре.
Выбор упирается в один вопрос: где хранятся ваши документы. Отдать их в векторное хранилище OpenAI — хватит одной библиотеки. Держать у себя — понадобится собственный поиск и, скорее всего, открытая модель; варианты собраны в обзоре локальных нейросетей для проекта.
Пакет openai закрывает интеграцию. Transformers и PyTorch отвечают за модели на вашем железе, включая открытые модели самой OpenAI.
Как обучить чат GPT на своих данных, если модель менять нельзя
Слово «обучить» в этом запросе почти всегда означает «пусть бот отвечает по моим документам». Веса модели для этого трогать не нужно: файлы кладутся в векторное хранилище, и модель ищет по ним фрагменты в момент ответа. В API за это отвечает инструмент file_search, вызывается он так:
from openai import OpenAI

client = OpenAI()

vector_store = client.vector_stores.create(name="Support FAQ")

client.vector_stores.files.upload_and_poll(
    vector_store_id=vector_store.id,
    file=open("customer_policies.txt", "rb"),
)

response = client.responses.create(
    model="gpt-5.6",
    input="Какие условия возврата действуют для юрлиц?",
    tools=[{"type": "file_search", "vector_store_ids": [vector_store.id]}],
)
Ограничения по документации: файл до 512 МБ и не более 5 000 000 токенов, нарезка по умолчанию — фрагменты по 800 токенов с нахлёстом 400. Хранение стоит 0,10 $ за гигабайт в сутки при первом бесплатном гигабайте, вызов поиска — 2,50 $ за 1000 вызовов.
Настоящее дообучение весов — отдельная история, и вход в неё закрывается. В разделе Deprecations документации OpenAI сказано: «OpenAI is winding down the fine-tuning platform. The platform is no longer accessible to new users». Организациям без истории дообучения платформа недоступна с 7 мая 2026 года, всем остальным создание новых задач закроют 6 января 2027 года. Само обучение стоит одинаково в обоих тарифных режимах: за 1 млн токенов gpt-4.1 — 25 $, gpt-4.1-mini — 5 $, gpt-4.1-nano — 1,50 $. По режиму расходятся запросы к уже дообученной модели: на вкладке Standard у gpt-4.1 вход стоит 3 $ и выход 12 $ за 1 млн токенов, на вкладке Batch — 1,50 $ и 6 $.
Разбор каждого пути по шагам — подготовка базы знаний, кастомный GPT без единой строчки кода, поиск по базе через API, дообучение и подводные камни на каждом из них — лежит в отдельном руководстве: как обучить ChatGPT на своей базе знаний.
База знаний живёт отдельно от модели. Внутри API это единственный путь, открытый тем, кто начинает сегодня; за пределами API остаётся запуск открытой модели на своём железе.
Рекомендации по развертыванию
Пункты, которые решаются до первого запроса в прод.
Выбор подходящей модели
Рекомендация справочника однозначна: «Start with gpt-5.6 for new work». Семейство состоит из gpt-5.6-sol, gpt-5.6-terra и gpt-5.6-luna, разница между ними — в цене за миллион токенов и в глубине рассуждения. Советы «возьмите GPT-2 или GPT-3» из статей 2023 года устарели: снапшоты gpt-3.5-turbo-instruct, babbage-002 и davinci-002 отключаются 28 сентября 2026 года.
Объем данных
Для поиска по базе объём ограничен размером файла: 512 МБ и 5 млн токенов. Для дообучения важен не объём, а чистота: минимум 10 строк JSONL, каждая — законченный диалог в целевом формате.
Облачные сервисы
Векторное хранилище OpenAI снимает вопрос инфраструктуры целиком: индекс, эмбеддинги и поиск на их стороне. Альтернатива — собственный вектор-индекс на AWS, GCP или Azure, когда нужен контроль над хранением.
Локальное развертывание
Полностью локальный контур закрывает требования к персональным данным и коммерческой тайне, но забирает инференс на ваше железо. Запускать есть что: gpt-oss-120b, по описанию репозитория, помещается в один GPU на 80 ГБ вроде NVIDIA H100, а gpt-oss-20b рассчитан на локальные сценарии с меньшей задержкой.
Масштабирование
Лимиты запросов к поиску по файлам считаются по тарифному уровню: 100 запросов в минуту на первом, 500 — на втором и третьем, 1000 — на четвёртом и пятом. Планируйте нагрузку от этих чисел.
Оптимизация
Два рычага дают основную экономию. Первый — кэширование входных токенов: у дообученной gpt-4.1 в режиме Standard кэшированный вход стоит 0,75 $ против 3 $ за обычный. Второй — expires_after у хранилища: индекс, нужный на время кампании, гасится по расписанию и перестаёт капать в счёт.
Защита данных
Загруженные файлы уезжают на серверы OpenAI, и это отдельное решение по каждому корпусу документов. Персональные данные требуют либо обезличивания перед загрузкой, либо локального контура. Разбор задач, которые безопасно отдавать наружу, есть в материале об автоматизации процессов в компании.
Мониторинг и контроль
Включите include=["file_search_call.results"] — ответ вернёт найденные фрагменты, и станет видно, на чём именно модель построила фразу. Это же поле ловит момент, когда бот начал отвечать мимо базы.
Чек-лист: что проверить перед работой с ChatGPT
Восемь пунктов, каждый — с признаком, по которому видно, что пора вмешаться.
- Бот путается в языке ответа. Ищите причину в промпте: параметра языка в запросе нет ни у
responses.create, ни уchat.completions.create. Лечится системной инструкцией. - Качество на русском вызывает сомнения. Ставьте собственный замер на своей терминологии: русский в 14 локалей набора MMMLU не входит.
- Гайд предлагает
openai.ChatCompletion.create. Закрывайте: вызов удалён из библиотеки с версии 1.0.0 и возбуждаетAPIRemovedInV1. Остальные рецепты из того же материала такие же старые. - Гайд ведёт в Assistants API. Отключение назначено на 26 августа 2026 года, замена — Responses API и Conversations API.
- Выбираете язык под интеграцию. Хватит Python или Node.js. C, C++ и CUDA нужны только тем, кто пишет собственный инференс-движок.
- Выбираете библиотеку. Отвечайте на один вопрос — где лежит модель. У OpenAI — пакет openai. У вас — Transformers и PyTorch поверх открытых весов вроде gpt-oss.
- Отдаёте модели файл с кодом. Сверьтесь со списком из документации (.c, .cpp, .cs, .css, .go, .html, .java, .js, .php, .py, .rb, .sh, .tex, .ts) и с требованием к кодировке: utf-8, utf-16 или ascii.
- Планируете дообучение. Проверьте право на него в дашборде: платформа закрыта для организаций без истории fine-tuning с 7 мая 2026 года, финальная отсечка для всех — 6 января 2027 года.
Вопросы и ответы
На каком языке программирования написан ChatGPT?
Исходники самого ChatGPT закрыты, но по открытым проектам OpenAI картина устойчивая: верхний слой на Python, тяжёлые вычисления на C и C++. В репозитории gpt-oss GitHub считает Python 40,3 %, C 27,9 %, C++ 13,3 %, Metal 12,2 %; репозитории gpt-2 и whisper на 100 % состоят из Python, токенизатор tiktoken — из Python и Rust.
Какой алгоритм используется для обучения ChatGPT?
Четыре стадии. Архитектура — трансформер из работы «Attention Is All You Need», построенный целиком на механизме внимания. Предобучение — предсказание следующего токена на большом корпусе. Настройка на людях — сначала обучение с учителем на демонстрациях разметчиков, затем обучение с подкреплением на ранжировании ответов; этот рецепт OpenAI описала в работе про InstructGPT. Четвёртая стадия у моделей 2026 года — скрытые токены рассуждения перед ответом.
Какие языки поддерживает ChatGPT?
Проверяемый ориентир здесь один — собственный многоязычный набор компании MMMLU: тест MMLU переведён профессиональными переводчиками на 14 языков — арабский, бенгальский, немецкий, испанский, французский, хинди, индонезийский, итальянский, японский, корейский, португальский бразильский, суахили, йоруба и китайский упрощённый. Русского в этом списке нет, поэтому качество на русском стоит проверять на своих задачах.
На каких языках программирования ChatGPT разбирает код?
В документации по поиску по файлам перечислены расширения .c, .cpp, .cs, .css, .go, .html, .java, .js, .php, .py, .rb, .sh, .tex и .ts — файл на любом из них можно отдать модели целиком. Для текстовых типов кодировка должна быть utf-8, utf-16 или ascii. Под задачи разработки у OpenAI есть отдельная модель gpt-5.3-codex.
Можно ли скачать модель ChatGPT и запустить у себя?
Веса моделей, стоящих за ChatGPT, закрыты. При этом часть моделей OpenAI открыта: gpt-2, а также gpt-oss-120b и gpt-oss-20b под лицензией Apache 2.0. По описанию репозитория gpt-oss-120b помещается в один GPU на 80 ГБ вроде NVIDIA H100, gpt-oss-20b рассчитан на локальные сценарии с меньшей задержкой. Эталонная реализация запуска написана на PyTorch, рядом лежат варианты на Triton и Metal.
Почему не работает код с openai.ChatCompletion.create?
Этот вызов удалён из библиотеки начиная с версии 1.0.0. В openai 3.1.0 обращение к нему возбуждает исключение APIRemovedInV1 с текстом «You tried to access openai.ChatCompletion, but this is no longer supported in openai>=1.0.0…». Рабочие формы — client.responses.create и client.chat.completions.create.