
У самой OpenAI бесплатной озвучки текста нет. Голосовой режим в приложении ChatGPT открыт и на плане Free, но это разговор, и его расход справка считает по скользящему окну в 24 часа. Синтез речи в файл живёт в отдельном платном эндпоинте API: у модели gpt-4o-mini-tts аудио на выходе стоит $12 за 1 млн токенов. Россия в список поддерживаемых стран OpenAI не входит. Поэтому запрос «gpt озвучка текста бесплатно» на практике закрывается соседними путями — открытой моделью на своём компьютере или российским сервисом с бесплатным объёмом.
- Голос в приложении и синтез через API — два разных продукта с разными моделями, голосами и лимитами.
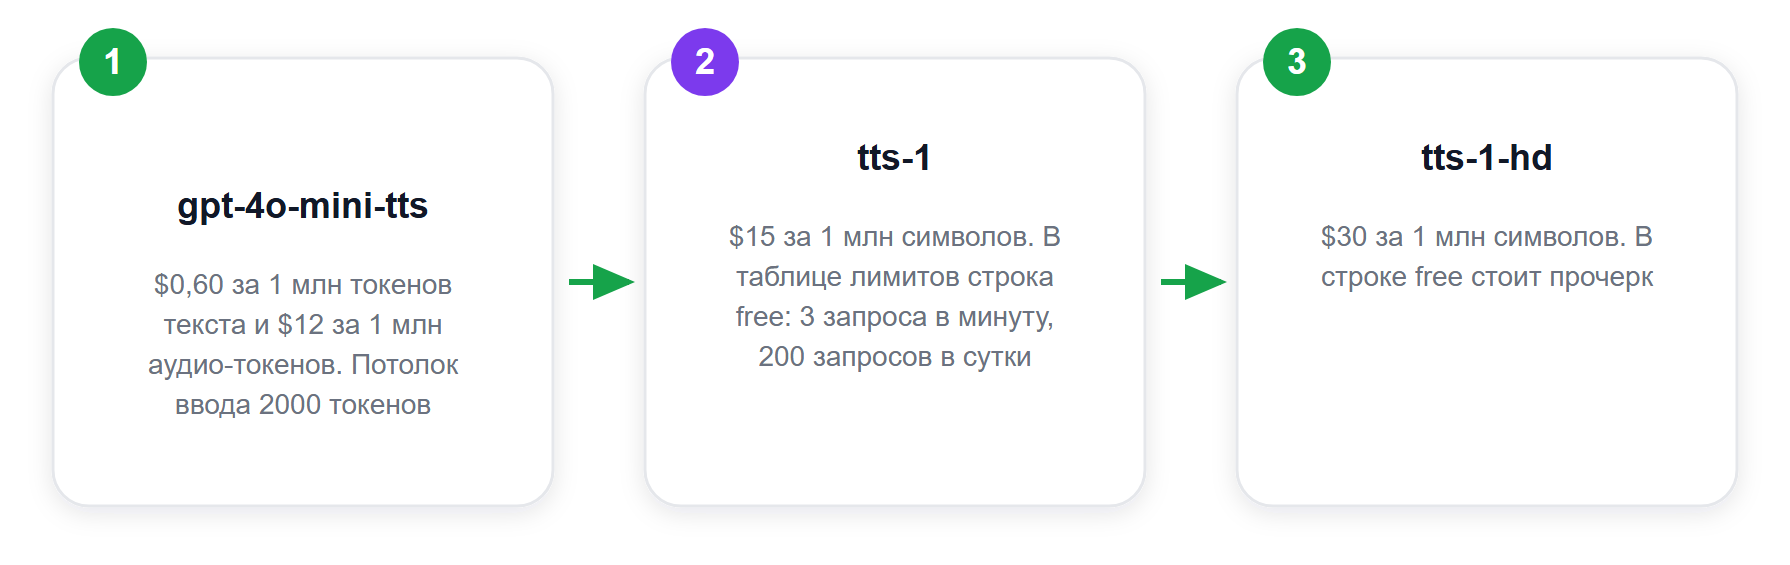
- Три TTS-модели OpenAI тарифицируются в разных единицах: одна в токенах, две в символах.
- Free-ярус API квалифицируется географией, и России в списке из 208 стран нет.
- Silero v5_5_ru синтезирует русский локально без оплаты и регистрации — с лицензией CC BY-NC-SA.
- Freemium SaluteSpeech давал 200 000 символов синтеза в месяц, но новых клиентов не подключают с 15 июля 2026 года.
Что в ChatGPT работает бесплатно, а за что просят денег
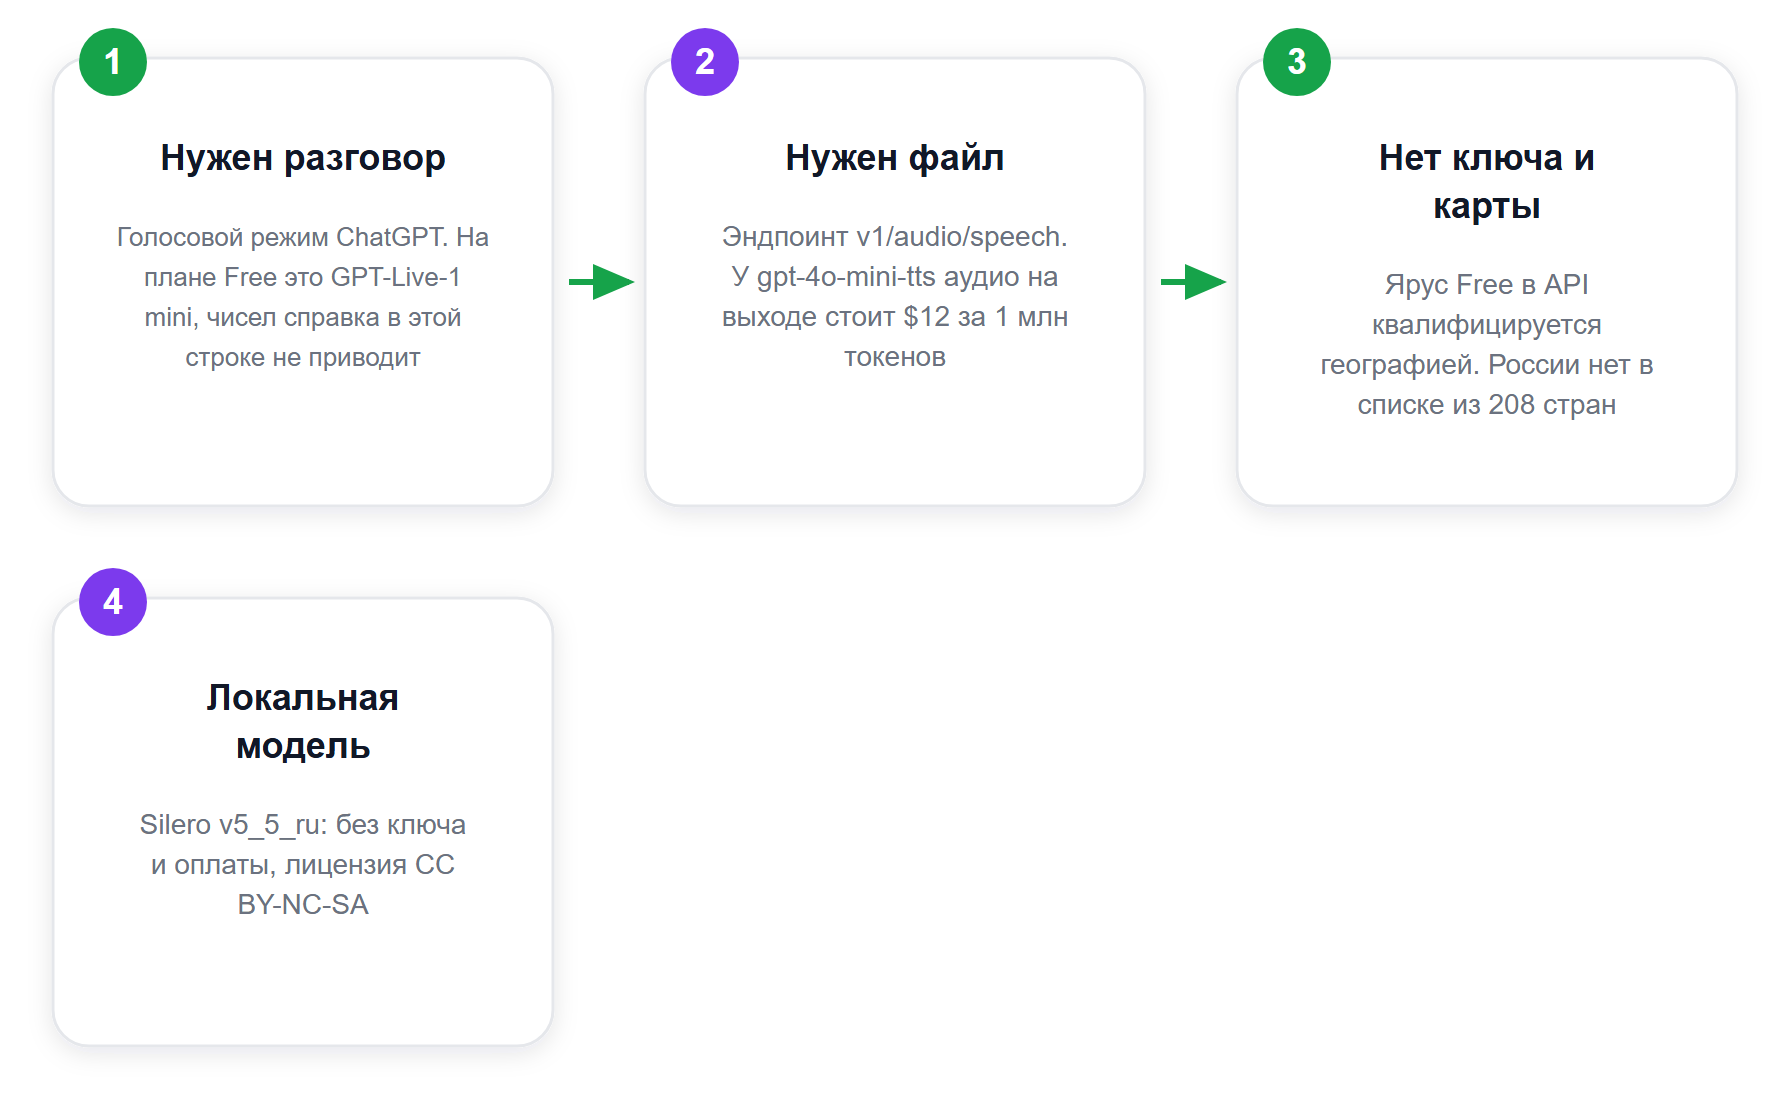
Голосовой режим ChatGPT доступен на бесплатном плане с оговоркой. Справка OpenAI «ChatGPT Voice» (help.openai.com, статья 20001274, на 17.09.2026 подпись «Updated: 5 days ago») описывает сам продукт так: «ChatGPT Voice lets you speak with ChatGPT and hear a spoken response». Расход считается по скользящему окну: «In Chat mode, Live usage is measured over a rolling 24-hour period». Таблица лимитов в той же статье устроена по планам:
- Free — «Limited access to GPT-Live-1 mini. Limits may change». Числа в этой строке справка не называет.
- Go — 3 часа с GPT-Live-1 mini.
- Plus — 3 часа с GPT-Live-1.
- Pro ($100/month) — 15 часов с GPT-Live-1.
- Pro ($200/month) — безлимит GPT-Live-1.
Связка тут такая: три часа стоят у Plus, пятнадцать — у Pro за $100 в месяц, и обе цифры относятся к модели GPT-Live-1; у бесплатного плана и у Go работает GPT-Live-1 mini. Голоса в приложении названы своими именами — Arbor, Breeze, Cove, Ember, Juniper, Maple, Sol, Spruce, Vale; в Бразилии справка добавляет Viola и Rio. Аудиозаписи разговоров хранятся 30 дней: «Clips are retained for 30 days».
Ближайшее к «озвучить свой текст» действие внутри приложения — кнопка Read aloud под ответом модели. Справка по Android-приложению (статья 8142208) перечисляет её среди действий над сообщением: «Available actions vary by message and context and may include Copy, Good response, Bad response, Read aloud, Share, and Try again». Границу этой кнопки OpenAI не публикует: в разделе Voice справочного центра на 17.09.2026 лежит одна статья — «ChatGPT Voice», и она не описывает Read aloud.
Сколько стоит озвучка текста через API OpenAI
Синтез речи у OpenAI живёт на эндпоинте v1/audio/speech. Руководство «Text to speech» описывает его так: «The Audio API provides a speech endpoint based on our GPT-4o mini TTS (text-to-speech) model». По умолчанию эндпоинт отдаёт MP3, а ещё умеет Opus, AAC, FLAC, WAV и PCM. Русский язык в списке поддерживаемых есть, но там же стоит оговорка: «Voices are currently optimized for English».
Дальше начинается место, где чаще всего путают цифры. Три TTS-модели OpenAI тарифицируются в разных единицах: у gpt-4o-mini-tts счёт идёт в токенах и делится на текст и аудио, у tts-1 и tts-1-hd — в символах. Каждая строка ниже снята со страницы своей модели — официальной документации OpenAI по gpt-4o-mini-tts и её соседей по каталогу.
| Модель | Что тарифицируется | Цена | Единица |
| gpt-4o-mini-tts | текст на входе | $0,60 | за 1 млн токенов |
| gpt-4o-mini-tts | аудио на выходе | $12 | за 1 млн токенов |
| tts-1 | синтез речи | $15 | за 1 млн символов |
| tts-1-hd | синтез речи | $30 | за 1 млн символов |
Отдельно у каждой модели свои ограничения, и они тоже не взаимозаменяемы. Карточка gpt-4o-mini-tts говорит прямо: «The maximum number of input tokens is 2000» — потолок ввода у неё 2000 токенов. В её таблице лимитов бесплатного яруса нет вовсе, счёт начинается с Tier 1 (500 запросов в минуту, 50 000 токенов в минуту). У tts-1 строка free в таблице лимитов есть и означает 3 запроса в минуту и 200 запросов в сутки. У tts-1-hd в той же строке стоит прочерк.
Голосов на эндпоинте тринадцать — раздел Voice options перечисляет alloy, ash, ballad, coral, echo, fable, nova, onyx, sage, shimmer, verse, marin, cedar. Моделям tts-1 и tts-1-hd доступны девять из них: alloy, ash, coral, echo, fable, onyx, nova, sage, shimmer. Имена голосов приложения (Arbor, Cove, Juniper) в этом списке не встречаются ни разу — это и есть механическое доказательство того, что голос в ChatGPT и озвучка через API собраны из разных деталей. Политика использования требует предупреждать слушателя: «provide a clear disclosure to end users that the TTS voice they are hearing is AI-generated».
Почему запрос «gpt озвучка текста бесплатно» упирается в географию
У API OpenAI действительно есть ярус с названием Free. Руководство по лимитам описывает его одной строкой таблицы: квалификация — «User must be in an allowed geography», потолок расхода — $100 в месяц. Следующий ярус, Tier 1, требует «$5 paid». Квалификация бесплатного яруса — страна пользователя; оплата в ней не участвует.
Страница «Supported countries and territories» на platform.openai.com начинается предупреждением: «Accessing or offering access to our services outside of the countries and territories listed below may result in your account being blocked or suspended». Мы посчитали список прибором: 208 пунктов. России среди них нет. Есть Казахстан, Армения, Грузия, Азербайджан, Узбекистан, Кыргызстан, Турция и Сербия. Отдельный список для самого ChatGPT лежит в справочном центре (статья 7947663) и построен так же — России в нём тоже нет.
Как это выглядит на практике, мы проверили сами 17 сентября 2026 года. Запрос к https://api.openai.com/v1/audio/speech с моделью gpt-4o-mini-tts и русской фразой на входе, без ключа, вернулся за 0,3 секунды с кодом 401 и текстом: «You didn’t provide an API key. You need to provide your API key in an Authorization header using Bearer auth». Повтор с заведомо неверным ключом дал тот же 401 и другую формулировку: «Incorrect API key provided». Сервер отсекает запрос на первом шаге — до проверки географии. Ключ же выдаётся аккаунту, зарегистрированному в разрешённой стране.
Практический вывод для читателя из России простой. Бесплатной озвучки текста «от GPT» в том виде, как её обещают агрегаторы-посредники, не существует. Остаются два варианта: платный ключ на зарубежный аккаунт или другой синтезатор. Разберём второй.
Наш прогон: Silero озвучил русский текст бесплатно и потерял все числа
Чтобы не пересказывать чужие подборки, мы 17 сентября 2026 года прогнали один и тот же русский текст через открытую модель Silero — ту, что скачивается с models.silero.ai и работает локально, без регистрации, ключа и карты. Версия v5_5_ru, голос baya, частота 48 кГц, синтез на процессоре без видеокарты, torch 2.11.0+cpu.
Файл модели весит 145 420 684 байта и скачался за 4,8 секунды. Загрузка в память — 0,5 секунды. Фраза «Курс стоил тысячу пятьсот рублей» на прогретой модели синтезировалась за 0,07 секунды и дала 2,33 секунды звука — в 33 раза быстрее реального времени. Денег за это не просят ни за символы, ни за минуты.
Дальше — про то, что сломалось. Мы вывели из модели её собственный алфавит: _~|!+,-.:;?абвгдежзийклмнопрстуфхцчшщъыьэюяё–… и пробел. Ни одной цифры. Ни одной латинской буквы. Ни знака рубля. Всё, чего нет в этом наборе, модель молча выбрасывает — и это видно по длительности:
- «Курс стоил 1500 рублей.» — 1,39 с; та же фраза прописью — 2,33 с. Почти секунда звука пропала вместе с числом.
- «17 сентября 2026 года.» — 1,27 с; прописью — 3,65 с, в 2,9 раза дольше.
- «Курс стоил 1500 ₽.» — 1,02 с: знак рубля тоже ушёл в тишину.
- «Открой файл speech.mp3 через OpenAI API.» — 1,44 с, латиница исчезла целиком.
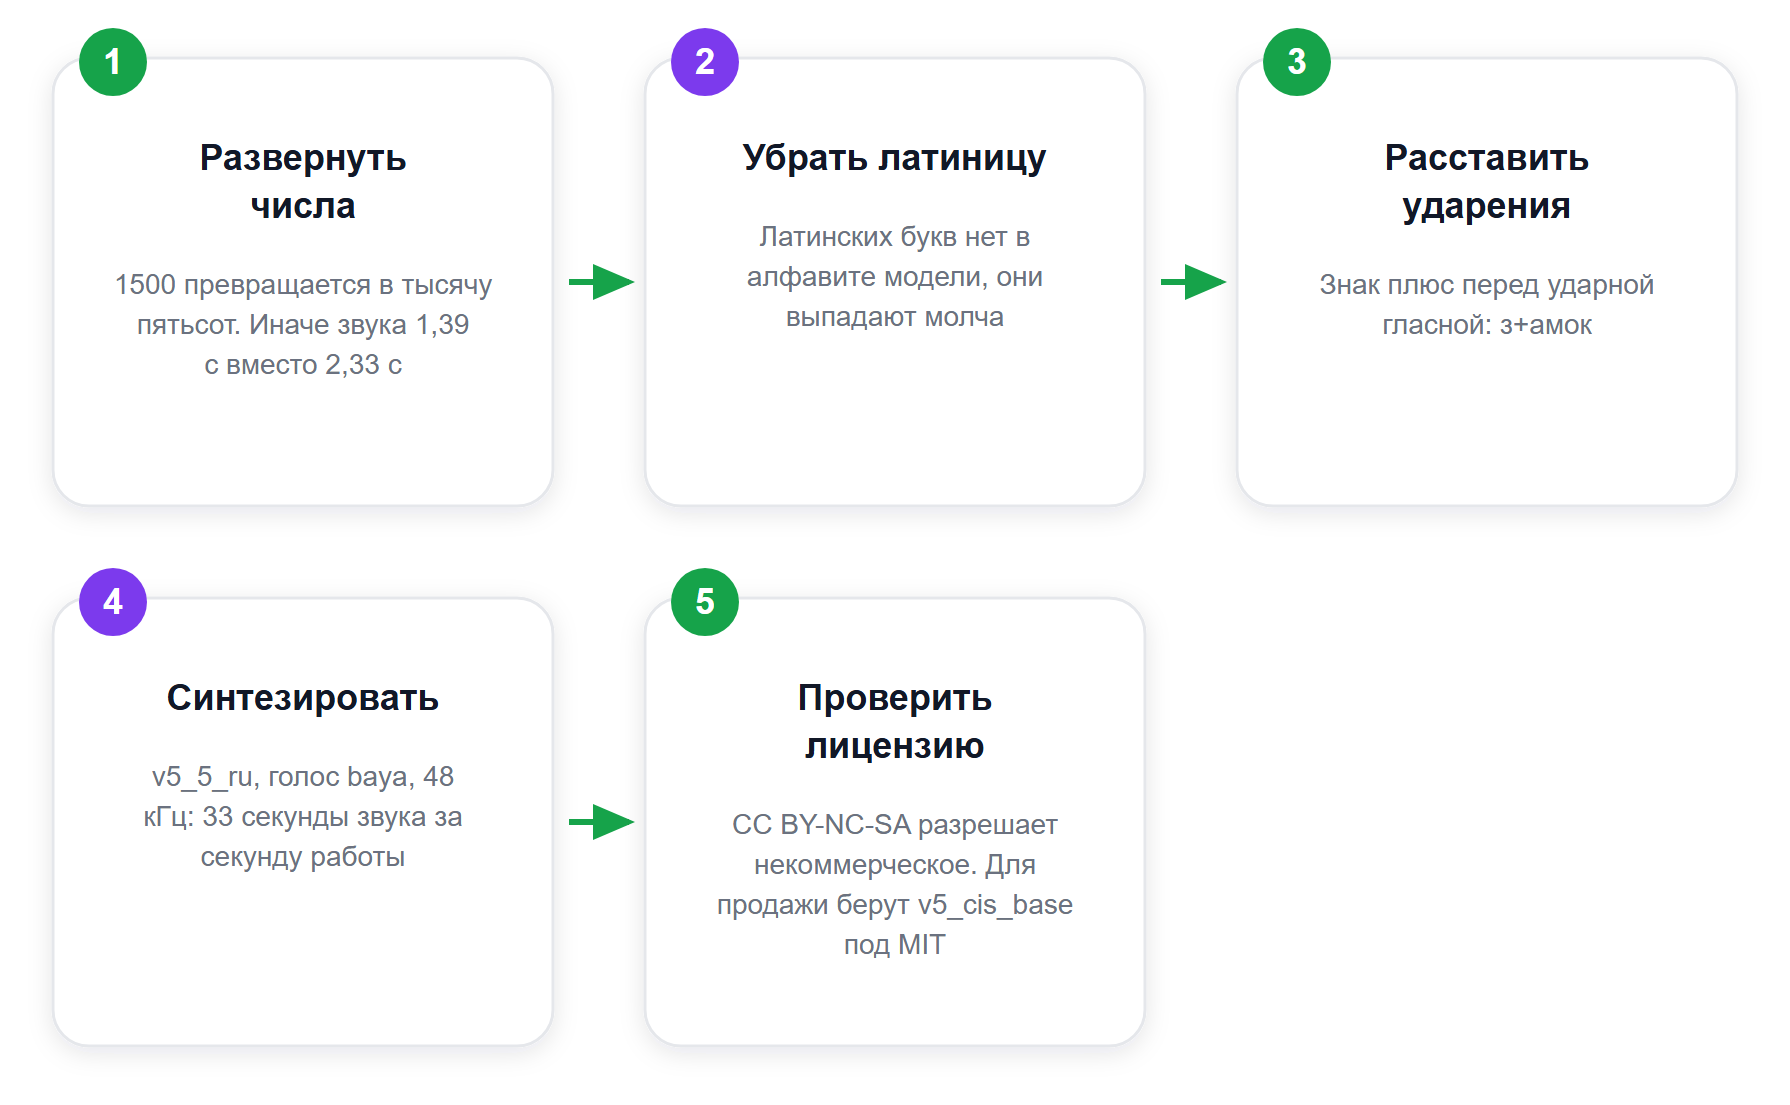
Ошибки при этом нет. Модель не падает и не предупреждает — она просто озвучивает то, что осталось. Поэтому перед синтезом числа, даты, суммы и латинские названия нужно разворачивать в слова самому.
С ударениями вышло лучше. Silero принимает знак + перед ударной гласной. Мы синтезировали «На двери висел замок», «На двери висел зам+ок» и «На двери висел з+амок». Первые два файла совпали побайтно — 152 444 байта, MD5 2ee9d429…; третий отличается: 156 044 байта, MD5 9982f6ad…. Значит, по умолчанию модель читает «замо́к», а ударение на первый слог надо ставить руками. Проверять это удобно именно так: одинаковый MD5 означает, что разметка ничего не изменила.
import torch, wave
model = torch.package.PackageImporter("v5_5_ru.pt").load_pickle("tts_models", "model")
model.to(torch.device("cpu"))
audio = model.apply_tts(text="На двери висел з+амок.", speaker="baya", sample_rate=48000)
pcm = (audio.numpy() * 32767).astype("<i2").tobytes()
with wave.open("out.wav", "wb") as w:
    w.setnchannels(1); w.setsampwidth(2); w.setframerate(48000); w.writeframes(pcm)
Граница у этой бесплатности всё же есть, и она юридическая. Файл LICENSE в репозитории silero-models открывается строкой «Attribution-NonCommercial-ShareAlike 4.0 International», а раздел Licence в README уточняет: «All of the models are published under the main repo license (i.e. CC-NC-BY) except for the base cis-tts models, which are under MIT». Для роликов на продажу берут модели семейства v5_cis_base под MIT; у них, по описанию в README, ударение нужно проставлять для каждого слова вручную.
Свой TTS-стек: что осталось от схемы «энкодер — декодер — вокодер»
Классический пайплайн синтеза речи выглядит как три ступени: текст превращается в токены энкодером, токены — в мел-спектрограммы декодером, спектрограммы — в звук вокодером. Раньше под русский голос эту цепочку собирали руками: чистили датасет, сводили частоту дискретизации, обучали акустическую модель и отдельно вокодер. Сегодня для задачи «озвучить текст» это лишняя работа: готовая end-to-end модель ставится одной строкой. Silero так себя и описывает первым пунктом списка свойств — «Fully end-to-end».
Ступени пригодятся там, где голос нужен конкретный — например собственный. Частота дискретизации — первый параметр, который придётся выбрать осознанно: Silero отдаёт 8000, 24000 или 48000 Гц, а эндпоинт OpenAI в формате PCM возвращает «raw samples in 24kHz (16-bit signed, low-endian), without the header». От этой цифры зависит и вес файла: наши 2,33 секунды речи на 48 кГц заняли 223 244 байта в WAV.
Клонирование своего голоса у OpenAI вынесено в отдельный механизм Custom voices, и там свои границы, снятые с руководства: «At most 20 voices can be created per organization», «The audio samples must be 30 seconds or less», а создание требует двух записей — согласия и образца. Фраза согласия задана дословно и доступна на 16 языках, включая русский; отклонение от скрипта руководство описывает как отказ: «Any divergence from the script will lead to a failure». Сам механизм открыт не всем: «Custom voices are limited to eligible customers».
Российские сервисы: где бесплатный объём ещё есть и где его закрыли
Самый частый совет в подборках — SaluteSpeech от Сбера с бесплатным тарифом Freemium. Совет устарел. Страница тарифов для физлиц в документации SaluteSpeech (подпись «Обновлено 16 июля 2026») открывается предупреждением: «С 15 июля 2026 года прекращена продажа новых пакетов и продление Freemium тарифа для физических лиц». Страница подключения (integration-individuals, «Обновлено 22 июля 2026») говорит ещё прямее: «С 15 июля 2026 года подключение для новых клиентов недоступно». Для юрлиц закрыли покупку пакетов и схему pay-as-you-go тем же числом.
Сам Freemium выглядел так, и эти два числа стоят у разных услуг:
- Синтез речи — 200 000 символов, срок действия 1 месяц.
- Распознавание речи — 100 минут, срок действия 1 месяц.
- Неизрасходованный объём не переносится: «Если вы не использовали весь доступный объем за месяц, остаток сгорает».
Платный пакет физлица на синтез стоил 1 000 рублей за 1 000 000 символов в месяц. У юрлиц тарификация посимвольная — 0,000186 рубля за символ, при минимальной стоимости использования 15 000 рублей в месяц включая НДС. Эти цифры полезны как ориентир рынка: миллион символов русского синтеза в России стоит порядка тысячи рублей, в API OpenAI на модели tts-1 — $15 за тот же миллион символов.
Что это означает для читателя, который ищет бесплатную озвучку сегодня. Российские облачные синтезаторы тарифицируются за символы или минуты, и бесплатные пакеты у них появляются и исчезают по решению вендора — Сбер закрыл свой за одну июльскую дату. Локальная открытая модель этой зависимости не имеет: скачанный файл продолжает работать, даже если вендор завтра поменяет правила. Поэтому для задачи «озвучить текст один раз и без бюджета» локальный путь предсказуемее.
Сравнение путей: где озвучка текста бесплатно, а где только выглядит бесплатной
Ниже — шесть путей, по которым люди приходят из запроса про бесплатную озвучку. В колонке «граница» стоит то самое число или условие, за которым бесплатность заканчивается. Пустых клеток здесь нет: если источник условия не называет, так и написано.
| Путь | Что доступно без оплаты | Граница бесплатного | Чем подтверждено |
| ChatGPT, план Free — голосовой режим | Разговор голосом с GPT-Live-1 mini | «Limited access to GPT-Live-1 mini. Limits may change» — чисел справка в этой строке не даёт | help.openai.com, статья 20001274 |
| ChatGPT Plus — голосовой режим | 3 часа с GPT-Live-1 за скользящие 24 часа | План платный; его цену эта таблица справки не называет | help.openai.com, статья 20001274 |
| API OpenAI, gpt-4o-mini-tts | Бесплатного объёма нет | $0,60 за 1 млн токенов текста плюс $12 за 1 млн аудио-токенов; потолок ввода 2000 токенов | developers.openai.com, карточка модели |
| API OpenAI, tts-1 | В таблице лимитов есть строка яруса free: 3 запроса в минуту, 200 в сутки | Это частота запросов; цена синтеза от неё не зависит и равна $15 за 1 млн символов | developers.openai.com, карточка модели |
| SaluteSpeech, тариф Freemium | Синтез речи 200 000 символов в месяц | Новых клиентов не подключают с 15 июля 2026 года; неизрасходованный остаток сгорает | developers.sber.ru, тарифы для физлиц |
| Silero v5_5_ru локально | Синтез без лимита по объёму, без ключа и регистрации | Лицензия CC BY-NC-SA — использование некоммерческое; цифры и латиница выпадают из текста | LICENSE репозитория silero-models плюс наш прогон 17.09.2026 |
Отдельная строка нужна агрегаторам вида «чат-гпт на русском с озвучкой», которые занимают половину выдачи по этому запросу. Их условия мы не проверяли и цифр по ним не приводим: это сторонние посредники со своими правилами, и вопрос об их лимитах адресуется им.
Как озвучить текст бесплатно за один вечер: порядок действий
Схема ниже собрана из нашего прогона и повторяется на любом компьютере с Python. Она закрывает ровно ту задачу, ради которой люди ищут бесплатную озвучку текста: получить аудиофайл с русской речью, не заводя карту и не покупая пакет символов.
- Разверните числа в слова. «1500 ₽» превращается в «тысячу пятьсот рублей», «17.09.2026» — в «семнадцатого сентября две тысячи двадцать шестого года». Без этого шага текст озвучится с дырами, и модель об этом не предупредит.
- Уберите латиницу. Названия вроде OpenAI API запишите кириллицей так, как их произносят вслух.
- Проставьте ударения там, где слово читается двояко. Знак
+перед ударной гласной: «з+амок», «б+ольшая часть», «ст+оит». - Скачайте модель один раз. Файл v5_5_ru.pt весит 145 420 684 байта; после скачивания интернет для синтеза больше не нужен.
- Синтезируйте и послушайте целиком. Скорость на процессоре — примерно 33 секунды звука за секунду работы, так что проверка обходится дёшево.
- Проверьте лицензию под свою задачу. Для коммерческого ролика нужна модель под MIT из семейства
v5_cis_base.
Тот же порядок работает и для соседних задач: сценарий рекламного ролика удобно готовить по инструкции как написать и озвучить рекламный аудиоролик с помощью AI-инструментов, а если голос нужен для видео — посмотрите разбор, как сделать TikTok-видео с голосом нейросети. Длинный текст логичнее сразу собирать в аудиоформате: об этом отдельный материал про то, как создать подкаст с помощью нейросети.
Частые вопросы про бесплатную озвучку текста нейросетью
Можно ли озвучить текст в ChatGPT бесплатно?
На бесплатном плане доступен голосовой режим: справка OpenAI описывает его строкой «Limited access to GPT-Live-1 mini. Limits may change» и чисел в этой строке не приводит. Это разговор с моделью. Синтез произвольного текста в аудиофайл работает на отдельном эндпоинте API v1/audio/speech, и он платный.
Сколько стоит озвучка текста через API OpenAI?
У gpt-4o-mini-tts счёт в токенах: $0,60 за 1 млн токенов текста на входе и $12 за 1 млн аудио-токенов на выходе. У tts-1 и tts-1-hd счёт в символах: $15 и $30 за 1 млн символов соответственно. Единицы разные, поэтому цены этих моделей напрямую не сравниваются.
Почему API OpenAI не работает из России?
Бесплатный ярус API квалифицируется географией: «User must be in an allowed geography». В официальном списке поддерживаемых стран и территорий 208 пунктов, России среди них нет. Отдельный список для ChatGPT в справочном центре построен так же.
Какая бесплатная нейросеть озвучивает русский текст без регистрации?
Открытая модель Silero: файл v5_5_ru.pt весит 145 420 684 байта, скачивается один раз и работает локально без ключа. В нашем прогоне 17.09.2026 синтез 2,33 секунды звука занял 0,07 секунды на процессоре. Лицензия CC BY-NC-SA разрешает некоммерческое использование; для коммерческого берут модели v5_cis_base под MIT.
Почему нейросеть пропускает числа при озвучке текста?
У Silero в алфавите модели нет ни цифр, ни латинских букв. Всё, чего нет в наборе, выбрасывается молча. В нашем замере «Курс стоил 1500 рублей.» дал 1,39 с звука, а та же фраза прописью — 2,33 с. Лечится разворачиванием чисел в слова до синтеза.
Остался ли бесплатный тариф у SaluteSpeech?
Freemium давал 200 000 символов синтеза речи в месяц и 100 минут распознавания. С 15 июля 2026 года продажа новых пакетов и продление Freemium для физических лиц прекращены, подключение новых клиентов недоступно. Ранее купленные пакеты действуют до конца срока.