Содержание
- Какой способ обучения ChatGPT выбрать
- Способ 1. Кастомный GPT: обучить ChatGPT без кода
- Способ 2. RAG: обучить ChatGPT на своих данных через File Search
- Способ 3. Fine-tuning: дообучение модели на своих примерах
- Как подготовить базу знаний для обучения ChatGPT
- Интеграция обученной модели с ботом или сайтом
- Подводные камни при обучении ChatGPT
- Вопросы и ответы
- Что в итоге
Нейронные сети на Python: дообучение ChatGPT на своей базе знаний

Черновик готовит редакция с помощью ИИ. За стандарт издания отвечает главный редактор — Валерий Курземнек.
Как обучить Chat GPT под свои задачи: загрузить свою базу знаний в кастомный GPT без кода, подключить документы к API через инструмент File Search (это подход RAG) или дообучить модель методом fine-tuning. Третий путь OpenAI сворачивает, поэтому для работы с базой знаний основной способ сегодня — RAG. Ниже — все три варианта с рабочим кодом на Python и ценами из официальной документации OpenAI.
Главное на август 2026 года:
- Fine-tuning больше не принимает новых пользователей: OpenAI закрывает платформу поэтапно, финальная отсечка для действующих клиентов — 6 января 2027 года.
- Для ответов по своим документам OpenAI ведёт разработчиков к связке Responses API и File Search: файлы индексируются в векторном хранилище, модель ищет по ним при каждом запросе.
- Первый гигабайт векторного хранилища бесплатный, дальше — 0,10 $ за ГБ в день.
- Assistants API, на котором построены старые туториалы, отключается 26 августа 2026 года — такой код переносят на Responses API.
- Минимум данных для fine-tuning — 10 примеров, OpenAI рекомендует начинать с 50.
Какой способ обучения ChatGPT выбрать
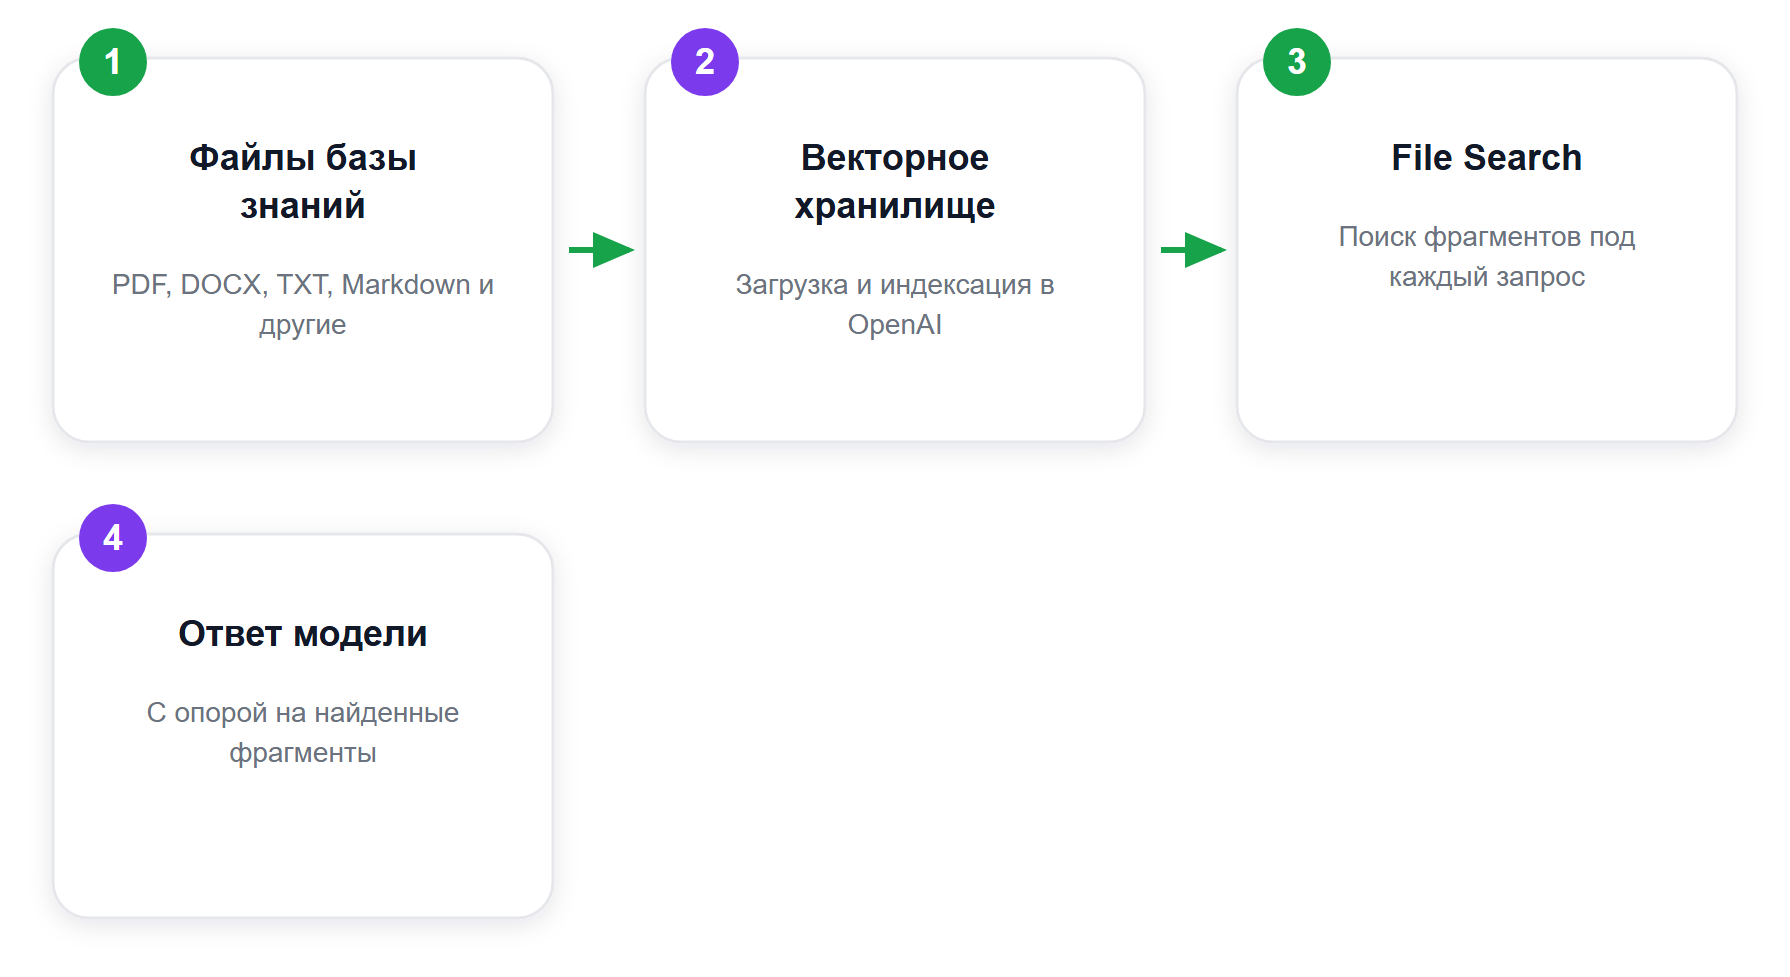
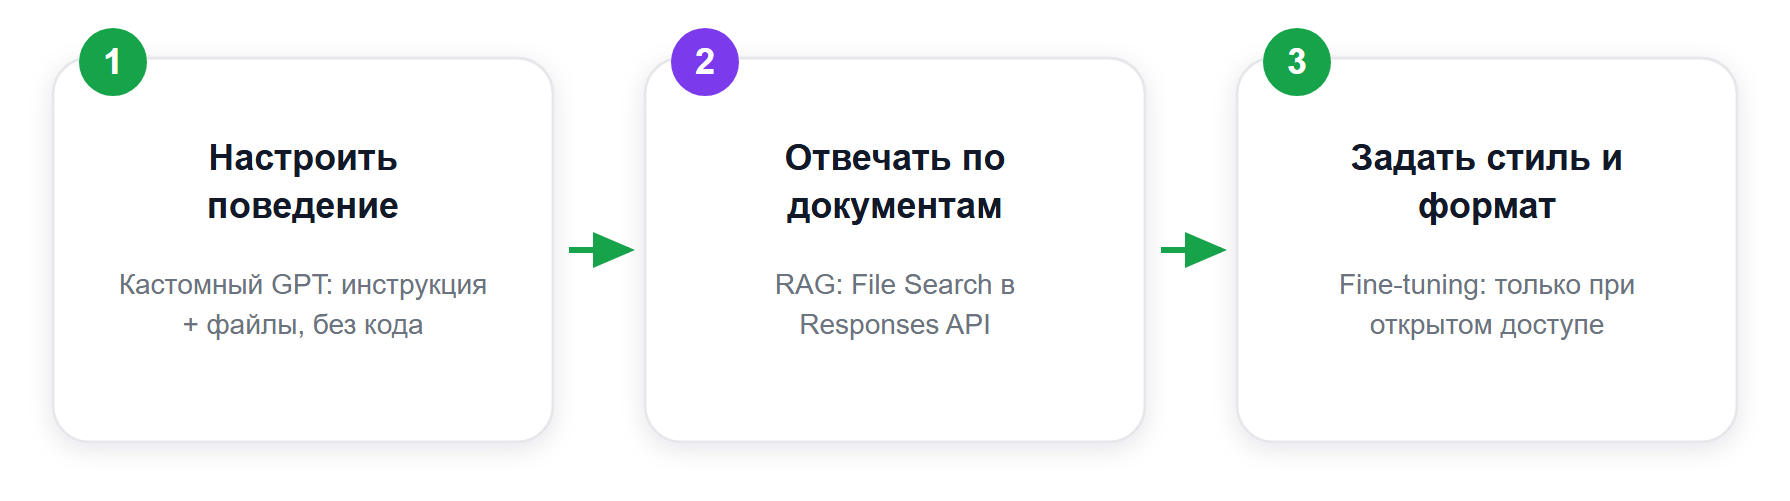
Словами «дообучение нейросети» в статьях называют три разных механизма. Кастомный GPT и системные инструкции ничего не обучают — вы описываете роль и прикладываете файлы, модель читает их при ответе. RAG подключает знания в момент запроса: модель ищет нужный фрагмент по вашим документам. Fine-tuning действительно дообучает — меняет веса модели на ваших примерах, но фактам учит плохо; его сила — стиль, формат и классификация.
| Способ | Что делает | Когда выбирать | Стоимость по прайсу OpenAI |
|---|---|---|---|
| Кастомный GPT | Инструкции и файлы знаний в интерфейсе ChatGPT | Быстрый старт, работа внутри ChatGPT | Не требует API-ключа |
| RAG (File Search) | Поиск по вашим документам при каждом запросе | База знаний, поддержка, документация | Хранилище 0,10 $ за ГБ в день, первый ГБ бесплатно, плюс токены модели |
| Fine-tuning | Дообучение весов модели на примерах | Стиль, формат, классификация; только при уже открытом доступе | Обучение gpt-4.1-mini — 5 $ за 1 млн токенов |
Способ 1. Кастомный GPT: обучить ChatGPT без кода
В интерфейсе ChatGPT есть редактор GPT: вы описываете роль ассистента текстовой инструкцией, прикладываете файлы базы знаний и получаете отдельного бота под задачу — без Python и без API. Инструкция работает как системный промпт, поэтому результат зависит от точности формулировок — это ровно то ремесло, которое разбирали в статье о рабочем дне промпт-инженера.
Ограничение способа: такой бот живёт внутри ChatGPT. Вывести его на сайт или в Telegram напрямую не получится — для этого нужен API. Если задача — виджет на сайте без программирования, посмотрите обзор no-code-конструкторов чат-ботов.
Способ 2. RAG: обучить ChatGPT на своих данных через File Search
RAG (retrieval-augmented generation) — основной способ научить модель отвечать по вашей базе знаний. Файлы загружаются в векторное хранилище OpenAI, а инструмент file_search в Responses API находит в них релевантные фрагменты при каждом запросе. Поддерживается больше двадцати форматов: PDF, DOCX, TXT, Markdown, HTML, JSON и файлы кода.
Рабочий пример на Python — SDK openai версии 1.x, ключ лежит в переменной окружения OPENAI_API_KEY:
from openai import OpenAI

client = OpenAI()

# 1. Векторное хранилище под базу знаний
store = client.vector_stores.create(name="knowledge-base")

# 2. Загрузка документа с ожиданием индексации
with open("faq_kompanii.pdf", "rb") as f:
    client.vector_stores.files.upload_and_poll(
        vector_store_id=store.id, file=f
    )
Когда файлы проиндексированы, модель отвечает с опорой на них:
response = client.responses.create(
    model="gpt-5-mini",
    input="Какие условия возврата действуют в нашем магазине?",
    tools=[{"type": "file_search", "vector_store_ids": [store.id]}],
)
print(response.output_text)
Типичный сценарий — бот, который отвечает клиентам по регламентам компании: бизнес-сторону такой автоматизации разбирали в материале про AI в клиентском сервисе и поддержке. Учтите: старые туториалы строят тот же сценарий на Assistants API, а его OpenAI отключает 26 августа 2026 года — новый код пишут сразу на Responses API.
Способ 3. Fine-tuning: дообучение модели на своих примерах
Fine-tuning меняет веса модели: вы показываете десятки пар «запрос — эталонный ответ», и модель перенимает стиль, формат и логику разметки. Минимум — 10 примеров, OpenAI рекомендует начинать с 50 качественных демонстраций; заметные улучшения обычно появляются на 50–100 примерах.
Платформа при этом сворачивается. С 7 мая 2026 года дообучение недоступно организациям, которые не запускали его раньше, а с 6 января 2027 года создавать новые задания не смогут и действующие клиенты — полный график опубликован в календаре деприкаций OpenAI. Уже дообученные модели продолжат отвечать, пока работают их базовые модели. Планировать fine-tuning с нуля в 2026 году поздно — эта секция для тех, у кого доступ уже открыт.
Данные готовят в формате JSONL: один обучающий пример на строку, каждый — диалог целиком.
{"messages": [{"role": "system", "content": "Ты консультант интернет-магазина, отвечаешь кратко и по регламенту."}, {"role": "user", "content": "Как оформить возврат?"}, {"role": "assistant", "content": "Заполните заявление в личном кабинете, раздел «Заказы». Срок возврата — 14 дней с момента получения."}]}
Запуск обучения на Python:
from openai import OpenAI

client = OpenAI()

f = client.files.create(
    file=open("train.jsonl", "rb"), purpose="fine-tune"
)

job = client.fine_tuning.jobs.create(
    training_file=f.id,
    model="gpt-4.1-mini-2025-04-14",
)
print(job.id)  # статус: client.fine_tuning.jobs.retrieve(job.id)
Из методов доступны supervised fine-tuning и DPO для линейки gpt-4.1, reinforcement fine-tuning для o4-mini и дообучение по изображениям для gpt-4o. Обучение gpt-4.1-mini стоит 5 $ за 1 млн токенов датасета, полной gpt-4.1 — 25 $.
Как подготовить базу знаний для обучения ChatGPT
Качество ответов определяют данные — модель лишь ищет по тому, что вы ей дали.
- Собирайте то, о чём реально спрашивают: переписки поддержки, FAQ, регламенты, описания товаров и услуг.
- Вычищайте дубли и устаревшие редакции документов: при поиске конфликтующие фрагменты попадают в ответ вместе, и модель начинает противоречить сама себе.
- Структурируйте текст: заголовки, короткие разделы и пары «вопрос — ответ» находятся точнее, чем сплошное полотно.
- Обновляйте хранилище по расписанию: RAG подхватывает новые файлы без переобучения — главное практическое преимущество перед fine-tuning.
Интеграция обученной модели с ботом или сайтом
Вызов client.responses.create с инструментом file_search — обычный HTTP-запрос, поэтому обученного ассистента встраивают в любой канал: бэкенд сайта, Telegram-бот, CRM. Идентификатор векторного хранилища сохраняют в конфигурации приложения, и все каналы работают с одной базой знаний — обновили файлы один раз, ответы поменялись везде.
Подводные камни при обучении ChatGPT
- Галлюцинации. Если в базе нет ответа, модель может уверенно сочинить его. Пропишите в инструкции: отвечать только по найденным фрагментам, при их отсутствии прямо говорить, что данных нет.
- Путаница методов. Fine-tuning не выучит содержание базы знаний: факты — в RAG, стиль и формат — в fine-tuning.
- Расход токенов. Повторяющиеся вопросы дешевле обслуживать кэшем готовых ответов на стороне приложения, чем каждый раз обращаться к модели.
- Конфиденциальность. Персональные данные клиентов перед загрузкой в облачное хранилище обезличивают. Если данные вообще нельзя выносить наружу, присмотритесь к локальным нейросетям — база знаний остаётся на вашем сервере.
Вопросы и ответы
Чем RAG отличается от fine-tuning?
RAG подключает знания в момент запроса: модель ищет по вашим документам и отвечает с опорой на найденные фрагменты. Fine-tuning меняет веса модели на обучающих примерах. Для фактов и базы знаний нужен RAG, для стиля и формата ответов — fine-tuning.
Сколько примеров нужно для fine-tuning?
Минимум 10, OpenAI рекомендует начинать с 50 качественных примеров и оценивать результат. Заметные улучшения обычно видны на 50–100 примерах.
Правда ли, что fine-tuning в OpenAI закрывается?
Да, поэтапно. С 7 мая 2026 года платформа недоступна организациям, которые раньше её не использовали, с 6 января 2027 года новые задания не смогут создавать и действующие клиенты. Уже дообученные модели продолжат работать, пока не выведены из эксплуатации их базовые модели.
Сколько стоит обучить ChatGPT на своих данных?
В варианте RAG первый гигабайт векторного хранилища бесплатный, дальше — 0,10 $ за ГБ в день, плюс оплата токенов модели по обычному тарифу. Обучение методом fine-tuning на gpt-4.1-mini стоит 5 $ за 1 млн токенов датасета.
Что в итоге
Рабочая последовательность выглядит так: начните с кастомного GPT и точной инструкции, переходите на File Search, когда ассистента нужно вывести за пределы ChatGPT, а fine-tuning оставьте под задачи стиля — с поправкой на график закрытия платформы. База знаний при этом важнее выбора метода: чистые, актуальные, структурированные документы улучшают ответы сильнее, чем любая смена модели.