Содержание
- Как устроена линейная регрессия
- Класс LinearRegression в sklearn: параметры и атрибуты
- Пример: линейная регрессия sklearn на ценах на недвижимость
- Как читать r2_score и MSE
- LinearRegression, Ridge, Lasso и SGDRegressor: что выбрать
- Частые ошибки
- Куда двигаться после линейной регрессии
- Вопросы и ответы
- Заключение
Data Science на Python: линейная регрессия

Черновик готовит редакция с помощью ИИ. За стандарт издания отвечает главный редактор — Валерий Курземнек.
Линейная регрессия sklearn — это класс LinearRegression из модуля sklearn.linear_model. Метод fit обучает модель по методу наименьших квадратов, predict возвращает прогноз, score считает коэффициент детерминации R². Разберём полный цикл на примере цен на недвижимость: подготовка данных, разбиение на выборки, обучение, оценка по R² и MSE, прогноз для новой квартиры. Код из статьи запускается целиком и не требует внешних CSV-файлов.
- LinearRegression — обычный метод наименьших квадратов: внутри вызывается scipy.linalg.lstsq.
- Схема работы: train_test_split → fit → predict → r2_score и mean_squared_error.
- R² равен 1.0 у идеальной модели и 0.0 у модели, которая всегда предсказывает среднее; бывают и отрицательные значения.
- Ridge добавляет к той же модели L2-регуляризацию, Lasso — L1 с обнулением лишних коэффициентов.
- Пример ниже проверен на scikit-learn 1.9: коэффициенты, R² и прогноз приведены из реального запуска.
Как устроена линейная регрессия
Линейная регрессия — метод моделирования связи между зависимой переменной и одной или несколькими независимыми. Модель ищет такие коэффициенты, при которых взвешенная сумма признаков максимально близко воспроизводит целевое значение: y = β₀ + β₁x₁ + β₂x₂ + … + ε. Для цен на жильё это читается так: цена складывается из вклада площади, вклада количества комнат и вклада возраста дома плюс необъяснённый остаток.
Ключевые понятия
- Зависимая переменная (y): величина, которую нужно предсказать, — в нашем примере цена.
- Независимые переменные (X): признаки, на основе которых делается предсказание, — площадь, комнаты, возраст.
- Коэффициенты (β): параметры модели, определяющие вклад каждого признака. После обучения лежат в атрибуте coef_.
- Свободный член (β₀): значение прогноза при нулевых признаках, атрибут intercept_.
- Ошибка модели (ε): разница между наблюдаемыми и предсказанными значениями.
Сильные стороны и ограничения
Метод простой, быстрый и интерпретируемый: каждый коэффициент прямо показывает, на сколько изменится прогноз при изменении признака на единицу. За это приходится платить тремя ограничениями. Модель предполагает линейную зависимость между признаками и целью — кривые зависимости она спрямляет. Она чувствительна к выбросам: одна аномальная сделка заметно сдвигает коэффициенты. И при сильной корреляции признаков между собой (мультиколлинеарности) коэффициенты становятся нестабильными — эту проблему решает Ridge-регрессия, о ней ниже. Если вы только начинаете путь в анализе данных, общая картина области — в статье Data Science на Python: разгадывание будущего через данные.
Класс LinearRegression в sklearn: параметры и атрибуты
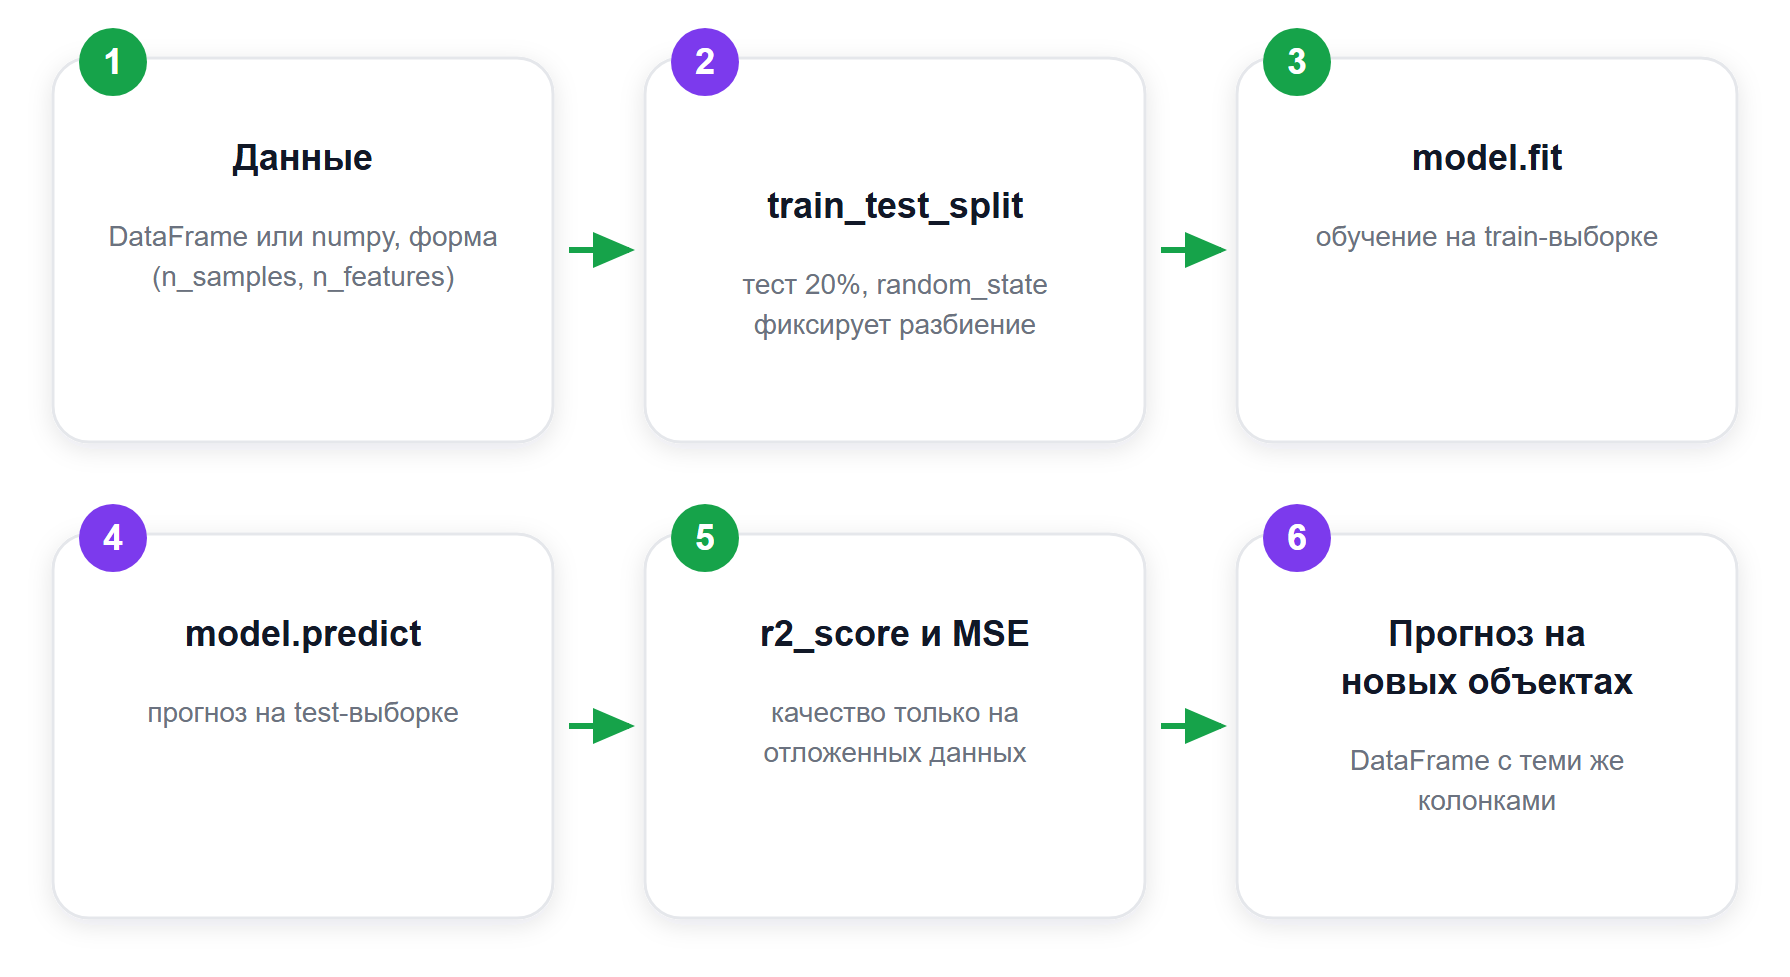
Именно так линейная регрессия sklearn выглядит в коде: импортируется класс, создаётся объект, дальше работают три метода — fit, predict и score. Сигнатура конструктора в scikit-learn 1.9:
from sklearn.linear_model import LinearRegression

model = LinearRegression(
    fit_intercept=True,
    copy_X=True,
    tol=1e-06,
    n_jobs=None,
    positive=False
)
По документации scikit-learn, внутри класса нет градиентного спуска: это обычный метод наименьших квадратов, обёрнутый в интерфейс модели, — на плотных данных решение считает scipy.linalg.lstsq, а при positive=True — scipy.optimize.nnls. Решение точное: итераций, подбора шага обучения и критериев остановки здесь нет.
| Параметр | По умолчанию | Что делает |
| fit_intercept | True | Считать ли свободный член β₀. При False данные должны быть заранее центрированы |
| copy_X | True | Копировать ли матрицу признаков. При False исходный массив может быть перезаписан |
| tol | 1e-06 | Точность решения: критерий сходимости внутреннего решателя |
| n_jobs | None | Число потоков. Даёт выигрыш только при нескольких целевых переменных и разреженном X либо при positive=True |
| positive | False | При True коэффициенты принудительно неотрицательные. Работает только с плотными массивами |
После вызова fit у модели появляются атрибуты:
- coef_ — коэффициенты при признаках, массив длины n_features;
- intercept_ — свободный член; равен 0.0, если fit_intercept=False;
- rank_ и singular_ — ранг и сингулярные числа матрицы X, доступны на плотных данных;
- n_features_in_ и feature_names_in_ — сколько признаков и с какими именами модель видела при обучении.
Метод score(X, y) возвращает коэффициент детерминации R² — тот же результат, что r2_score из sklearn.metrics.
Пример: линейная регрессия sklearn на ценах на недвижимость
Чтобы пример воспроизводился у любого читателя, данные генерируются кодом — скачивать CSV-файл не нужно. Мы создаём 300 квартир с площадью, количеством комнат и возрастом дома, а цену собираем по известной формуле: 90 000 ₽ за квадратный метр, 250 000 ₽ за комнату, минус 15 000 ₽ за каждый год возраста, плюс случайный рыночный шум. Такой приём даёт честную проверку: мы заранее знаем истинные коэффициенты и увидим, сумеет ли модель их восстановить.
Шаг 1: подготовка данных
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)
n = 300

area = rng.uniform(30, 150, n).round(1)      # площадь, кв. м
rooms = rng.integers(1, 6, n)                # количество комнат
age = rng.integers(0, 40, n)                 # возраст дома, лет

# цена = вклад площади + вклад комнат - вклад возраста + рыночный шум
price = 90_000 * area + 250_000 * rooms - 15_000 * age
price = price + rng.normal(0, 400_000, n)

data = pd.DataFrame({
    'area': area,
    'rooms': rooms,
    'age': age,
    'price': price.round()
})
print(data.head(3))
Первые строки таблицы выглядят так:
    area  rooms  age       price
0  122.9      4    0  12560180.0
1   82.7      4    1   8326993.0
2  133.0      4    8  12995382.0
Шаг 2: разбиение на обучающую и тестовую выборки
from sklearn.model_selection import train_test_split

X = data[['area', 'rooms', 'age']]
y = data['price']

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=0
)
print(X_train.shape, X_test.shape)  # (240, 3) (60, 3)
Тестовые 20% данных модель не увидит при обучении — на них мы проверим качество прогноза. Параметр random_state фиксирует разбиение, чтобы результат воспроизводился от запуска к запуску.
Шаг 3: обучение модели
from sklearn.linear_model import LinearRegression

model = LinearRegression()
model.fit(X_train, y_train)

for name, coef in zip(X.columns, model.coef_):
    print(f'{name}: {coef:.0f}')
print(f'intercept_: {model.intercept_:.0f}')
Вывод при запуске на scikit-learn 1.9:
area: 90629
rooms: 254452
age: -14122
intercept_: -118259
Модель восстановила заложенные зависимости: 90 629 против истинных 90 000 за метр, 254 452 против 250 000 за комнату, −14 122 против −15 000 за год возраста. Отклонения — следствие шума в 400 000 ₽, который мы сами добавили в цены.
Шаг 4: оценка качества
from sklearn.metrics import mean_squared_error, r2_score

y_pred = model.predict(X_test)

mse = mean_squared_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)

print(f'MSE: {mse:.0f}')    # 187454214425
print(f'RMSE: {mse ** 0.5:.0f}')  # 432960
print(f'R2: {r2:.3f}')      # 0.982
R² = 0.982 — модель объяснила 98,2% разброса цен на тестовой выборке. Корень из MSE (RMSE) равен 432 960 ₽ и почти совпал с величиной шума 400 000 ₽, который мы заложили в данные: модель выжала из признаков практически всё, остаток — чистая случайность. Это полезный ориентир и для рабочих задач: если RMSE перестал падать при добавлении признаков, возможно, вы упёрлись в естественный шум данных.
Шаг 5: прогноз для новой квартиры
new_flat = pd.DataFrame(
    [[120, 4, 5]],
    columns=['area', 'rooms', 'age']
)
predicted_price = model.predict(new_flat)
print(f'Прогноз цены: {predicted_price[0]:.0f}')  # 11704482
Для квартиры площадью 120 кв. м с четырьмя комнатами в доме пятилетнего возраста модель предсказала 11 704 482 ₽. Обратите внимание: новый объект передаётся как DataFrame с теми же именами колонок, что и при обучении, — почему это важно, разберём в разделе про ошибки.
Как читать r2_score и MSE
Документация scikit-learn задаёт для коэффициента детерминации три опорные точки. Лучшее значение — 1.0: прогноз совпал с фактом. Значение 0.0 получает константная модель, которая всегда предсказывает среднее значение y и игнорирует признаки. Отрицательный результат возможен и означает, что модель хуже такой константы: для y_true = [3, -0.5, 2, 7] и y_pred = [2.5, 0.0, 2, 8] функция r2_score возвращает 0.948, а для перевёрнутого прогноза y_pred = [3, 2, 1] при y_true = [1, 2, 3] — ровно −3.0.
MSE измеряется в квадратах единиц целевой переменной — «квадратные рубли» напрямую не интерпретируются, поэтому на практике смотрят RMSE (корень из MSE): он в тех же единицах, что и цена, и читается как типичная ошибка прогноза. Сравнивать MSE двух моделей имеет смысл только на одной и той же выборке.
LinearRegression, Ridge, Lasso и SGDRegressor: что выбрать
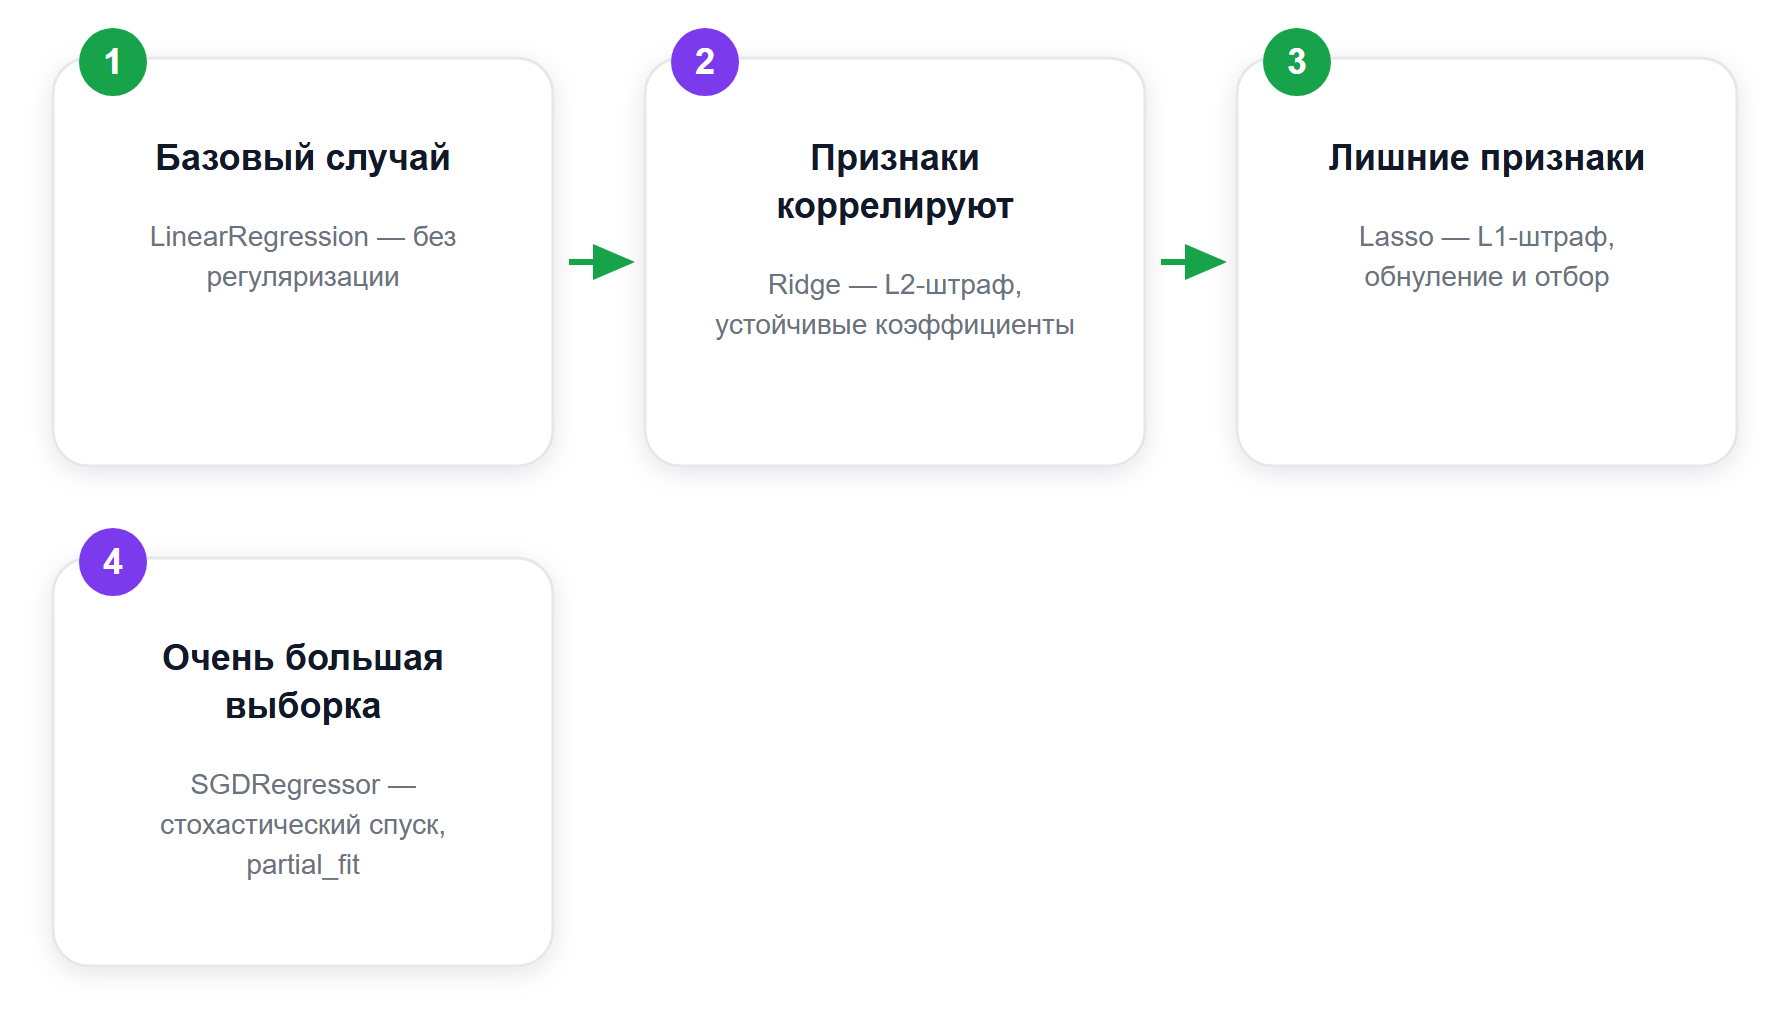
LinearRegression — базовый вариант без регуляризации. В sklearn у него есть три близких родственника, и выбор между ними диктуют сами данные.
| Модель | Регуляризация | Когда брать |
| LinearRegression | Нет | Признаков немного, они слабо коррелируют между собой, нужна прямая интерпретация коэффициентов |
| Ridge | L2 — штраф за размер коэффициентов | Признаки коррелируют (мультиколлинеарность): штраф делает коэффициенты устойчивыми к коллинеарности |
| Lasso | L1 — штраф за сумму модулей | Признаков много и часть лишние: Lasso обнуляет ненужные коэффициенты и работает как отбор признаков |
| SGDRegressor | Настраиваемая (L1, L2, elasticnet) | Очень большая выборка: обучение стохастическим градиентным спуском, метод partial_fit дообучает модель порциями |
Руководство scikit-learn прямо описывает эту связку: оценки обычного метода наименьших квадратов опираются на независимость признаков, и при коррелирующих колонках прогноз становится сверхчувствительным к случайным ошибкам; Ridge решает эту проблему штрафом за размер коэффициентов, Lasso оценивает разреженные коэффициенты и способен ставить их точно в ноль, а стохастический градиентный спуск полезен, когда число объектов и признаков очень велико. Все четыре класса живут в одном модуле sklearn.linear_model и взаимозаменяемы по интерфейсу: те же fit, predict и score.
Частые ошибки
Три ситуации, на которые уходит больше всего времени у новичков. Каждую мы воспроизвели на scikit-learn 1.9 — предупреждения и ошибки приведены дословно.
Прогноз списком после обучения на DataFrame
Вызов model.predict([[120, 4, 5]]) после обучения на DataFrame срабатывает, но выдаёт предупреждение: «X does not have valid feature names, but LinearRegression was fitted with feature names». Модель запомнила имена колонок и не может проверить, что признаки переданы в правильном порядке. Лечение — передавать новые объекты как DataFrame с теми же колонками, как в шаге 5 примера.
Одномерный массив вместо двумерного
Если признак один и X передан как плоский вектор, fit и predict падают с ошибкой «Expected 2D array, got 1D array instead» и подсказкой в тексте: преобразуйте данные через array.reshape(-1, 1), если у вас один признак, или array.reshape(1, -1), если один объект. Матрица признаков всегда обязана иметь форму (n_samples, n_features), даже когда признак единственный.
Оценка на обучающей выборке
R², посчитанный на тех же данных, где модель училась, систематически завышен — модель частично запомнила шум. Качество судят только по отложенной тестовой выборке, как в шаге 4, а при малых данных — по кросс-валидации через cross_val_score.
Куда двигаться после линейной регрессии
Линейная регрессия — задача обучения с учителем: у каждой строки данных есть правильный ответ. Второй базовый тип моделей работает без ответов и сам находит группы похожих объектов — это разобрано в статье Data Science на Python: кластеризация как основной тип модели. А если вы выбираете, какой инструмент учить первым для работы с данными, сравнение двух главных кандидатов — в материале SQL против Python: что следует изучить.
Вопросы и ответы
Как импортировать линейную регрессию из sklearn?
Командой from sklearn.linear_model import LinearRegression. Дальше создайте объект model = LinearRegression() и вызовите model.fit(X, y), где X — таблица признаков формы (n_samples, n_features), а y — целевая переменная.
Что показывает r2_score в sklearn?
Коэффициент детерминации R² — долю разброса целевой переменной, которую объяснила модель. Лучшее значение — 1.0. Модель, которая всегда предсказывает среднее значение y, получает ровно 0.0, а прогноз хуже такой константы уходит в минус.
Может ли R² быть отрицательным?
Да. По документации scikit-learn R² может быть сколь угодно отрицательным: для y_true = [1, 2, 3] и y_pred = [3, 2, 1] функция r2_score возвращает −3.0. Отрицательное значение означает, что модель предсказывает хуже, чем константа, равная среднему значению y.
Чем LinearRegression отличается от Ridge и Lasso?
LinearRegression решает задачу обычным методом наименьших квадратов без регуляризации. Ridge добавляет L2-штраф и делает коэффициенты устойчивыми при коррелирующих признаках. Lasso добавляет L1-штраф, обнуляет часть коэффициентов и тем самым отбирает признаки.
Можно ли обучить LinearRegression на numpy-массивах без pandas?
Да. Метод fit принимает любой array-like формы (n_samples, n_features), numpy-массив подходит без преобразований. Единственное требование — двумерная форма X: для одного признака вектор преобразуют через reshape(-1, 1).
Заключение
Линейная регрессия в sklearn — это пять строк рабочего кода: импорт LinearRegression, fit на обучающей выборке, predict на тестовой, r2_score и MSE для оценки. В нашем прогоне модель восстановила заложенные в данные коэффициенты с точностью до рыночного шума и дала R² = 0.982. Когда признаки начинают коррелировать или их становится слишком много, тот же интерфейс предлагают Ridge, Lasso и SGDRegressor — переход на них не потребует переписывать пайплайн.