Содержание
- Какая нейросеть для преобразования аудио в текст подходит под задачу
- Выбор языка и подготовка данных
- Использование нейросетей для преобразования аудио в текст: как это устроено
- Пример кода для преобразования аудио в текст с использованием нейросетей
- Рекомендации по использованию нейросетей
- Ошибки, из-за которых расшифровка выходит плохой
- Вопросы и ответы
- Заключение
Преобразование аудио в текст с транскрибацией при помощи нейросетей

Черновик готовит редакция с помощью ИИ. За стандарт издания отвечает главный редактор — Валерий Курземнек.
Нейросеть для преобразования аудио в текст — это модель распознавания речи, которая превращает звуковую волну в готовую расшифровку. Рабочих вариантов три: Whisper от OpenAI на своём компьютере, облачные API вроде SaluteSpeech и офлайн-движок Vosk. Выбор между ними задают язык записи, длина файла и требование не выпускать звук за пределы своего контура.
Дальше — сравнение решений по документации разработчиков, подготовка звука, устройство самих моделей и код, который запускается без правок. Коротко то, что заберёте из статьи:
- код и веса Whisper выпущены под лицензией MIT — модель ставится локально, поминутной оплаты нет;
- размер модели подбирают по видеопамяти: от tiny (39 M параметров, ~1 ГБ) до large (1550 M, ~10 ГБ);
- у облачных сервисов главное ограничение — вес файла: 25 МБ на запрос у Audio API OpenAI, 2 Мб на синхронное распознавание у SaluteSpeech;
- точность поднимает подготовка звука — моно, 16 кГц, снятый фон, заранее переданный список терминов;
- качество Whisper заметно зависит от языка, и это оговорено в самом репозитории OpenAI.
Расшифровка нужна не только записям созвонов: с неё начинается конспект лекции, черновик подкаста, субтитры к ролику, база для поиска по архиву интервью. Смежные разборы блога — нейросети для учёбы, как улучшить видео при помощи нейросетей и 10 нейросетей, которые сейчас в тренде.
В этом примере мы будем использовать нейросети. Подробнее о них – тут.
Какая нейросеть для преобразования аудио в текст подходит под задачу
Сравнение собрано по официальной документации четырёх решений. Цифры взяты оттуда же, поэтому их можно закладывать в расчёт сразу.
| Решение | Где считается | Ограничения из документации | Когда брать |
|---|---|---|---|
| Whisper (openai-whisper) | свой компьютер или сервер | шесть размеров моделей: tiny 39 M (~1 ГБ видеопамяти), base 74 M (~1 ГБ), small 244 M (~2 ГБ), medium 769 M (~5 ГБ), turbo 809 M (~6 ГБ), large 1550 M (~10 ГБ); лицензия MIT | записи не должны покидать контур; объём большой, платить за минуты не хочется |
| Audio API OpenAI (whisper-1, gpt-4o-transcribe) | облако | файл до 25 МБ; форматы mp3, mp4, mpeg, mpga, m4a, wav, webm; whisper-1 поддерживает 98 языков и выдаёт таймкоды по словам и сегментам | нужны субтитры с таймкодами и запуск без своего железа |
| SaluteSpeech (Сбер) | облако | синхронное распознавание по HTTP — до 2 Мб и 1 канал, асинхронное и потоковое — до 1 Гб; форматы PCM_S16LE, OPUS, MP3, FLAC, ALAW, MULAW, G-729 | длинные многоканальные записи звонков и совещаний |
| Vosk | офлайн, вплоть до Raspberry Pi и телефона | более 20 языков и диалектов; портативные модели весят по 50 Мб, есть серверные покрупнее | распознавание без интернета и на слабом железе |
Разница между строками таблицы — это разница в стоимости ошибки. Локальный Whisper обойдётся во время видеокарты и час настройки, зато поток записей потом бесплатен. Облачные API отдают результат сразу, но упираются в вес файла: часовое совещание в mp3 легко перешагивает и 25 МБ, и 2 Мб, поэтому длинную запись режут на части либо отправляют в асинхронный режим.
Выбор языка и подготовка данных
До того как включать нейросеть, определяют язык расшифровки. От него зависят и точность, и сам список пригодных моделей: многоязычные версии Whisper (tiny, base, small, medium, large) слышат русский, а модели с суффиксом .en обучены только на английском. В репозитории OpenAI прямо сказано, что качество Whisper широко варьируется от языка к языку, поэтому проверку начинают с двухминутного фрагмента своей записи.
- Для качественной работы нейросети нужны объёмные датасеты — аудиозаписи с расшифровкой. Чем больше таких данных на выбранном языке, тем выше точность.
- Убедитесь, что под ваш язык есть готовая модель. Vosk заявляет более 20 языков и диалектов, включая русский, украинский и казахский; у Whisper язык задают параметром
--language. - Ориентируйтесь на язык, на котором говорят ваши пользователи. Для мультиязычного сервиса это означает две разные модели и два разных словаря терминов.
- Учитывайте фонетику. Языки с богатой морфологией и свободным порядком слов распознаются тяжелее, и ошибок в окончаниях там будет больше.
Дальше собирают исходные данные. Полноценный датасет для дообучения включает три части: аудиофайлы — записи речи без сильных шумов; текстовые транскрипты — точные расшифровки с разметкой пауз и ударений, если они важны; метки времени — соответствие отрезков звука фрагментам текста (time-aligned data), без которого не обучаются модели на выравнивании вроде CTC.
Технически подготовка сводится к одной команде. Приведите файлы к единому формату — WAV, 16 кГц, моно, — и уберите фон:
ffmpeg -i meeting.m4a -ac 1 -ar 16000 meeting.wavОдноканальный звук на 16 кГц — формат, в котором работают акустические модели этого класса; лишние каналы и завышенная частота дискретизации дадут тот же результат при большем весе файла. Нормализация громкости и снятый шум прибавляют точности до того, как запись попадёт в любой сервис из таблицы выше.
Использование нейросетей для преобразования аудио в текст: как это устроено
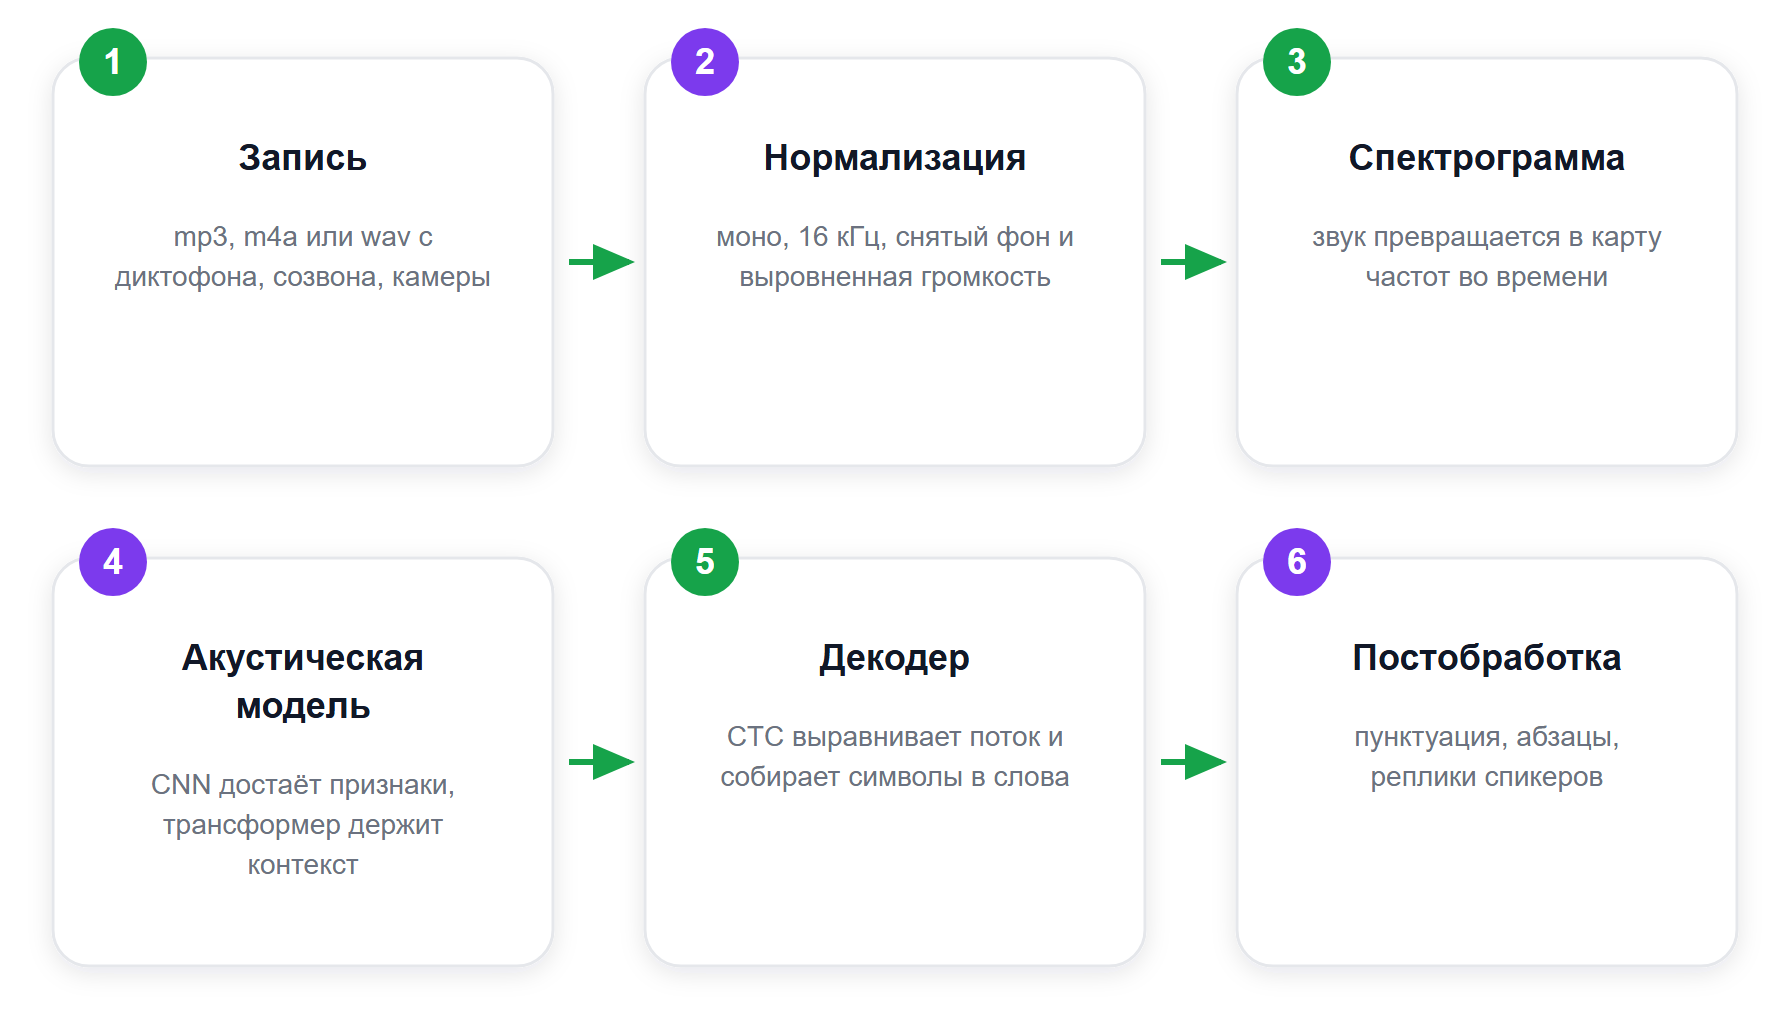
Распознавание речи разбивается на четыре шага: звук нормализуют, переводят в спектрограмму, прогоняют через акустическую модель и декодируют в символы. Весь путь целиком собран на схеме к разделу. Архитектуры внутри различаются, и понимание разницы объясняет, почему одна модель путает окончания, а другая теряет конец фразы.
Рекуррентные нейронные сети (RNN)
RNN обрабатывают последовательности и держат контекст предыдущих отрезков: значение звука зависит от соседних. Отсюда их слабость на длинных записях — контекст постепенно размывается, и в конце часовой лекции ошибок больше, чем в начале.
Свёрточные нейронные сети (CNN)
CNN работают на этапе предварительной обработки: вытаскивают признаки из спектрограммы. Они хорошо ловят локальные закономерности и устойчивы к шуму, поэтому их ставят первым слоем перед моделью последовательностей.
Connectionist Temporal Classification (CTC)
CTC обучает сеть распознавать последовательности без поминутной разметки: известно, что в записи сказано, но неизвестно, какой звук какому символу соответствует. Метод сам выравнивает аудиопоток с текстовой последовательностью и снимает с человека самую дорогую часть разметки.
Трансформеры
Трансформеры пришли из обработки текста и заняли современные системы распознавания: на них построены Whisper и Wav2Vec 2.0. Они видят глобальный контекст, поэтому вытягивают смысл фразы там, где рекуррентная сеть уже потеряла нить. Whisper дополнительно решает три задачи сразу — распознавание, перевод и определение языка.
Комбинированные подходы
Практические решения гибридны: CNN достаёт признаки, трансформер или RNN разбирает последовательность, CTC или отдельный декодер собирает текст. Такая связка балансирует скорость и точность.
Что это даёт на практике: адаптивность к акцентам и тембрам, устойчивость к естественной, неподготовленной речи, масштабирование на разные языки и возможность дообучить модель под отраслевую терминологию. Архитектура определяет, где именно модель ошибётся, а подготовка звука определяет, как часто.
Пример кода для преобразования аудио в текст с использованием нейросетей

Быстрее всего проверить идею на локальном Whisper. Установка занимает две команды: пакет и системный конвертер, без которого модель не прочитает mp3. Порядок шагов собран на схеме к разделу, а команды приведены по официальному репозиторию OpenAI.
pip install -U openai-whisper
sudo apt update && sudo apt install ffmpeg
Расшифровка из командной строки — одна строка. Модель turbo стоит по умолчанию; язык задают отдельным параметром, иначе модель определит его сама:
whisper meeting.wav --model turbo --language RussianТот же результат из Python — четыре строки. Метод transcribe() читает файл целиком и обрабатывает звук скользящим окном в 30 секунд:
import whisper

model = whisper.load_model("turbo")
result = model.transcribe("audio.mp3")
print(result["text"])
Две оговорки из документации, которые экономят вечер. Первая: turbo — ускоренная версия large-v3, она не обучена задаче перевода, поэтому для перевода речи на английский берут многоязычные tiny, base, small, medium или large. Вторая: скорости в таблице моделей измерены на видеокарте A100, и реальная скорость зависит от языка, темпа речи и железа.
Прежняя версия этой статьи предлагала другой пример — со спектрограммой через librosa и загрузкой готового файла speech_to_text_model.h5. Такой код не запустится: numpy в нём используется без импорта, а модели с именем speech_to_text_model.h5 в открытом доступе нет — это заглушка, вместо которой каждый подставляет свою обученную сеть. Пример выше даёт расшифровку на реальном файле сразу после установки.
Рекомендации по использованию нейросетей
- Выбор модели. Отталкивайтесь от видеопамяти и требуемой скорости. По таблице репозитория small просит около 2 ГБ и работает примерно в 4 раза быстрее large, turbo — около 6 ГБ при восьмикратном ускорении. Для черновой расшифровки хватает small, для публикуемого текста берут turbo или large.
- Предобученная модель вместо своей. Обучение с нуля требует тысяч часов размеченного звука. Если такого корпуса нет, берут готовую модель и дообучают её на своих записях — сотни примеров уже дают заметный прирост на отраслевой лексике.
- Аугментация данных. Изменение скорости, добавление шума, сдвиг тональности расширяют обучающую выборку и делают модель устойчивее к плохим записям.
- Словарь терминов. Названия продуктов, фамилии и аббревиатуры передавайте модели подсказкой или списком замен на постобработке — распознаватель сам их не угадает.
- Проверка на фрагменте. Прогоняйте две минуты записи через два-три решения из таблицы и сравнивайте расшифровки глазами. Это дешевле, чем обрабатывать архив и обнаружить систематическую ошибку в конце.
Ошибки, из-за которых расшифровка выходит плохой
Разбор чужих неудачных расшифровок показывает один и тот же набор причин, и почти все они относятся к записи, а модель лишь проявляет их в тексте.
- Один микрофон на переговорную. Дальние голоса приходят тише реверберации, и модель отдаёт связный текст только за того, кто сидел ближе.
- Фоновая музыка и эхо. Спектр музыки перекрывает речевой диапазон, распознаватель начинает выдумывать слова там, где речи нет.
- Перебивания. На наложенных голосах падает любая модель: две реплики сворачиваются в одну строку без пометки о смене говорящего.
- Файл целиком в облако. Часовая запись перешагивает лимиты 25 МБ и 2 Мб, и запрос обрывается на загрузке. Длинное аудио режут по паузам или отправляют в асинхронный режим.
- Никакой постобработки. Сырая расшифровка идёт сплошным потоком: абзацы, реплики спикеров и заголовки расставляют уже текстовой моделью.
Вопросы и ответы
Какая нейросеть переводит аудио в текст на русском языке?
На русском работают Whisper от OpenAI, облачное распознавание SaluteSpeech от Сбера и офлайн-движок Vosk. По документации OpenAI модель whisper-1 поддерживает 98 языков, точность при этом различается от языка к языку. Vosk заявляет более 20 языков и диалектов, включая русский.
Можно ли преобразовать аудио в текст бесплатно?
Да, если считать у себя. Код и веса Whisper выпущены под лицензией MIT, портативные модели Vosk весят по 50 Мб и работают офлайн. Расходы сводятся к электричеству и времени видеокарты, оплата за минуты появляется только у облачных API.
Что нужно, чтобы запустить Whisper на своём компьютере?
Python с пакетом openai-whisper, установленный ffmpeg и видеопамять под выбранный размер модели: по таблице репозитория это около 1 ГБ для tiny и base, 2 ГБ для small, 5 ГБ для medium, 6 ГБ для turbo и 10 ГБ для large.
Почему нейросеть путает термины, имена и названия?
Модель подбирает наиболее вероятную последовательность слов, поэтому редкие термины заменяет похожими по звучанию. Помогают три приёма: список терминов в подсказке, дообучение на своих записях и чистка звука до распознавания.
Чем транскрибация отличается от субтитров?
Транскрибация даёт сплошной текст, субтитрам дополнительно нужны таймкоды. В документации OpenAI на этот случай прямо рекомендована модель whisper-1: она возвращает временные метки по словам и по сегментам.
Заключение
Преобразование аудио в текст с транскрибацией на выбранном языке перестало быть задачей для исследователя: модель ставится одной командой, а качество определяют язык, размер модели и чистота записи. Практический маршрут короткий — привести звук к 16 кГц моно, прогнать две минуты через локальный Whisper и облачный сервис, сравнить расшифровки и уже под результат выбрать решение из таблицы. Материал обновлён в августе 2026 года: сравнение сервисов, лимиты и код приведены к текущей документации OpenAI, Сбера и проекта Vosk.