
Анализ данных на Python держится на четырёх библиотеках: pandas читает и чистит таблицы, NumPy выполняет вычисления над массивами, Matplotlib строит графики, scikit-learn обучает модели. Все ставятся одной командой pip install и работают в бесплатном Jupyter Notebook или Google Colab. Ниже — рабочий маршрут: настройка окружения, выбор библиотек, сквозной пример кода и сборка собственного приложения.
Коротко о том, что внутри:
- какие задачи закрывает анализ данных и с какой стартовать;
- актуальные версии инструментов на август 2026 года — Python 3.14.7, pandas 3.0.5, scikit-learn 1.9.0;
- сравнительная таблица библиотек — какая для чего;
- сквозной пример в pandas — от загрузки таблицы до сводки по группам;
- семь шагов от скрипта до готового приложения.
Какие задачи решает анализ данных на Python
Перед тем как писать код, определитесь с типом задачи — от него зависит набор инструментов:
- Исследовательский анализ данных (EDA) — осмотреть незнакомый набор данных: распределения, выбросы, пропуски, связи между столбцами.
- Прогнозирование — предсказать число: выручку следующего месяца, цену квартиры, загрузку склада.
- Классификация — отнести объект к категории: уйдёт клиент или останется, спам или обычное письмо.
- Кластеризация — сгруппировать похожие объекты без готовых меток, например сегментировать покупателей по поведению.
- Визуализация данных — превратить таблицу в график, который читается в отчёте и на слайде.
Первые проекты обычно начинаются с EDA и визуализации: для них хватает pandas и Matplotlib. Машинное обучение подключается позже, когда появляется задача на прогноз.
Установка Python и окружения для анализа данных
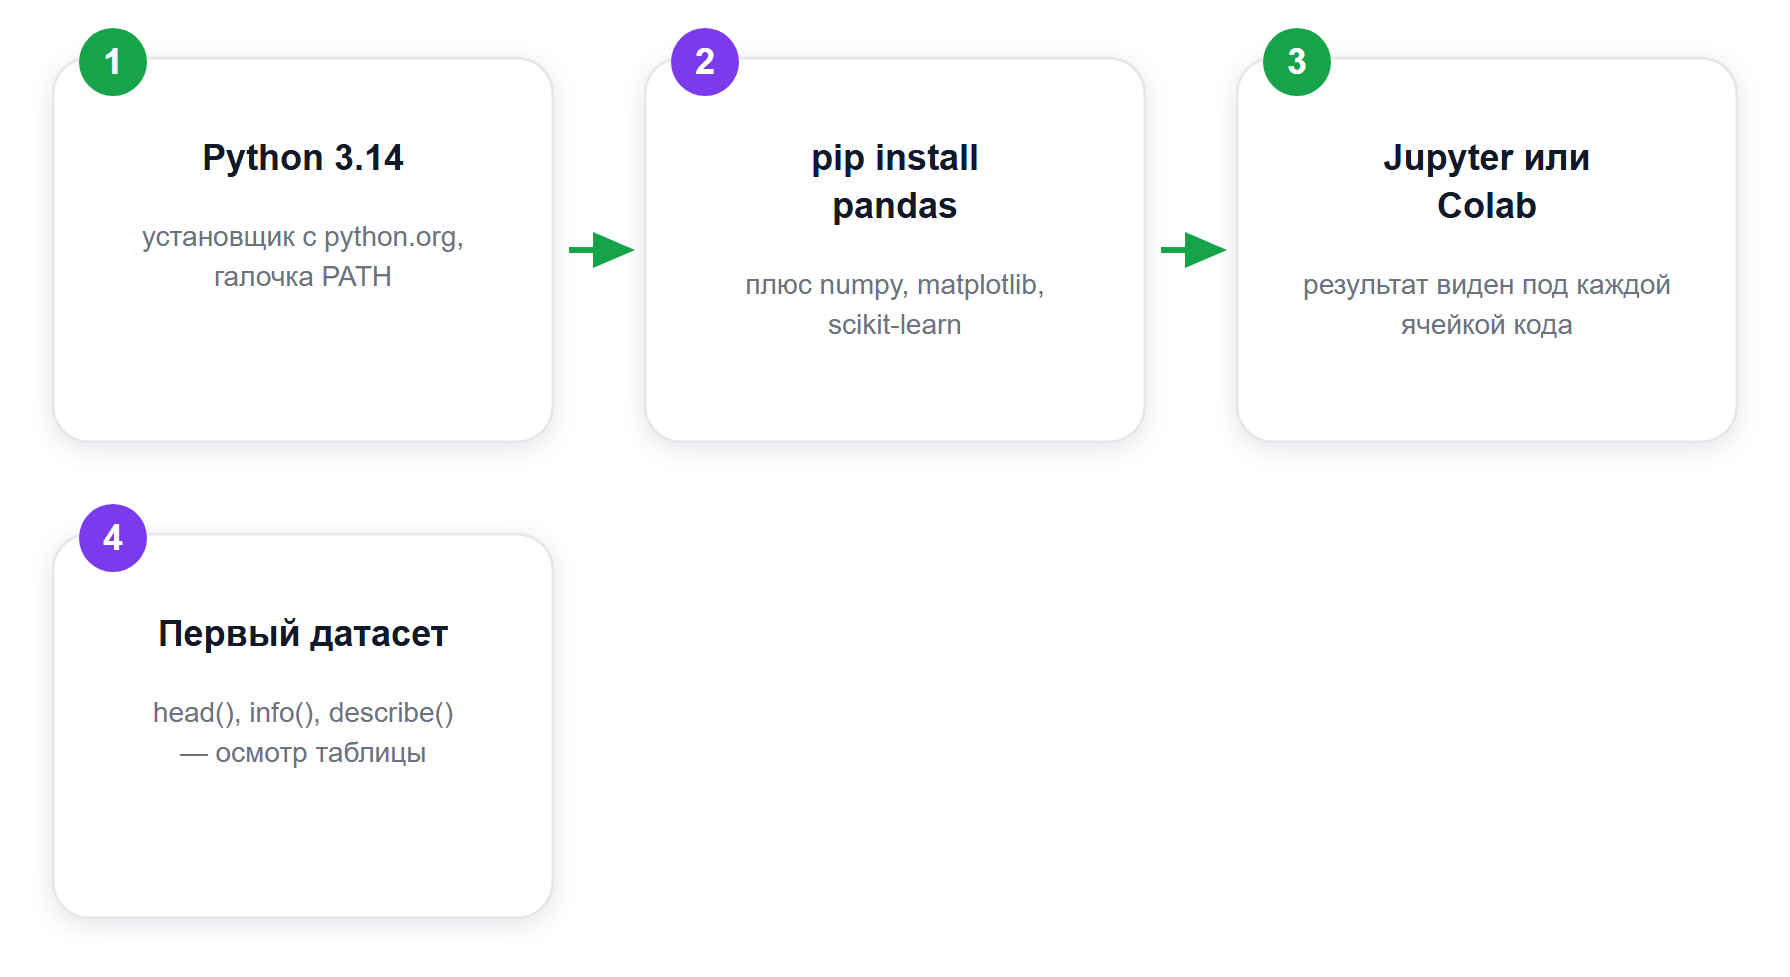
Актуальная версия языка на август 2026 года — Python 3.14.7, релиз от 5 августа 2026-го. Скачайте установщик с официального сайта и при установке отметьте добавление Python в PATH — иначе команды из терминала его не увидят.
Библиотеки ставятся менеджером пакетов pip. Команда из официальной документации pandas:
pip install pandasТем же способом ставятся numpy, matplotlib, seaborn и scikit-learn. Документация pandas называет самым простым путём для новичков дистрибутив Anaconda: он сразу включает pandas, SciPy, NumPy и Matplotlib. Там же есть оговорка: сборка pandas внутри Anaconda не сопровождается командой разработчиков pandas.
Писать аналитический код удобнее в интерактивной среде. Jupyter Notebook показывает результат каждого шага сразу под ячейкой с кодом. Облачный Google Colab работает в браузере, без установки на компьютер — подходящий вариант для первой недели занятий. Если Python для вас первый язык, параллельно закройте базовый синтаксис: переменные, списки, циклы, функции. Как выстроить этот маршрут, разобрано в материале «Путь от новичка до разработчика на языке программирования Python».
Библиотеки Python для анализа данных
Ядро экосистемы — pandas. Официальный сайт описывает её как быстрый, мощный, гибкий и простой в использовании инструмент анализа и обработки данных с открытым кодом; текущая версия — 3.0.5 от 22 июля 2026 года. Остальные библиотеки распределяются по этапам работы:
| Библиотека | Что делает | Когда брать |
|---|---|---|
| pandas 3.0.5 | Таблицы (DataFrame): загрузка CSV, Excel, SQL, очистка, группировка, сводные | Первой — почти любой анализ начинается с неё |
| NumPy | Операции над числовыми массивами и матрицами | Когда нужны векторные вычисления и математика вне таблиц |
| Matplotlib | Графики: линии, гистограммы, диаграммы рассеяния | Базовая визуализация результатов |
| Seaborn | Статистические графики поверх Matplotlib, готовые стили | Когда нужен аккуратный график в пару строк кода |
| scikit-learn 1.9.0 | Машинное обучение: регрессия, классификация, кластеризация | Когда от описания данных переходите к прогнозам |
По данным scikit-learn.org, библиотека построена на NumPy, SciPy и Matplotlib и закрывает шесть классов задач: классификацию, регрессию, кластеризацию, снижение размерности, подбор моделей и предобработку данных. Версия 1.9.0 вышла в июне 2026 года.
Стек складывается так: pandas готовит данные, NumPy считает, Matplotlib и Seaborn показывают, scikit-learn прогнозирует. Похожим набором пользуются и в науке — история перехода из исследований в разработку есть в материале «Из научного мира во вселенную разработки на языке программирования Python».
Анализ данных в pandas: сквозной пример
Разберём типовой цикл на маленьком наборе данных о продажах — код можно запустить как есть, ничего скачивать не нужно. В реальном проекте вместо словаря будет файл: pd.read_csv('data.csv') для CSV или pd.read_excel() для таблиц Excel.
Шаг 1. Загрузка и первый осмотр
import pandas as pd

data = {
    "город": ["Москва", "Казань", "Тверь", "Москва", "Казань", "Тверь"],
    "месяц": ["июнь", "июнь", "июнь", "июль", "июль", "июль"],
    "выручка": [1200, 640, None, 1350, 700, 210],
}
df = pd.DataFrame(data)

print(df.head())   # первые строки таблицы
print(df.info())   # типы столбцов и пропуски
print(df.describe())  # среднее, минимум, максимум по числам
Три команды осмотра — head(), info(), describe() — отвечают на первые вопросы аналитика: что за столбцы, какие типы, где пропуски, в каких границах лежат числа.
Шаг 2. Очистка данных
В столбце «выручка» один пропуск — info() покажет 5 непустых значений из 6. Варианта два: удалить строку или заполнить значением.
# удалить строки с пропусками
df_clean = df.dropna()

# или заполнить пропуск нулём
df["выручка"] = df["выручка"].fillna(0)

# убрать дубликаты, если есть
df = df.drop_duplicates()
Выбор зависит от задачи: для суммы выручки пропуск логично считать нулём, для среднего чека — удалить, чтобы не искажать результат.
Шаг 3. Группировка и сводка
# суммарная выручка по городам, по убыванию
itogi = df.groupby("город")["выручка"].sum().sort_values(ascending=False)
print(itogi)
Метод groupby() — рабочая лошадка анализа: одна строка кода заменяет сводную таблицу Excel. Тем же способом считаются среднее (mean()), количество (count()), минимум и максимум по любой группе.
Шаг 4. Фильтрация
# строки, где выручка выше 500
krupnye = df[df["выручка"] > 500]

# фильтр по двум условиям
moskva_iyul = df[(df["город"] == "Москва") & (df["месяц"] == "июль")]
print(moskva_iyul)
Условие в квадратных скобках возвращает новую таблицу — исходная не меняется. Так строятся любые срезы: по датам, регионам, сегментам клиентов.
Шаг 5. Сохранение результата
itogi.to_csv("itogi_po_gorodam.csv")
На этих пяти шагах — загрузка, осмотр, очистка, группировка, срезы — стоит весь ежедневный анализ данных: меняются только объёмы и источники, логика остаётся той же.
Визуализация данных в Matplotlib
График в Matplotlib собирается из тех же данных, что мы подготовили выше. Пример с подписями осей и заголовком — без них диаграмма в отчёте не читается:
import matplotlib.pyplot as plt

goroda = itogi.index          # названия городов из сводки
vyruchka = itogi.values      # суммы по городам

plt.bar(goroda, vyruchka)
plt.title("Выручка по городам за июнь–июль")
plt.xlabel("Город")
plt.ylabel("Выручка, тыс. руб.")
plt.grid(axis="y")
plt.show()
Столбчатая диаграмма (bar) подходит для сравнения категорий, линейный график (plot) — для динамики во времени, гистограмма (hist) — для распределений, диаграмма рассеяния (scatter) — для связи двух величин. У pandas есть и короткий путь: метод df.plot() строит график прямо из таблицы, используя Matplotlib под капотом.
Seaborn берёт те же данные и добавляет статистические типы графиков с готовым оформлением: тепловые карты корреляций, ящики с усами, парные распределения. Начинать лучше с Matplotlib — освоив его, вы будете понимать, что Seaborn делает за вас.
Машинное обучение в анализе данных
Когда описательной статистики мало и нужен прогноз, подключается scikit-learn. Минимальный работающий пример — линейная регрессия на условных данных о стаже и зарплате:
from sklearn.linear_model import LinearRegression

X = [[1], [2], [3], [4], [5]]   # стаж, лет
y = [35, 42, 50, 58, 65]        # зарплата, тыс. руб. (условные числа)

model = LinearRegression()
model.fit(X, y)                 # обучение на имеющихся данных

print(model.predict([[6]]))     # прогноз для стажа 6 лет
Схема одинакова для любой модели scikit-learn: создать модель, обучить методом fit() на известных данных, получить прогноз методом predict() на новых. Меняется только класс модели — вместо LinearRegression подставляется дерево решений, случайный лес или логистическая регрессия для задач классификации.
В реальном проекте перед обучением данные делят на обучающую и проверочную части, а качество модели меряют на той части, которую модель не видела. Инструменты для этого — разбиение выборки и метрики качества — входят в scikit-learn из коробки, в блок подбора моделей.
Как собрать приложение для анализа данных
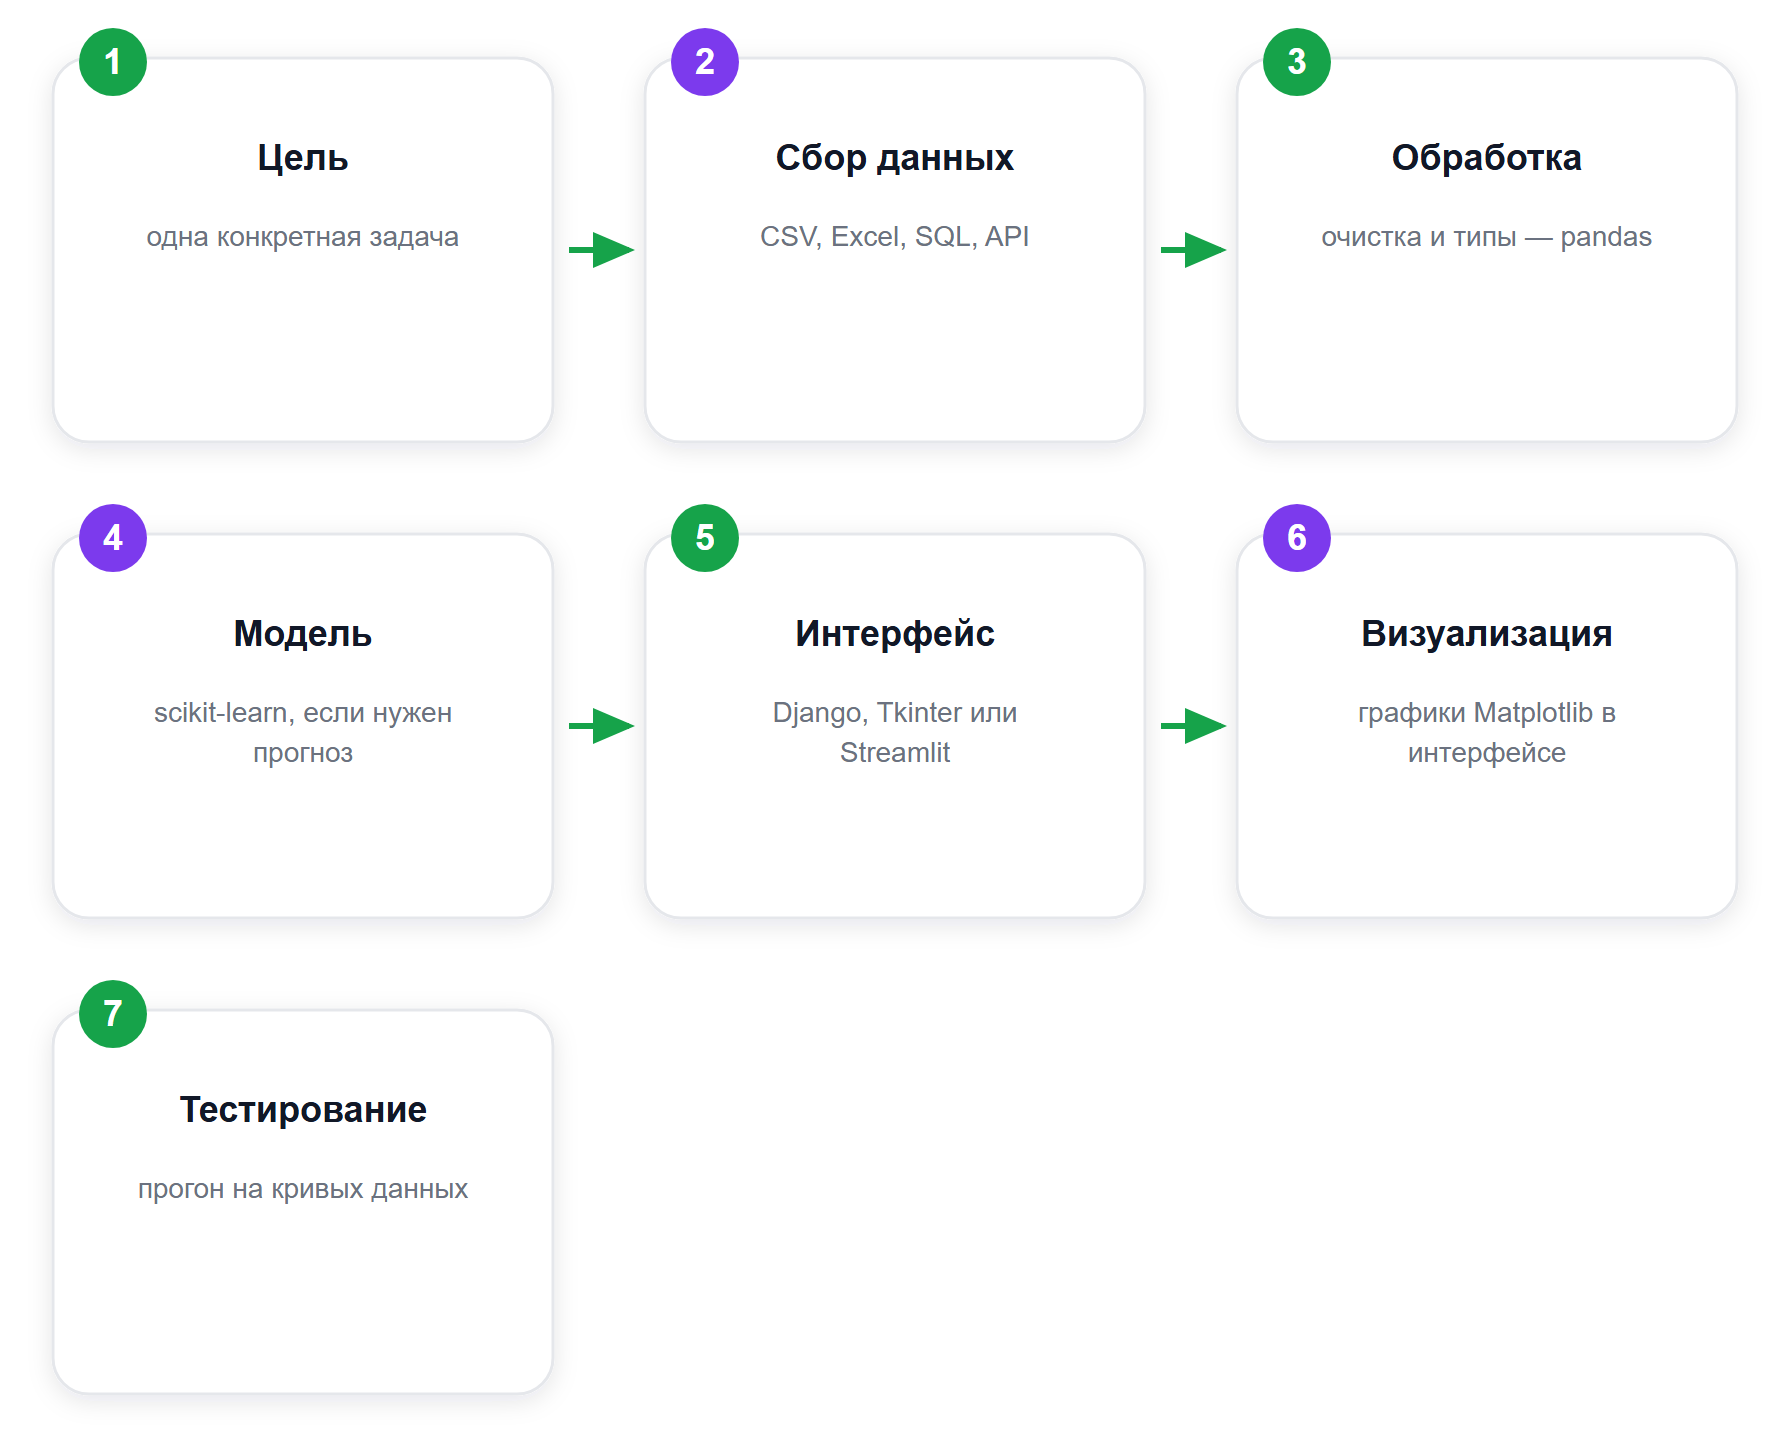
Скрипт в ноутбуке решает задачу один раз. Приложение делает анализ повторяемым: коллега загружает свой файл и получает готовую сводку без единой строки кода. Путь от скрипта к приложению состоит из семи шагов.
- Цель приложения. Одна конкретная задача: например, прогноз цен на недвижимость по историческим данным или еженедельная сводка продаж из выгрузки CRM.
- Сбор данных. Файлы CSV и Excel, выгрузки из баз через SQL, данные по API. pandas читает все эти источники штатными методами.
- Обработка. Очистка пропусков и дубликатов, приведение типов, расчётные столбцы — та же логика, что в сквозном примере выше.
- Модель. Если приложение прогнозирует — обучите модель scikit-learn и сохраните её; если только считает и показывает — этот шаг пропускается.
- Интерфейс. Для веб-приложения подойдёт фреймворк Django, для настольного — Tkinter из стандартной библиотеки Python. Для дашбордов и внутренних инструментов аналитики часто берут Streamlit — веб-интерфейс собирается из обычного Python-скрипта.
- Визуализация результата. Графики Matplotlib или Seaborn встраиваются в интерфейс — вывод цифр без картинки читается хуже.
- Тестирование. Прогоните приложение на разных наборах данных, включая кривые: пустые файлы, лишние столбцы, битые значения. Именно на них падают первые версии.
Такое приложение — рабочий портфолио-проект и способ автоматизировать собственную рутину. Как из похожей задачи вырос внутренний продукт, разобрано в кейсе «Как руководитель проектов разработал ИИ-инструмент для анализа переписок и снизил потери задач в команде на 30%».
Вопросы про анализ данных на Python
С чего начать анализ данных на Python новичку?
Поставьте Python с официального сайта, установите pandas командой pip install pandas и откройте Jupyter Notebook или Google Colab. Первое упражнение — загрузить таблицу, осмотреть её методами head() и info(), посчитать сумму по группам через groupby(). Базовый синтаксис Python — переменные, списки, циклы, функции — осваивается параллельно.
Какие библиотеки Python нужны для анализа данных в первую очередь?
pandas для работы с таблицами, NumPy для вычислений, Matplotlib для графиков. Этой тройки хватает на большинство учебных и рабочих задач. scikit-learn подключается, когда доходит до прогнозов и машинного обучения, Seaborn — когда нужны статистические графики с готовым оформлением.
Можно ли заниматься анализом данных на Python без опыта программирования?
Да. Синтаксис Python читается почти как английский текст, а типовой анализ таблицы укладывается в 10–20 строк кода. Стартовать проще в Google Colab: среда работает в браузере, устанавливать ничего не нужно. Сложные конструкции языка на первых порах не понадобятся.
Чем pandas отличается от Excel в анализе данных?
В pandas каждый шаг записан кодом: расчёт повторяется на новых данных одной командой, а ошибка ищется по конкретной строке скрипта. pandas работает с таблицами в миллионы строк и соединяет данные из разных источников — CSV, Excel, SQL-баз — в одном скрипте. Excel остаётся удобнее для быстрого ручного просмотра небольших таблиц.
Заключение
Анализ данных на Python сводится к повторяемому циклу: загрузить таблицу в pandas, очистить, сгруппировать, показать на графике Matplotlib, при необходимости — обучить модель scikit-learn. Каждый шаг цикла из этой статьи запускается на актуальных версиях августа 2026 года. Следующий уровень — обернуть цикл в приложение, которым пользуются коллеги без кода.