Содержание
- Замер: что лежит в PyPI по 19 библиотекам
- Фреймворк и библиотека: в чём разница
- Семь фреймворков и библиотек с ИИ, которые обновлялись в 2026 году
- Три инструмента из старых подборок: PyBrain, CNTK, Caffe
- Библиотеки машинного обучения для таблиц: scikit-learn и бустинги
- Библиотеки для обучения нейросетей
- Библиотеки для ИИ: работа с языковыми моделями
- Фреймворки Python: веб-разработка рядом с машинным обучением
- Как выбрать библиотеку под задачу
- Имена-двойники в PyPI: что приедет по неверному имени
- Частые вопросы
Топ-10 полезных ИИ-фреймворков и библиотек для Python

Черновик готовит редакция с помощью ИИ. За стандарт издания отвечает главный редактор — Валерий Курземнек.
Библиотеки для машинного обучения на Python держатся на четырёх именах: scikit-learn закрывает классические алгоритмы на таблицах, PyTorch и TensorFlow обучают нейросети, Keras работает надстройкой над ними. Рядом стоят три библиотеки градиентного бустинга — XGBoost, LightGBM, CatBoost. Для языковых моделей берут Transformers и LangChain.
Коротко, что дальше в статье:
- таблица со свежими версиями 19 пакетов: мы опросили PyPI и GitHub 16 сентября 2026 года и записали, что там лежит на самом деле;
- разница между фреймворком и библиотекой на примере Django и TensorFlow;
- семь инструментов с ИИ, которые обновлялись в 2026 году, и три из старых подборок, которые остановились;
- отдельные разборы под задачи: таблицы, нейросети, языковые модели, веб-фреймворки;
- таблица выбора «задача → инструмент» и ответы на частые вопросы.
Замер: что лежит в PyPI по 19 библиотекам
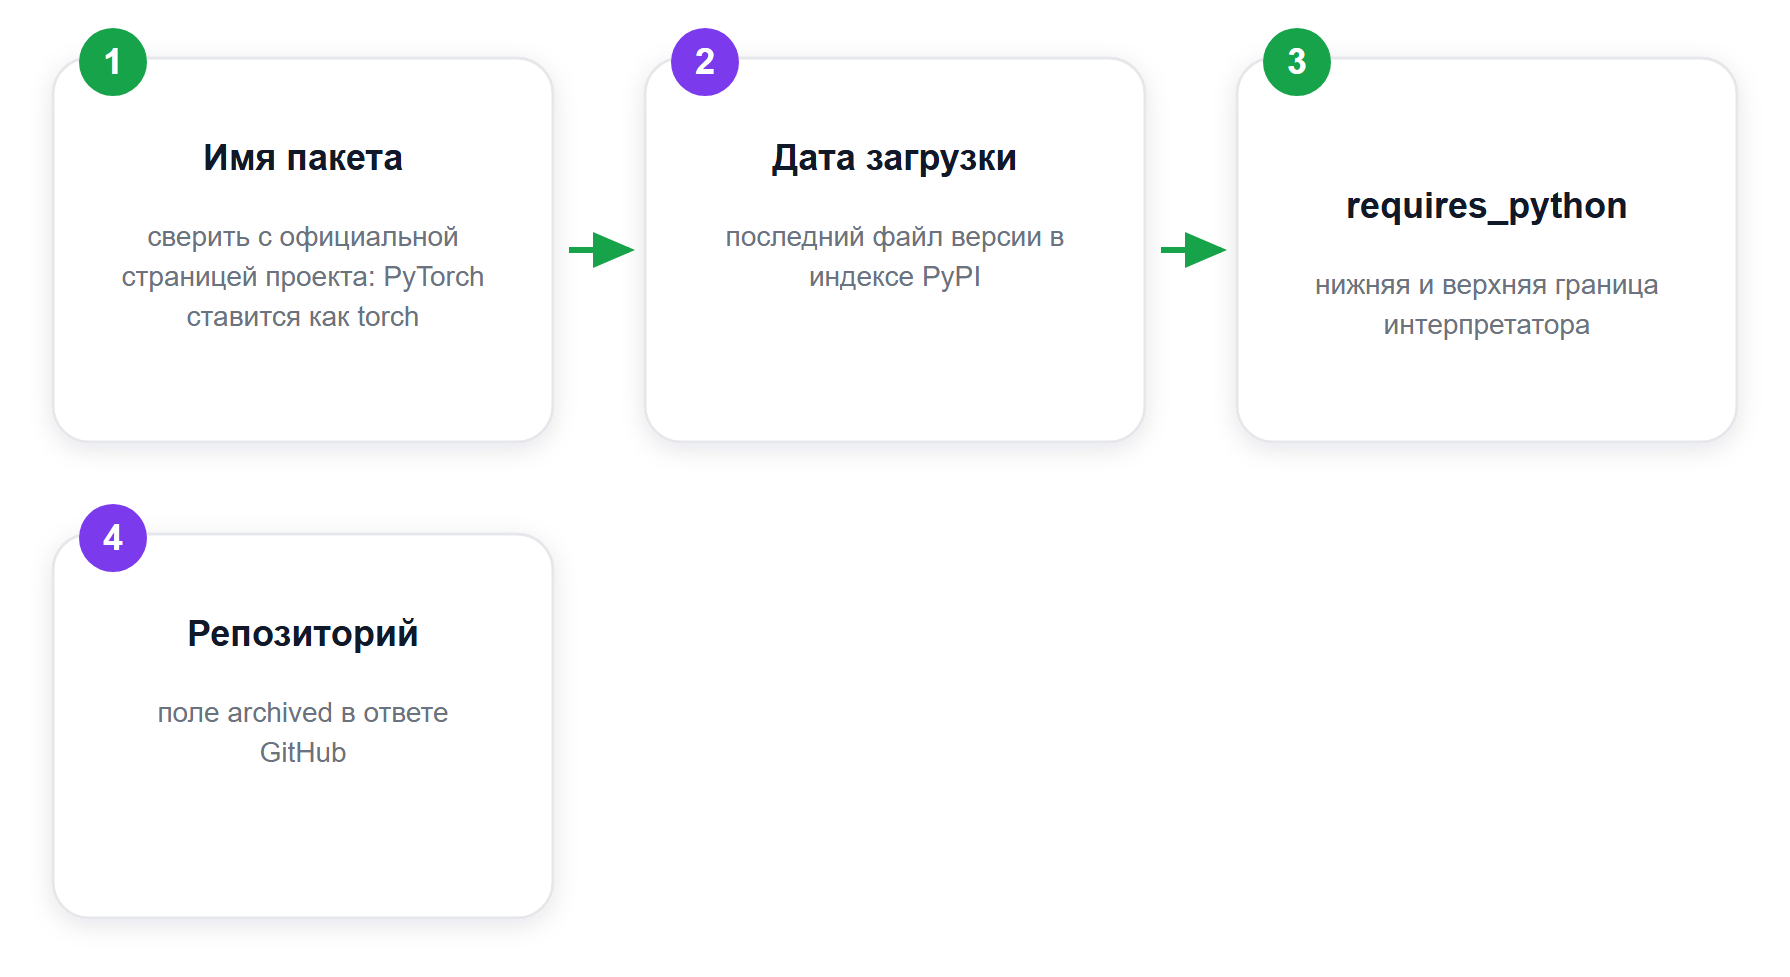
16 сентября 2026 года мы опросили два открытых источника: JSON-API индекса пакетов PyPI (адреса вида pypi.org/pypi/имя-пакета/json) и REST-API GitHub (api.github.com/repos/владелец/репозиторий). 19 пакетов, по два адреса на каждый, плюс 3 имени-двойника из отдельной таблицы ниже — всего 41 запрос. Из ответа PyPI брали три поля — info.version, дату загрузки файлов этой версии и requires_python; из ответа GitHub — поле archived. Одна линейка на все строки: каждому пакету задавали одни и те же вопросы.
Чего замер не обещает: машина, с которой шли запросы, выходит в сеть через шведский адрес, поэтому доступность PyPI и GitHub из России этим прогоном не проверялась. Проверялось только содержимое ответов.
| Библиотека | Пакет в PyPI | Версия в индексе | Дата загрузки файлов этой версии | Требование к Python (requires_python) | Репозиторий на GitHub заархивирован |
|---|---|---|---|---|---|
| TensorFlow | tensorflow | 2.21.0 | 6 марта 2026 года | >=3.10 | нет |
| PyTorch | torch | 2.14.0 | 2 сентября 2026 года | >=3.10 | нет |
| Keras | keras | 3.15.1 | 29 июля 2026 года | >=3.11 | нет |
| scikit-learn | scikit-learn | 1.9.1 | 10 сентября 2026 года | >=3.11 | нет |
| XGBoost | xgboost | 3.4.1 | 15 августа 2026 года | >=3.12 | нет |
| LightGBM | lightgbm | 4.7.0 | 18 июля 2026 года | >=3.10 | нет |
| CatBoost | catboost | 1.2.10 | 18 февраля 2026 года | требование не указано | нет |
| JAX | jax | 0.11.1 | 17 августа 2026 года | >=3.12 | нет |
| Transformers | transformers | 5.17.0 | 9 сентября 2026 года | >=3.10.0 | нет |
| LangChain | langchain | 1.4.0 | 3 сентября 2026 года | <4.0.0,>=3.10.0 | нет |
| NumPy | numpy | 2.5.3 | 6 сентября 2026 года | >=3.12 | нет |
| pandas | pandas | 3.0.5 | 22 июля 2026 года | >=3.11 | нет |
| Django | django | 6.1.1 | 2 сентября 2026 года | >=3.12 | нет |
| Flask | flask | 3.1.3 | 19 февраля 2026 года | >=3.9 | нет |
| FastAPI | fastapi | 0.141.1 | 29 июля 2026 года | >=3.10 | нет |
| Theano | theano | 1.0.5 | 27 июля 2020 года | требование не указано | нет |
| PyBrain | pybrain | 0.3.3 | файлов у этой версии нет | требование не указано | нет |
| CNTK | cntk | 2.7.post2 | 9 декабря 2020 года | требование не указано | да |
| Caffe | caffe | 0.1.0 | 10 ноября 2024 года | >=3.0 | нет |
Релиз в 2026 году получили 15 пакетов из 19. До 2021 года последний раз обновляли 3 пакета. Три строки таблицы заслуживают отдельного абзаца, потому что по ним старые подборки дают советы, которые больше не работают.
Caffe. Пакета фреймворка на PyPI под именем caffe нет. По этому адресу лежит пакет-заглушка с описанием: «This package is an example of a Dependency Hallucination. There is no code in this package, it is just a placeholder to prevent exploitation». В переводе — заглушка, которая занимает имя, чтобы его не занял кто-то другой. Официальная инструкция по установке Caffe описывает сборку из исходников командами make all, make test, make runtest и называет поддерживаемые системы: «We install and run Caffe on Ubuntu 16.04–12.04, OS X 10.11–10.8, and through Docker and AWS».
PyBrain. В индексе числится версия 0.3.3, файлов у неё ноль. Отдельно, уже для одного этого пакета, мы выполнили команду pip download pybrain —no-deps и получили строку «Downloading PyBrain-0.3.tar.gz (262 kB)» — то есть архив версии 0.3, загруженный на PyPI 18 ноября 2009 года.
CNTK. Последняя загрузка на PyPI — 9 декабря 2020 года. В файле README репозитория microsoft/CNTK в разделе Disclaimer написано: «Today’s 2.7 release will be the last main release of CNTK». Репозиторий заархивирован — поле archived в ответе GitHub равно true.
Фреймворк и библиотека: в чём разница
Оба слова в подборках по машинному обучению стоят рядом, и разводить их стоит один раз:
- фреймворк (framework) — набор пакетов или модулей, который позволяет разработчикам писать приложения без необходимости обрабатывать такие низкоуровневые детали, как протоколы, сокеты или управление процессами. Фреймворк — это, например, Django, на котором можно создавать высокофункциональные веб-приложения с минимумом усилий. Django ориентирован на автоматизацию и следование принципу DRY (Don’t Repeat Yourself — «не повторяться»);
- библиотека (library) — это коллекция связанных модулей. Она содержит наборы кода, которые могут быть использованы многократно в различных программах. Библиотеки особенно популярны в таких областях, как машинное обучение, наука о данных и визуализация данных. Библиотека — это, например, TensorFlow. Она используется для проведения вычислений.
Практическая разница простая: код фреймворка вызывает ваш код, ваш код вызывает библиотеку. Django сам решает, когда вызвать вашу функцию-обработчик запроса. Scikit-learn ждёт, пока вы вызовете fit и predict.
В машинном обучении граница размыта сильнее, чем в вебе. PyTorch зовут и библиотекой, и фреймворком: сам он про вычисления на тензорах, но вокруг него выросла экосистема обучения моделей, где расписание шагов задаёт уже он. Для выбора инструмента ярлык роли не играет — важнее задача, версия Python и то, обновляется ли проект. Дальше разбираем инструменты по задачам, а таблица выше отвечает на вопрос про обновления.
Семь фреймворков и библиотек с ИИ, которые обновлялись в 2026 году
TensorFlow

TensorFlow — библиотека с открытым исходным кодом, разработанная Google и предназначенная для построения и обучения нейросетей. Она заточена на то, чтобы практически всё делать автоматически, в том числе отыскивать и классифицировать объекты. У TensorFlow активное сообщество, подробная документация и много видеоуроков. В индексе PyPI версия 2.21.0 от 6 марта 2026 года, требование к интерпретатору — >=3.10. Рядом в индексе лежит пакет tensorflow-gpu, и его описание отправляет ставить основной пакет — разбор в таблице имён-двойников ниже.
PyTorch
PyTorch — вторая опора глубокого обучения на Python. Отличительная черта — динамический вычислительный граф: структура сети собирается по ходу выполнения кода, поэтому отладка идёт обычными средствами Python. На PyTorch делают прототипы и исследования, на нём же обучают модели в продакшене. В PyPI пакет называется torch, версия 2.14.0 от 2 сентября 2026 года, требование к интерпретатору — >=3.10.
LangChain

LangChain — фреймворк для приложений поверх больших языковых моделей. Он даёт единый интерфейс к моделям разных поставщиков, память диалога, работу с внешними источниками данных и вызов инструментов. Версия в PyPI — 1.4.0 от 3 сентября 2026 года. В требовании к интерпретатору у LangChain записана и верхняя граница — <4.0.0,>=3.10.0; у остальных шести инструментов этого раздела верхней границы в метаданных нет.

- ПОКАЖЕМ, КАК РАЗВЕРНУТЬ МОДЕЛЬ нейросети DEEPSEEK R1 ПРЯМО НА СВОЁМ КОМПЬЮТЕРЕ
- Где и как применять? Потестируем модель после установки на разных задачах
- Как дообучить модель под себя?
Hugging Face

Компания Hugging Face делает инструменты искусственного интеллекта, самый известный из них — библиотека Transformers. Она помогает в решении задач обработки языка, работы со звуком и изображениями: модель скачивается из общего хаба и запускается несколькими строками кода. Версия в PyPI — 5.17.0 от 9 сентября 2026 года. Старые подборки пишут, что «Трансформеры» работают поверх Jax, PyTorch и TensorFlow; описание текущего пакета на PyPI называет одну связку: «Transformers works with Python 3.10+, and PyTorch 2.5+», и команда установки там же — pip install «transformers[torch]». Что даёт бесплатный аккаунт и как устроен хаб, разбирали в статье «Hugging Face: что это и что даёт бесплатный аккаунт».
Keras
Keras — открытая библиотека машинного обучения, высокоуровневый API поверх вычислительных бэкендов. Слой, сеть и обучение описываются несколькими строками, поэтому Keras берут для быстрых прототипов и для первых учебных моделей. Версия в PyPI — 3.15.1 от 29 июля 2026 года, требование к интерпретатору — >=3.11. Связку Keras с TensorFlow на практическом примере разбирали в статье «Искусственный интеллект на Python с использованием TensorFlow и Keras».
Scikit-Learn

Scikit-learn — основная библиотека Python для классического машинного обучения. Регрессия, классификация, кластеризация, отбор признаков, разбиение выборки и метрики качества собраны в одном интерфейсе: у каждой модели есть методы fit и predict, поэтому алгоритмы меняются местами одной строкой. Документация подробная, поэтому библиотека дружественна к новичкам. Версия в PyPI — 1.9.1 от 10 сентября 2026 года, требование к интерпретатору — >=3.11. Устанавливать нужно пакет scikit-learn; про пакет с именем sklearn написано в таблице двойников ниже.
XGBoost
XGBoost — библиотека градиентного бустинга на деревьях решений с открытым исходным кодом. Её берут для задач классификации и регрессии на структурированных данных: таблицы из базы, выгрузки CRM, логи. Библиотека поддерживает несколько языков программирования, включая Python, и обучает модели на GPU. Версия в PyPI — 3.4.1 от 15 августа 2026 года, требование к интерпретатору — >=3.12: это самая высокая нижняя граница среди семи инструментов раздела, на Python 3.11 pip подберёт версию постарше.
Мини-вывод раздела: семь инструментов выше получили релиз в 2026 году, и по ним безопасно брать свежие руководства. Проверка занимает один запрос к PyPI, как в нашей таблице.
Три инструмента из старых подборок: PyBrain, CNTK, Caffe
Эти три имени продолжают кочевать по спискам «лучших библиотек машинного обучения для Python». Замер показывает, в каком они состоянии.
PyBrain
PyBrain — учебная библиотека машинного обучения с открытым исходным кодом, в описании пакета названа «the Swiss army knife for neural networking». Простая и гибкая среда для экспериментов с алгоритмами, из-за чего её и рекомендовали преподавателям и студентам. В индексе PyPI числится версия 0.3.3, файлов у этой версии ноль, последняя версия с файлами — 0.3 от 18 ноября 2009 года. Ограниченная документация и маленькое сообщество, о которых писали раньше, сегодня дополнены этой датой.
Microsoft Cognitive Toolkit (CNTK)
Microsoft Cognitive Toolkit, или CNTK, — бесплатный фреймворк глубокого обучения с открытым исходным кодом от Microsoft. Он поддерживал обучение на нескольких GPU и серверах, экспорт в ONNX и разные типы сетей, включая свёрточные и рекуррентные. Последняя загрузка пакета на PyPI — 9 декабря 2020 года, репозиторий заархивирован, в README стоит строка «Today’s 2.7 release will be the last main release of CNTK». Тем, кто нашёл CNTK в подборке, Microsoft в том же тексте советует ONNX и ONNX Runtime.
Caffe

Caffe — фреймворк глубокого обучения с открытым исходным кодом от Berkeley AI Research, сделанный в первую очередь под компьютерное зрение: обнаружение и классификацию объектов. В своё время он славился скоростью и лёгким развёртыванием. Сегодня установка идёт сборкой из исходников, а системы в официальной инструкции перечислены такие: «We install and run Caffe on Ubuntu 16.04–12.04, OS X 10.11–10.8, and through Docker and AWS». Про пакет с именем caffe в PyPI написано в разделе с замером выше.
Мини-вывод раздела: встретили в чужой подборке PyBrain, CNTK или Caffe — подборку писали по старым источникам, и остальные советы из неё стоит перепроверить.
Библиотеки машинного обучения для таблиц: scikit-learn и бустинги
Большая часть прикладных задач машинного обучения живёт на табличных данных: отток клиентов, скоринг заявки, спрос на складе, вероятность отклика. Рабочий набор под такие данные состоит из scikit-learn и трёх библиотек градиентного бустинга.
- scikit-learn (1.9.1) — базовый слой: подготовка признаков, разбиение выборки, линейные модели, деревья, случайный лес, метрики, кросс-валидация. С него начинают, им же измеряют качество моделей из остальных библиотек;
- XGBoost (3.4.1) — градиентный бустинг на деревьях, стандарт для соревнований и промышленных задач на структурированных данных;
- LightGBM (4.7.0 от 18 июля 2026 года) — бустинг от Microsoft с гистограммным разбиением признаков и ростом дерева по листьям. Его выбирают, когда данных много, а времени на обучение мало;
- CatBoost (1.2.10 от 18 февраля 2026 года) — бустинг от «Яндекса», который умеет работать с категориальными признаками напрямую, без ручного кодирования. Полезен на данных с текстовыми категориями вроде города, тарифа или канала привлечения.
Все четыре библиотеки говорят на одном интерфейсе fit и predict, поэтому заменяются друг на друга в готовом пайплайне почти без правок кода. Практический порядок работы такой: собрать базовое решение на scikit-learn, получить метрику, затем прогнать те же данные через бустинги и сравнить результат на одной и той же выборке.
Отдельная часть работы — качество самих данных: ошибки в разметке портят метрику любой модели, и ищут их отдельными инструментами. Как это делается, разбирали в статье «Как с помощью Cleanlab находить ошибки ИИ в MLflow».
Мини-вывод раздела: для таблиц хватает связки scikit-learn плюс один бустинг. Свежесть у всех трёх бустингов видна в таблице замера — релизы 2026 года, так что выбор здесь идёт по удобству работы с данными.
Библиотеки для обучения нейросетей
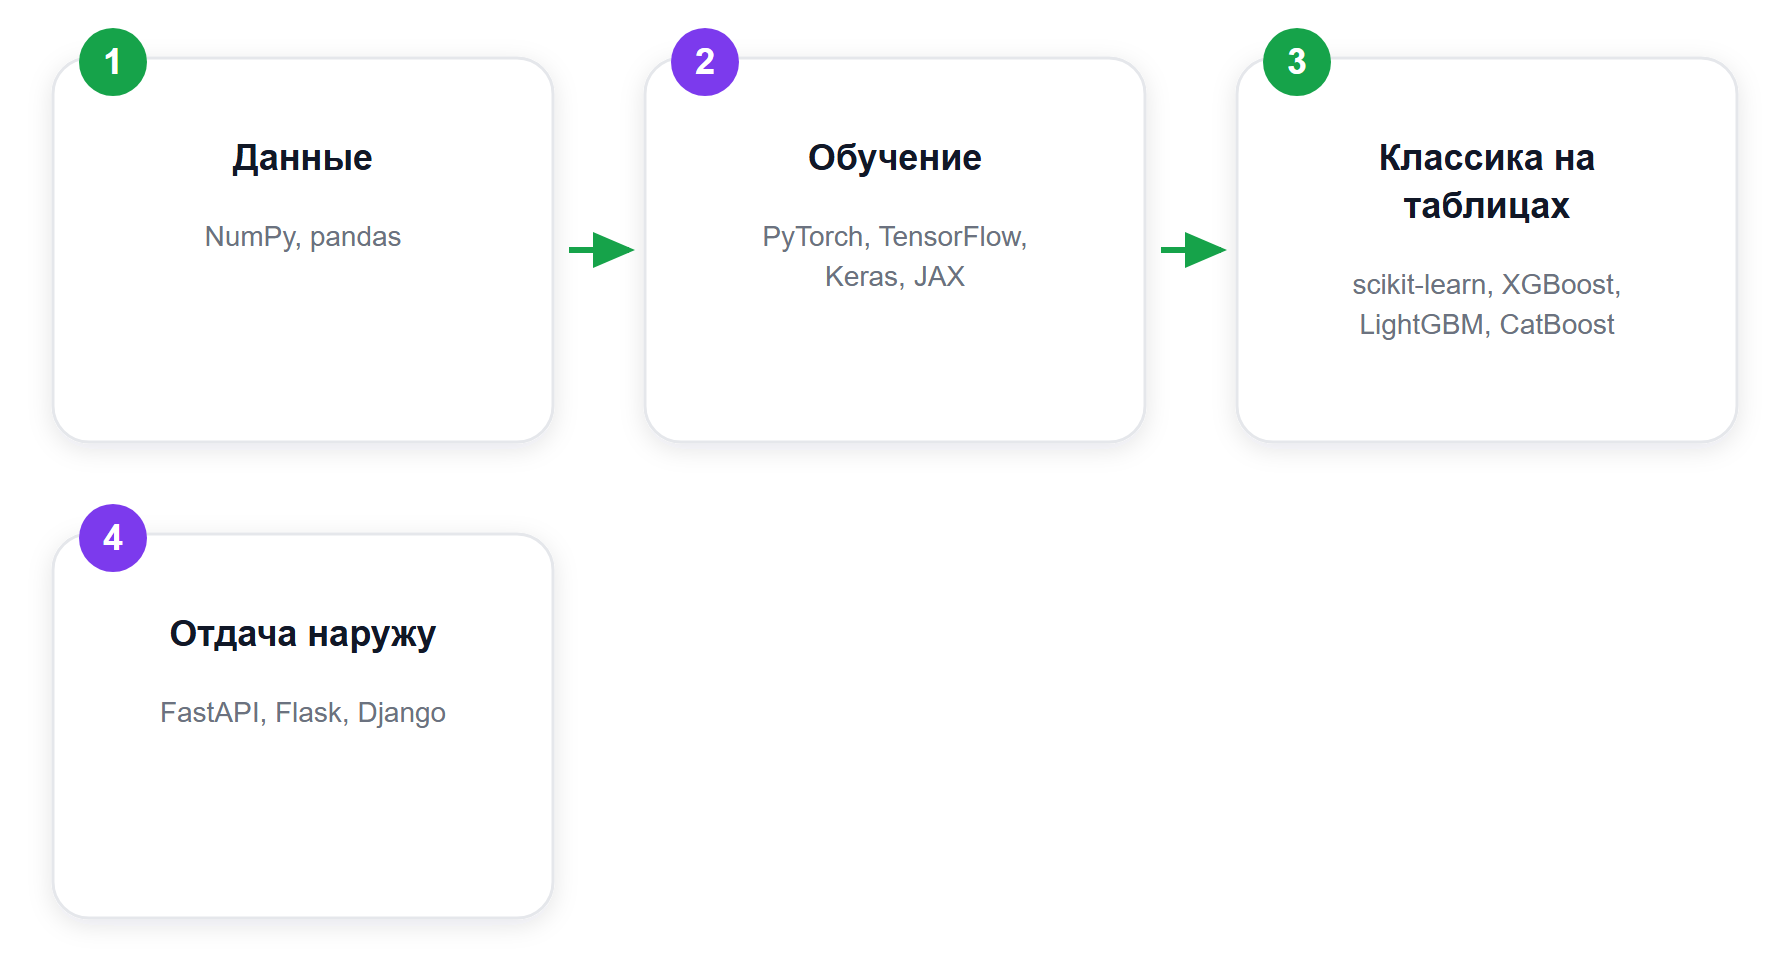
Для обучения нейросетей на Python используют четыре библиотеки: PyTorch, TensorFlow, Keras и JAX. Первые две — полноценные платформы с собственным вычислительным ядром и экспортом моделей. Keras описывает архитектуру поверх такого ядра. JAX (0.11.1 от 17 августа 2026 года) — библиотека от Google для вычислений с автоматическим дифференцированием и компиляцией под ускорители, её берут исследователи и команды, которым нужен контроль над каждым шагом обучения.
Библиотека — половина дела. Чтобы обучение шло на видеокарте, к ней нужен драйвер и совместимая сборка: у PyTorch и TensorFlow для этого выпускают отдельные сборки под разные версии CUDA, и подбирать их надо под свой драйвер. Поставили пакет без учёта драйвера — код запустится и будет считать на процессоре.
Что ещё понадобится рядом:
- NumPy (2.5.3) — массивы и линейная алгебра, на них опираются все перечисленные библиотеки;
- pandas (3.0.5) — загрузка и подготовка датасета перед обучением;
- готовые веса моделей — их обычно берут из хаба Hugging Face, чтобы не обучать сеть с нуля.
Порядок выбора простой. Учитесь или собираете прототип — начинайте с Keras поверх TensorFlow. Повторяете код из чужого исследовательского репозитория — посмотрите, на какой библиотеке он написан, и поставьте её же. Нужны собственные вычислительные схемы — смотрите в сторону JAX.
Мини-вывод раздела: все четыре библиотеки этого списка получили релиз в 2026 году, а нижняя граница интерпретатора у них разная — от 3.10 у PyTorch и TensorFlow до 3.12 у JAX. Разбор с рабочим примером сети собран в статье «Библиотеки Python для создания AI-моделей».
Библиотеки для ИИ: работа с языковыми моделями
Под запросом «библиотека ИИ» сегодня обычно ищут инструменты для работы с языковыми моделями. Их два основных: Transformers и LangChain.
Transformers (5.17.0 от 9 сентября 2026 года) даёт единый способ скачать готовую модель из хаба Hugging Face и запустить её локально: классификация текста, распознавание речи, генерация, эмбеддинги. Требования описаны на странице пакета так: «Transformers works with Python 3.10+, and PyTorch 2.5+». Эта библиотека закрывает сценарий «модель работает на моём железе, данные никуда не уходят».
LangChain (1.4.0 от 3 сентября 2026 года) решает соседнюю задачу: собрать приложение вокруг модели. Единый интерфейс к разным поставщикам, память диалога, подключение своих документов, вызов внешних инструментов по решению модели. Типовой сценарий — ответы по базе знаний компании, когда модель получает кусок нужного документа и отвечает по нему.
Граница между ними простая: Transformers отвечает за саму модель, LangChain — за обвязку вокруг неё. В одном проекте они спокойно живут вместе.
Python и большие языковые модели дополняют друг друга, и в прикладном смысле это сильно упрощает разработку.
Мини-вывод раздела: ставите одну библиотеку под ИИ — ставьте Transformers, потому что она даёт доступ к моделям. LangChain добавляется, когда вокруг модели появляется логика приложения. Термины этого слоя собраны в статье «15 терминов, которые нейросети скрывали от вас».
Фреймворки Python: веб-разработка рядом с машинным обучением
Слово «фреймворк» в мире Python чаще всего означает веб-фреймворк, и в подборках «фреймворки Python» соседствуют два разных семейства. Первое отвечает за сайты и API, второе — за обучение моделей.
Веб-часть выглядит так:
- Django (6.1.1 от 2 сентября 2026 года) — фреймворк «с батарейками»: ORM, админка, авторизация, миграции и шаблоны идут в комплекте. Подходит для больших проектов с базой данных и личными кабинетами;
- Flask (3.1.3 от 19 февраля 2026 года) — минималистичный фреймворк: маршрутизация и шаблоны, остальное подключается по необходимости. Им часто оборачивают модель в простой веб-сервис;
- FastAPI (0.141.1 от 29 июля 2026 года) — асинхронный фреймворк с проверкой типов и автоматической документацией API. Стал стандартным способом выставить обученную модель наружу как HTTP-сервис.
Машинное обучение живёт в другом семействе: PyTorch, TensorFlow, Keras, JAX. Их называют то библиотеками, то фреймворками, и по смыслу они ближе ко второму, потому что задают собственный цикл обучения и формат моделей.
Связка выглядит так: модель обучается в PyTorch или TensorFlow, сохраняется в файл, а FastAPI или Flask поднимают вокруг неё сервис, который принимает запрос и возвращает предсказание. Django берут, когда вокруг предсказания нужен полноценный продукт с пользователями, ролями и историей.
Мини-вывод раздела: у трёх веб-фреймворков выше требования к интерпретатору начинаются с 3.9, поэтому под современный стек разумно держать окружение на Python 3.12 и новее — тогда встанут и веб-часть, и все обновлявшиеся в 2026 году библиотеки из нашей таблицы.
Как выбрать библиотеку под задачу
Собрали выбор в одну таблицу. Колонка с версией берётся из того же замера, что и таблица выше.
| Задача | Что ставить | Версия в индексе PyPI | Почему |
|---|---|---|---|
| Классификация и регрессия на таблицах | scikit-learn | 1.9.1 | базовый набор моделей и метрик |
| Много строк, обучение нужно быстро | LightGBM | 4.7.0 | гистограммный бустинг |
| Категориальные признаки без ручного кодирования | CatBoost | 1.2.10 | обрабатывает категории напрямую |
| Максимум качества на структурированных данных | XGBoost | 3.4.1 | стандарт соревнований |
| Обучение нейросети с нуля | PyTorch + TensorFlow | 2.14.0 / 2.21.0 | полные платформы обучения |
| Быстрый прототип сети | Keras | 3.15.1 | архитектура в несколько строк |
| Готовая модель из хаба | Transformers | 5.17.0 | запуск моделей Hugging Face |
| Приложение вокруг языковой модели | LangChain | 1.4.0 | память, документы, инструменты |
| Подготовка и очистка данных | pandas + NumPy | 3.0.5 / 2.5.3 | таблицы и массивы |
| Свои вычислительные схемы и ускорители | JAX | 0.11.1 | автодифференцирование и компиляция |
| Выставить модель как HTTP-API | FastAPI | 0.141.1 | асинхронный сервис с документацией |
| Продукт с пользователями вокруг модели | Django | 6.1.1 | ORM, админка, авторизация |
Имена-двойники в PyPI: что приедет по неверному имени
Часть имён из старых статей в индексе занята пакетами-указателями. Мы задали PyPI тот же вопрос по именам sklearn, pytorch и tensorflow-gpu и выписали, что стоит в описании пакета: поле summary, а при пустом summary — первую строку поля description.
| Имя в PyPI | Версия | Что написано в описании пакета | Поле ответа |
|---|---|---|---|
| sklearn | 0.0.post12 | deprecated sklearn package, use scikit-learn instead | summary |
| pytorch | 1.0.2 | You tried to install «pytorch». The package named for PyTorch is «torch» | description |
| tensorflow-gpu | 2.12.0 | Removed: please install «tensorflow» instead. | summary |
Отсюда правило перед установкой: сверяйте имя пакета с официальной страницей проекта, читайте описание в выдаче PyPI и проверяйте дату последней загрузки.
Частые вопросы
С каких библиотек начать машинное обучение на Python
Начните с трёх: NumPy для массивов, pandas для подготовки данных и scikit-learn для самих моделей. Этой связки хватает для классификации, регрессии и кластеризации на табличных данных. Нейросетевые библиотеки подключают следующим шагом, когда задача выходит за пределы таблиц.
Чем библиотека отличается от фреймворка
Библиотека — коллекция модулей, которую вызывает ваш код: вы сами решаете, когда обратиться к scikit-learn. Фреймворк задаёт структуру приложения и вызывает ваш код сам: Django решает, когда запустить ваш обработчик запроса. В машинном обучении граница размыта, и PyTorch называют и библиотекой, и фреймворком.
Какие библиотеки нужны для обучения нейросетей
Основных четыре: PyTorch, TensorFlow, Keras как надстройка над вычислительным ядром и JAX для собственных вычислительных схем. К библиотеке понадобится драйвер видеокарты и сборка под подходящую версию CUDA, иначе обучение пойдёт на процессоре.
Какие библиотеки для ИИ ставить под языковые модели
Transformers для запуска готовых моделей из хаба Hugging Face и LangChain для приложения вокруг модели: памяти диалога, работы с документами и вызова инструментов. Обе библиотеки обновлялись в сентябре 2026 года.
Почему pip ставит по имени библиотеки пустой пакет
Имя в индексе PyPI и имя проекта совпадают не всегда. По имени caffe в PyPI лежит пакет-заглушка с описанием This package is an example of a Dependency Hallucination, а PyTorch ставится командой pip install torch: пакет с именем pytorch содержит описание You tried to install pytorch. The package named for PyTorch is torch. Перед установкой сверяйте имя пакета с официальной страницей проекта.
Какая версия Python нужна для машинного обучения
На 16 сентября 2026 года самая высокая нижняя граница среди обновлявшихся в 2026 году библиотек нашей таблицы — Python 3.12: такое требование записано в метаданных у 4 пакетов. Окружение на этой версии и новее подходит и для библиотек машинного обучения, и для веб-фреймворков.
Список библиотек стоит пересматривать раз в год: проверить дату последней загрузки на PyPI и статус репозитория. Обновлено 16 сентября 2026 года.